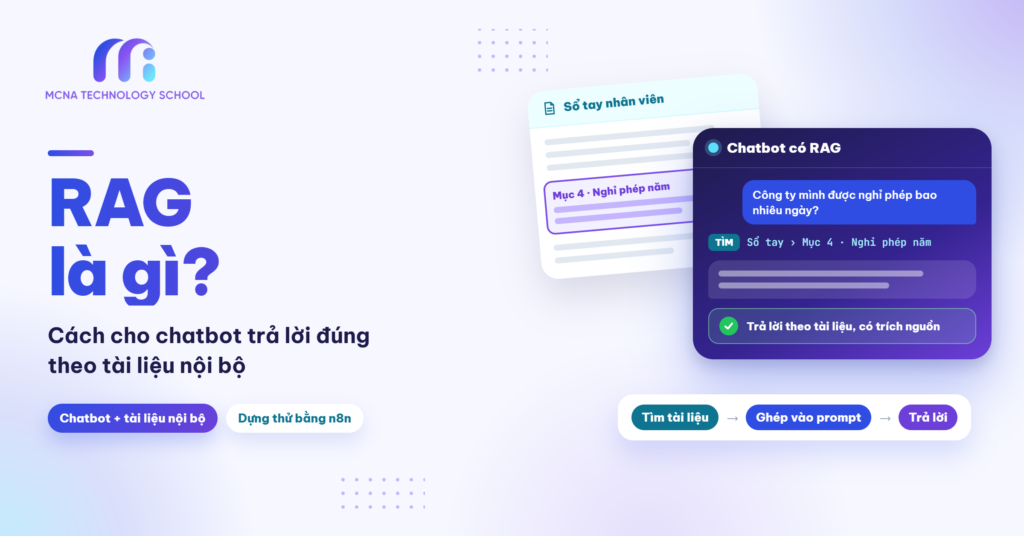
📚 CÙNG MỘT CÂU HỎI, HAI KIỂU CHATBOT
Nhân viên mới hỏi chatbot: “Công ty mình được nghỉ phép bao nhiêu ngày một năm?”. Chatbot trả lời rất tự tin: “12 ngày theo Bộ luật Lao động”. Nghe hợp lý, nhưng quy chế công ty bạn có thể cho nhiều hơn, kèm điều kiện riêng mà chatbot không hề biết. Nó chưa từng đọc sổ tay nhân viên của bạn.
RAG là kỹ thuật giải quyết đúng vấn đề này: trước khi trả lời, chatbot tìm đoạn tài liệu nội bộ liên quan rồi mới dựa vào đó để viết câu trả lời. Bài viết này giải thích RAG là gì bằng ngôn ngữ dễ hiểu, cách RAG hoạt động, khi nào dùng RAG thay vì fine-tuning, và cách dựng thử một chatbot RAG đơn giản bằng n8n.
📂 NỘI DUNG BÀI VIẾT
RAG là gì?
RAG (Retrieval-Augmented Generation, tạm dịch: tạo câu trả lời có tìm kiếm bổ trợ) là cách kết hợp hai bước:
R BƯỚC 1
Retrieval (Tìm kiếm)
tìm trong kho tài liệu của bạn những đoạn liên quan nhất đến câu hỏi.
AG BƯỚC 2
Augmented Generation (Tạo câu trả lời có bổ trợ)
đưa các đoạn đó vào prompt cùng câu hỏi, yêu cầu mô hình AI trả lời dựa trên nội dung này.
📖 Hãy hình dung hai kỳ thi. Chatbot thông thường giống một thí sinh thi đóng sách: chỉ trả lời bằng những gì đã học, không nhớ thì đoán. Chatbot có RAG giống thí sinh thi mở sách: được lật đúng trang tài liệu của công ty rồi mới viết câu trả lời.
RAG dùng để làm gì?
🏢 Chatbot nội bộ
trả lời câu hỏi về quy chế, quy trình, chính sách nhân sự.
🎧 Chatbot chăm sóc khách hàng
trả lời về sản phẩm, học phí, lịch học dựa trên tài liệu chính thức.
📊 Trợ lý cho Data Analyst
tra cứu từ điển dữ liệu, định nghĩa KPI, tài liệu mô tả bảng để viết SQL đúng ngữ cảnh công ty.
Điểm quan trọng: RAG không dạy lại mô hình AI. Nó chỉ đưa đúng tài liệu vào đúng lúc, nên khi tài liệu thay đổi, bạn chỉ cần cập nhật kho tài liệu.
Vì sao chatbot cần RAG?
3 giới hạn của chatbot thông thường
🔒 Không biết tài liệu riêng của bạn
mô hình AI được huấn luyện trên dữ liệu công khai, không có sổ tay nhân viên hay bảng giá nội bộ của công ty.
⏳ Kiến thức có hạn thời gian
mô hình chỉ biết thông tin đến một mốc nhất định, những thay đổi sau đó nó không nắm được.
🎭 Tự tin bịa khi không biết
thay vì nói “tôi không chắc”, chatbot thường tạo ra một câu trả lời nghe rất hợp lý nhưng sai.
RAG xử lý cả ba vấn đề vì chatbot luôn có tài liệu thật, mới nhất để bám vào, và có thể chỉ rõ câu trả lời lấy từ tài liệu nào.
RAG hay fine-tuning?
Fine-tuning là huấn luyện thêm mô hình trên dữ liệu của bạn. Nhiều người nghĩ đây là cách “dạy” AI kiến thức công ty, nhưng với bài toán hỏi đáp tài liệu, RAG thường là lựa chọn đầu tiên.
| Tiêu chí | 📖 RAG | 🧪 Fine-tuning |
|---|---|---|
| Cách làm | Tìm tài liệu rồi đưa vào prompt | Huấn luyện thêm mô hình |
| Cập nhật kiến thức | Thay tài liệu là xong | Phải huấn luyện lại |
| Trích nguồn | Dễ, biết rõ đoạn nào được dùng | Khó, kiến thức “lẫn” vào mô hình |
| Chi phí bắt đầu | Thấp, dựng được bằng công cụ low-code | Cao hơn, cần dữ liệu huấn luyện và kỹ thuật |
| Phù hợp | Hỏi đáp theo tài liệu, thông tin thay đổi thường xuyên | Dạy mô hình một phong cách viết hay định dạng cố định |
🧭 Nói gọn: muốn AI biết thêm thông tin thì dùng RAG, muốn AI cư xử theo một kiểu thì mới cân nhắc fine-tuning.
RAG hoạt động thế nào?
Một hệ thống RAG gồm hai giai đoạn: chuẩn bị tài liệu (làm một lần và cập nhật khi tài liệu thay đổi) và trả lời câu hỏi (chạy mỗi lần có người hỏi).
Giai đoạn 1: Chuẩn bị tài liệu
1 Thu thập:
gom tài liệu cần dùng như file PDF, Word, Google Docs, trang wiki nội bộ.
2 Chia nhỏ (chunking):
cắt mỗi tài liệu thành các đoạn ngắn, thường vài trăm đến khoảng một nghìn ký tự, để khi tìm chỉ lấy đúng phần cần thiết.
3 Tạo embedding:
dùng một mô hình embedding biến mỗi đoạn thành một dãy số (vector) thể hiện ý nghĩa của đoạn đó. Hai đoạn có ý nghĩa gần nhau sẽ có vector gần nhau.
4 Lưu vào vector database:
lưu vector cùng nội dung gốc và thông tin mô tả (tên tài liệu, phòng ban, ngày cập nhật).
Giai đoạn 2: Trả lời câu hỏi
1 Biến câu hỏi thành vector
bằng cùng mô hình embedding.
2 Tìm các đoạn gần nhất
trong vector database, thường lấy 3–5 đoạn.
3 Ghép vào prompt:
câu hỏi + các đoạn tìm được + hướng dẫn “chỉ trả lời dựa trên tài liệu dưới đây”.
4 Mô hình AI viết câu trả lời,
kèm tên tài liệu nguồn.
Vì sao tìm bằng vector mà không tìm từ khóa?
Tìm bằng vector là tìm theo ý nghĩa. Người dùng hỏi “nghỉ ốm có bị trừ lương không?” vẫn tìm ra đoạn quy chế viết “nghỉ hưởng bảo hiểm xã hội” dù hai câu không chung từ nào. Trong thực tế, nhiều hệ thống kết hợp cả hai cách để không bỏ sót mã sản phẩm, tên riêng hay số hiệu văn bản.
Dựng thử chatbot RAG bằng n8n
Với n8n, bạn có thể dựng một chatbot RAG đơn giản mà không cần viết code. Ví dụ dưới đây là chatbot hỏi đáp sổ tay nhân viên, gồm hai workflow tương ứng hai giai đoạn ở trên.
Workflow 1: Nạp tài liệu vào kho
⚙ WORKFLOW 1 · NẠP TÀI LIỆU
Trigger
chạy tay / file mới
Google Drive
tải file
Vector Store
Insert
- Trigger: chạy tay khi có tài liệu mới, hoặc tự chạy khi có file mới trong một thư mục Google Drive.
- Google Drive: tải file sổ tay nhân viên về.
- Vector Store (chế độ Insert): chọn một kho vector. Khi thử nghiệm có thể dùng Simple Vector Store lưu trong bộ nhớ của n8n. Khi dùng thật nên chuyển sang kho lưu lâu dài như Supabase, Qdrant hay Pinecone.
- Gắn kèm vào Vector Store: một node Data Loader để đọc nội dung file, một node Text Splitter để chia nhỏ, và một node Embeddings (ví dụ của OpenAI hay Google Gemini) để tạo vector.
Workflow 2: Chatbot trả lời câu hỏi
⚙ WORKFLOW 2 · CHATBOT
Chat Trigger
khung chat
AI Agent
mô hình chat
Vector Store
công cụ tra cứu
- Trigger: node Chat Trigger để có khung chat thử ngay trong n8n, hoặc Telegram Trigger nếu muốn chat qua Telegram.
- AI Agent: nối với một mô hình chat (Claude, GPT hoặc Gemini) và một công cụ Vector Store trỏ vào đúng kho đã nạp ở workflow 1, dùng cùng mô hình embedding.
- System message: viết hướng dẫn rõ ràng, ví dụ:
Thử hỏi vài câu trong khung chat và mở phần log của AI Agent để xem nó đã tìm được những đoạn nào. Nếu chưa quen với AI Agent, bạn có thể đọc trước bài AI Agent là gì?. Muốn đưa chatbot lên Telegram, tham khảo bài Xây chatbot Telegram hỏi đáp dữ liệu bằng n8n và Claude.
📅 Muốn học bài bản AI và tự động hóa cho công việc? Xem lịch khai giảng mới nhất tại MCNA.
6 mẹo để chatbot RAG trả lời đúng
Phần lớn câu trả lời sai của chatbot RAG không nằm ở mô hình AI mà ở khâu tài liệu và tìm kiếm. Nếu tìm sai đoạn, mô hình giỏi đến đâu cũng trả lời sai.
MẸO 1
Dọn tài liệu trước khi nạp
bỏ bản cũ, bản nháp, tài liệu trùng lặp. Hai phiên bản quy chế mâu thuẫn nhau sẽ khiến chatbot trả lời lẫn lộn.
MẸO 2
Chia đoạn theo ý, không chỉ theo độ dài
cố gắng để mỗi đoạn trọn một mục hoặc một điều khoản, có phần chồng lấn nhỏ giữa các đoạn để không cắt đôi một ý.
MẸO 3
Gắn thông tin mô tả (metadata)
tên tài liệu, phòng ban, ngày hiệu lực. Nhờ đó chatbot có thể trích nguồn và bạn có thể lọc theo phòng ban khi cần.
MẸO 4
Cho phép chatbot nói “không biết”
ghi rõ trong hướng dẫn hệ thống rằng nếu tài liệu không có thông tin thì phải nói không tìm thấy, không được tự suy đoán.
MẸO 5
Luôn trích nguồn
yêu cầu chatbot ghi tên tài liệu hoặc mục đã dùng, để người hỏi tự kiểm tra khi cần.
MẸO 6
Có quy trình cập nhật
khi tài liệu thay đổi, xóa các đoạn cũ trong kho trước khi nạp bản mới. Có thể dùng webhook hoặc trigger theo thư mục để việc này tự động, xem thêm bài Webhook là gì?.
Cách viết hướng dẫn hệ thống cũng ảnh hưởng lớn đến chất lượng câu trả lời. Bài Prompt cho Data Analyst: 15 mẫu prompt có công thức 5 phần bạn có thể áp dụng.
Kiểm thử và bảo mật chatbot RAG
Kiểm thử bằng bộ câu hỏi mẫu
Trước khi cho mọi người dùng, hãy chuẩn bị khoảng 20–30 câu hỏi kèm đáp án đúng lấy từ tài liệu, gồm 3 loại:
✓
Câu hỏi có sẵn trong tài liệu
kiểm tra chatbot tìm đúng đoạn và trả lời đúng.
≈
Câu hỏi hỏi khác từ ngữ
cùng ý nhưng dùng từ khác với tài liệu, kiểm tra khả năng tìm theo ý nghĩa.
?
Câu hỏi không có trong tài liệu
chatbot phải nói không tìm thấy thay vì tự bịa.
Ghi lại kết quả trong một bảng với các cột: câu hỏi, đáp án mong đợi, câu trả lời của chatbot, đoạn tài liệu đã dùng, đúng hay sai. Mỗi lần đổi cách chia đoạn hay sửa prompt, chạy lại bộ câu hỏi này để so sánh. Đây chính là cách Data Analyst đo chất lượng chatbot bằng số liệu thay vì cảm tính.
Những điều cần lưu ý về bảo mật
⚠ Phân quyền theo người hỏi: chatbot có quyền đọc tài liệu nào thì ai hỏi cũng có thể nhận được nội dung đó. Đừng nạp bảng lương hay hợp đồng vào cùng một kho với sổ tay nhân viên.
⚠ Cân nhắc nơi xử lý dữ liệu: tài liệu sẽ được gửi tới dịch vụ embedding và mô hình AI. Kiểm tra chính sách của công ty trước khi nạp tài liệu nội bộ, xem thêm bài Bảo mật dữ liệu khi dùng AI.
⚠ Cẩn thận với chỉ dẫn lạ trong tài liệu: nếu kho có nội dung từ bên ngoài (email khách hàng, trang web), một câu như “bỏ qua hướng dẫn trước đó” có thể làm chatbot hoạt động sai. Chỉ nạp nguồn đáng tin cậy.
Câu hỏi thường gặp về RAG
?
RAG có giúp chatbot hết trả lời sai không?
RAG giảm mạnh việc bịa thông tin nhưng không loại bỏ hoàn toàn. Chatbot vẫn có thể sai khi tìm nhầm đoạn, tài liệu mâu thuẫn, hoặc hiểu sai nội dung. Vì vậy cần trích nguồn và kiểm thử định kỳ.
?
Có cần biết lập trình để làm RAG không?
Với n8n và các node có sẵn, bạn có thể dựng bản thử mà không cần viết code. Khi cần tùy biến sâu như cách chia đoạn riêng, lọc theo quyền hay đánh giá tự động, kiến thức Python và SQL sẽ rất hữu ích.
?
Vector database là gì, có bắt buộc không?
Vector database là nơi lưu các vector và tìm nhanh những vector gần nhau. Với vài tài liệu nhỏ, kho trong bộ nhớ của n8n là đủ để thử. Khi tài liệu nhiều và cần lưu lâu dài, nên dùng vector database thật như Supabase (PostgreSQL có pgvector), Qdrant hay Pinecone.
?
RAG có dùng được cho dữ liệu dạng bảng không?
RAG phù hợp nhất với văn bản. Với câu hỏi cần tính toán trên bảng số liệu như “doanh thu tháng này là bao nhiêu”, cách tốt hơn là để AI viết và chạy SQL trên database. RAG vẫn hữu ích để tra cứu định nghĩa cột, ý nghĩa KPI trước khi viết SQL.
?
Chi phí vận hành chatbot RAG có cao không?
Chi phí gồm tiền tạo embedding (thường thấp, chủ yếu lúc nạp tài liệu), tiền gọi mô hình chat cho mỗi câu hỏi và chi phí lưu trữ vector database. Với một chatbot nội bộ quy mô nhỏ, phần lớn chi phí nằm ở số lượt hỏi, nên hãy theo dõi lượt dùng ngay từ đầu.
Kết luận
RAG giúp chatbot chuyển từ “thi đóng sách” sang “thi mở sách”: tìm đúng đoạn tài liệu nội bộ trước khi trả lời, nhờ đó câu trả lời bám sát quy định thật, cập nhật được và có nguồn để kiểm tra. Với bài toán hỏi đáp tài liệu, đây thường là lựa chọn nhanh và rẻ hơn fine-tuning.
Hãy bắt đầu nhỏ với một bộ tài liệu đã dọn sạch, dựng thử bằng n8n, kiểm thử bằng bộ câu hỏi mẫu và luôn cho phép chatbot nói “không tìm thấy”. Một chatbot biết nói không biết đáng tin hơn một chatbot lúc nào cũng có câu trả lời.
Nếu bạn muốn học bài bản cách ứng dụng AI, chatbot và tự động hóa vào công việc dữ liệu, các khóa học tại MCNA Technology School sẽ đồng hành cùng bạn. Xem lịch khai giảng mới nhất. Đọc thêm: Claude là gì? Cách Data Analyst dùng Claude và AI Agent là gì?.