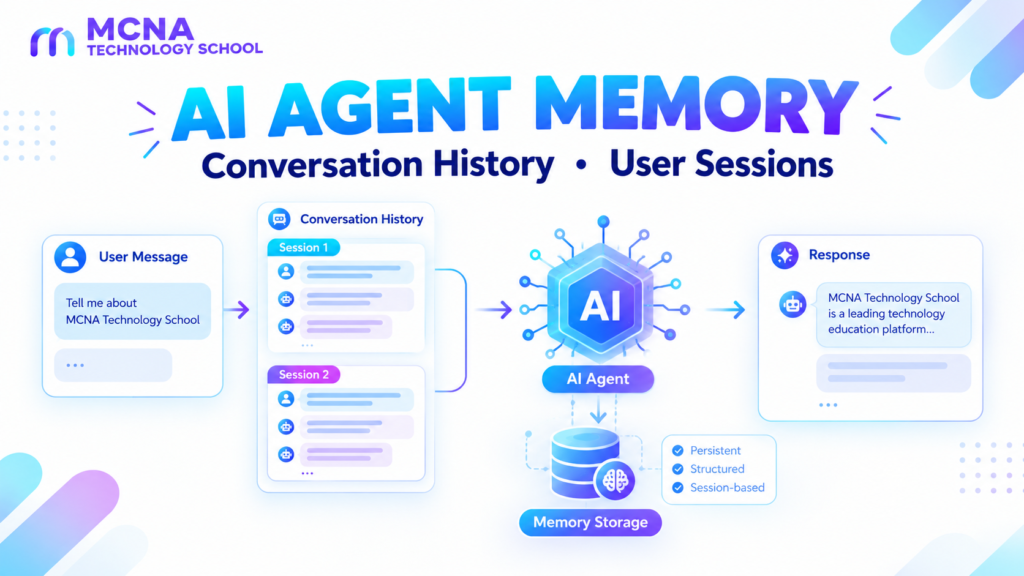
Một AI Agent có thể trả lời tốt một câu hỏi, nhưng nếu người dùng hỏi tiếp “Vậy phương án thứ hai thì sao?” mà Agent không biết phương án nào đang được nhắc đến, trải nghiệm sẽ trở nên rời rạc.
Để giải quyết vấn đề này, AI Agent cần quản lý bộ nhớ. Agent phải có khả năng lưu lại những thông tin liên quan từ các lượt hội thoại trước, truy xuất đúng ngữ cảnh khi cần và tránh nhầm lẫn dữ liệu giữa các phiên làm việc.
Trong bài viết này, MCNA Technology School sẽ giới thiệu AI Agent Memory, phân biệt short-term memory với long-term memory và xây dựng một API hội thoại đơn giản bằng Python và FastAPI.
1. AI Agent Memory là gì?
AI Agent Memory là cơ chế giúp một Agent lưu trữ và truy xuất thông tin từ những tương tác trước đó để sử dụng trong các bước xử lý tiếp theo.
Memory không đồng nghĩa với việc mô hình AI tự động học lại sau mỗi câu hỏi. Trong nhiều ứng dụng, hệ thống chủ động lưu lịch sử hội thoại hoặc các thông tin cần thiết, sau đó đưa chúng vào ngữ cảnh khi gọi mô hình.
Ví dụ, một người dùng hỏi:
Người dùng: Hãy phân tích doanh thu của cửa hàng trong tháng này.
Agent: Doanh thu tăng 12% so với tháng trước.
Người dùng: Vậy nguyên nhân chính là gì?
Nếu Agent không có lịch sử hội thoại, câu hỏi thứ hai có thể quá mơ hồ. Nếu hệ thống cung cấp đúng ngữ cảnh từ lượt trao đổi trước, Agent có cơ sở để tiếp tục phân tích.
2. Short-term Memory và Long-term Memory
Hai khái niệm này thường được sử dụng để phân biệt phạm vi và thời gian lưu giữ thông tin. Tài liệu về memory của LangChain cũng mô tả short-term memory theo phạm vi thread hoặc cuộc hội thoại, trong khi long-term memory có thể được sử dụng qua nhiều thread khác nhau.
Tham khảo: LangChain – Memory Overview.
| Tiêu chí | Short-term Memory | Long-term Memory |
|---|---|---|
| Phạm vi | Một cuộc hội thoại | Có thể qua nhiều cuộc hội thoại |
| Dữ liệu | Lịch sử hỏi đáp gần đây, trạng thái tác vụ | Sở thích, thông tin được lưu có chủ đích, kiến thức cần dùng lại |
| Ví dụ | Nhớ bảng dữ liệu đang được phân tích | Nhớ người dùng thường muốn báo cáo theo tháng |
| Nơi lưu | RAM, Redis, database hoặc checkpoint store | Database, kho dữ liệu hoặc hệ thống memory chuyên dụng |
Hai loại memory có thể phối hợp trong cùng một ứng dụng. Short-term memory duy trì ngữ cảnh công việc đang diễn ra, còn long-term memory chỉ lưu những thông tin có ích để tái sử dụng về sau.
3. Conversation History hoạt động như thế nào?
Với một ứng dụng chatbot cơ bản, conversation history thường là danh sách các message theo thứ tự thời gian. Mỗi message có thể chứa vai trò của người gửi và nội dung.
conversation_history = [
    {
        "role": "user",
        "content": "Doanh thu tháng này là bao nhiêu?"
    },
    {
        "role": "assistant",
        "content": "Doanh thu đạt 500 triệu đồng."
    },
    {
        "role": "user",
        "content": "So sánh với tháng trước."
    }
]
Khi nhận câu hỏi mới, ứng dụng có thể lấy các message trước đó và gửi kèm vào yêu cầu đến mô hình. Nhờ vậy, mô hình có thêm ngữ cảnh để hiểu những cụm từ như “tháng trước”, “phương án đó” hoặc “kết quả vừa rồi”.
Cần lưu ý rằng lịch sử hội thoại được lưu trong ứng dụng không tự động trở thành memory của mô hình. Ứng dụng phải chủ động lựa chọn thông tin phù hợp và đưa vào request theo định dạng mà nhà cung cấp mô hình hỗ trợ.
4. Quản lý User Session và Conversation ID
Một ứng dụng thực tế có thể phục vụ nhiều người dùng đồng thời. Vì vậy, hệ thống không thể lưu toàn bộ hội thoại vào một danh sách chung mà không có cơ chế phân tách.
Có thể hình dung cấu trúc như sau:
User A
  ├── Conversation 1
  │     └── Message history
  └── Conversation 2
        └── Message history

User B
  └── Conversation 3
        └── Message history
Mỗi conversation cần một định danh riêng. Khi người dùng gửi câu hỏi tiếp theo, API sử dụng định danh đó để truy xuất lịch sử tương ứng.
- User ID: Xác định người dùng đã được hệ thống xác thực.
- Conversation ID: Xác định một cuộc hội thoại cụ thể.
- Message history: Lưu các lượt trao đổi thuộc cuộc hội thoại đó.
Conversation ID không nên được xem là bằng chứng xác thực người dùng. Trong hệ thống thực tế, server cần kiểm tra người dùng đã đăng nhập có quyền truy cập cuộc hội thoại được yêu cầu hay không. Không được chỉ dựa vào một ID do client gửi lên để cho phép đọc dữ liệu.
5. Xây dựng AI Agent Memory bằng Python và FastAPI
Chúng ta sẽ xây dựng một API minh họa với ba chức năng:
- Tạo một cuộc hội thoại mới.
- Nhận câu hỏi và lưu lịch sử hội thoại.
- Trả lại lịch sử của một cuộc hội thoại.
Ví dụ này sử dụng dictionary trong RAM để giúp người mới hiểu cơ chế. Đây là bản demo, chưa có xác thực người dùng, chưa tích hợp LLM và không phù hợp để lưu trữ dữ liệu production.
Bước 1: Cài đặt thư viện
Tạo file requirements.txt:
fastapi
uvicorn[standard]
Cài đặt thư viện:
python -m pip install -r requirements.txtBước 2: Viết API quản lý hội thoại
Tạo file main.py:
from uuid import uuid4

from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="AI Agent Memory API")

# Demo only: dữ liệu sẽ mất khi process khởi động lại
conversations = {}


class ChatRequest(BaseModel):
    conversation_id: str
    message: str = Field(min_length=1, max_length=2000)


@app.post("/conversations")
def create_conversation():
    conversation_id = str(uuid4())

    conversations[conversation_id] = []

    return {
        "conversation_id": conversation_id,
        "message": "Conversation created"
    }


@app.post("/chat")
def chat(request: ChatRequest):
    if request.conversation_id not in conversations:
        raise HTTPException(
            status_code=404,
            detail="Conversation not found"
        )

    history = conversations[request.conversation_id]

    history.append({
        "role": "user",
        "content": request.message
    })

    # Logic demo, chưa gọi mô hình LLM
    answer = (
        f"Bạn vừa hỏi: {request.message}. "
        f"Cuộc hội thoại có {len(history)} message."
    )

    history.append({
        "role": "assistant",
        "content": answer
    })

    return {
        "conversation_id": request.conversation_id,
        "answer": answer,
        "history_length": len(history)
    }


@app.get("/conversations/{conversation_id}")
def get_conversation(conversation_id: str):
    if conversation_id not in conversations:
        raise HTTPException(
            status_code=404,
            detail="Conversation not found"
        )

    return {
        "conversation_id": conversation_id,
        "history": conversations[conversation_id]
    }
FastAPI sử dụng Pydantic model để khai báo và kiểm tra dữ liệu gửi trong request body. Cách làm này giúp API xác định cấu trúc dữ liệu đầu vào rõ ràng hơn.
Tài liệu tham khảo: FastAPI – Request Body.
Bước 3: Chạy ứng dụng
Lưu file với tên main.py, sau đó chạy:
uvicorn main:app --reloadMở http://127.0.0.1:8000/docs để thử các endpoint.
Đầu tiên, gọi POST /conversations. API sẽ trả về một conversation ID, ví dụ:
{
  "conversation_id": "c1f0d1b7-1234-4567-8901-123456789abc",
  "message": "Conversation created"
}
Tiếp theo, gọi POST /chat và sử dụng ID vừa nhận được:
{
  "conversation_id": "c1f0d1b7-1234-4567-8901-123456789abc",
  "message": "Phân tích doanh thu tháng này"
}
Khi gửi câu hỏi tiếp theo với cùng conversation ID, ứng dụng tiếp tục lưu message vào cùng lịch sử. Nếu sử dụng một conversation ID khác, hệ thống sẽ truy cập một danh sách hội thoại khác.
6. Tích hợp lịch sử hội thoại với LLM
Ở ví dụ trước, phần trả lời chỉ là logic demo. Để biến ứng dụng thành chatbot AI, cần thay phần tạo câu trả lời bằng lời gọi đến mô hình ngôn ngữ.
Về mặt khái niệm, luồng xử lý sẽ là:
New user message
       |
       v
Load conversation history
       |
       v
Build messages for the LLM
       |
       v
Call the model
       |
       v
Save user message and response
       |
       v
Return answer to the client
Ví dụ giả lập phần chuẩn bị message cho một chat API:
def build_messages(history, new_message):
    messages = [
        {
            "role": "system",
            "content": (
                "Bạn là trợ lý phân tích dữ liệu. "
                "Trả lời rõ ràng và không bịa số liệu."
            )
        }
    ]

    messages.extend(history)

    messages.append({
        "role": "user",
        "content": new_message
    })

    return messages
Hàm trên minh họa cách kết hợp chỉ dẫn hệ thống, lịch sử và câu hỏi mới. Trong ứng dụng thực tế, bạn cần gọi API của nhà cung cấp LLM bằng SDK phù hợp, xử lý lỗi, timeout và giới hạn chi phí. Cũng cần tránh lưu hoặc gửi lại những dữ liệu nhạy cảm không cần thiết.
Một chi tiết quan trọng: nếu lịch sử đã chứa câu hỏi mới, không được thêm câu hỏi đó lần thứ hai vào request. Đồng thời, chỉ lưu message sau khi xác định rõ trạng thái thành công hoặc lỗi để tránh lịch sử không nhất quán.
7. Giới hạn của bộ nhớ lưu trong RAM
Dictionary trong ví dụ phù hợp để học và kiểm thử nhanh, nhưng có nhiều hạn chế:
- Mất dữ liệu: Dữ liệu trong RAM mất khi ứng dụng khởi động lại.
- Nhiều worker: Các process có bộ nhớ riêng, nên không tự động chia sẻ cùng lịch sử.
- Khả năng mở rộng: Dữ liệu tăng lên sẽ tiêu tốn bộ nhớ của ứng dụng.
- Độ bền dữ liệu: Không có cơ chế lưu trữ và khôi phục như database.
- Bảo mật: Ví dụ chưa có xác thực và kiểm tra quyền truy cập theo user.
Vì vậy, không nên dùng bộ nhớ trong RAM làm kho lưu trữ hội thoại lâu dài cho ứng dụng có nhiều người dùng.
8. Lựa chọn nơi lưu trữ Memory
| Giải pháp | Phù hợp khi | Lưu ý |
|---|---|---|
| Dictionary / RAM | Demo và học tập | Mất dữ liệu khi process dừng; không chia sẻ tự động giữa worker. |
| Redis | Truy cập nhanh, dữ liệu tạm thời hoặc session cần chia sẻ giữa các instance | Cần thiết kế TTL, persistence và chính sách xóa dữ liệu phù hợp. |
| PostgreSQL / SQL database | Lưu hội thoại lâu dài, truy vấn theo người dùng và thời gian | Cần thiết kế schema, chỉ mục, phân quyền và chính sách lưu giữ. |
| Memory store chuyên dụng | Agent framework cần quản lý state hoặc truy xuất memory dài hạn | Cần hiểu rõ cách phân vùng dữ liệu và cơ chế truy xuất của framework. |
Redis hỗ trợ các cấu trúc dữ liệu như Lists, có thể dùng để lưu chuỗi message theo thứ tự. Tuy nhiên, việc chọn Redis hay database quan hệ phụ thuộc vào yêu cầu về độ bền dữ liệu, khả năng truy vấn, quy mô và chi phí vận hành.
Tham khảo: Redis – Lists.
9. Quản lý lịch sử dài và Long-term Memory
Không nên gửi toàn bộ lịch sử hội thoại vào mỗi request mà không có giới hạn. Khi số lượng message tăng lên, request có thể tốn nhiều token, tăng độ trễ và vượt giới hạn ngữ cảnh của mô hình.
Một số chiến lược thường được sử dụng:
- Giới hạn số message gần nhất: Chỉ đưa những lượt trao đổi mới nhất vào ngữ cảnh.
- Tóm tắt lịch sử: Chuyển phần hội thoại cũ thành bản tóm tắt ngắn.
- Lưu thông tin quan trọng: Tách các dữ kiện cần dùng lâu dài khỏi transcript đầy đủ.
- Truy xuất theo nhu cầu: Chỉ lấy các thông tin liên quan đến câu hỏi hiện tại.
- Thiết lập thời hạn lưu trữ: Xóa hoặc ẩn danh dữ liệu theo chính sách của ứng dụng.
Ví dụ, một Agent hỗ trợ phân tích dữ liệu có thể lưu lịch sử hội thoại gần nhất làm short-term memory. Nếu người dùng chủ động lưu sở thích báo cáo, chẳng hạn muốn biểu đồ theo tháng và số liệu theo đơn vị triệu đồng, hệ thống có thể lưu những tùy chọn đó vào long-term memory sau khi kiểm tra và xác định phạm vi sử dụng.
Không nên tự động coi mọi thông tin trong hội thoại là dữ liệu cần ghi nhớ lâu dài. Việc lưu thông tin cần có mục đích rõ ràng, giới hạn quyền truy cập và cơ chế cho phép người dùng xem hoặc xóa khi phù hợp.
10. Bảo mật User Session và Conversation History
Lịch sử hội thoại có thể chứa dữ liệu kinh doanh, thông tin cá nhân hoặc tài liệu nội bộ. Do đó, hệ thống cần có cơ chế bảo vệ ngay từ khi thiết kế.
- Xác thực người dùng: Kiểm tra danh tính trước khi truy cập dữ liệu riêng tư.
- Kiểm tra quyền sở hữu: Xác minh conversation thuộc về người dùng đang đăng nhập.
- Quản lý session ID: Không dùng ID dễ đoán hoặc nhúng thông tin cá nhân vào ID.
- Giới hạn thời gian lưu: Thiết lập chính sách hết hạn và xóa dữ liệu.
- Bảo vệ dữ liệu: Sử dụng HTTPS, kiểm soát quyền truy cập kho lưu trữ và mã hóa khi phù hợp.
- Logging an toàn: Không ghi API key, session token hoặc toàn bộ nội dung nhạy cảm vào log không cần thiết.
OWASP nhấn mạnh session identifier phải khó đoán, không chứa thông tin nhạy cảm và được quản lý an toàn trong suốt vòng đời của phiên. Conversation ID trong ví dụ không thay thế cho cơ chế xác thực hay phân quyền.
Tham khảo: OWASP – Session Management Cheat Sheet.
11. Checklist khi xây dựng AI Agent Memory
- Phân biệt rõ User ID và Conversation ID.
- Chỉ truy xuất hội thoại mà người dùng có quyền truy cập.
- Giới hạn độ dài message và số lượng message trong ngữ cảnh.
- Chọn RAM, Redis hoặc database theo yêu cầu thực tế.
- Xác định dữ liệu nào được lưu dài hạn và trong bao lâu.
- Kiểm thử việc khôi phục lịch sử sau khi ứng dụng khởi động lại.
- Đánh giá chi phí token và độ trễ khi lịch sử dài hơn.
- Bổ sung cơ chế xóa dữ liệu và xử lý lỗi lưu trữ.
Kết luận
AI Agent Memory là thành phần quan trọng giúp Agent duy trì ngữ cảnh và tạo trải nghiệm hội thoại liền mạch hơn. Conversation history hỗ trợ Agent xử lý các lượt hỏi đáp trong một cuộc hội thoại, còn long-term memory cho phép lưu và truy xuất những thông tin cần thiết giữa nhiều phiên.
Với Python và FastAPI, bạn có thể bắt đầu bằng một API đơn giản để quản lý conversation ID và lịch sử message. Khi ứng dụng phát triển, hãy chuyển sang cơ chế lưu trữ bền vững, bổ sung xác thực, kiểm soát quyền truy cập và chính sách lưu giữ dữ liệu phù hợp.
Điểm quan trọng không phải là ghi nhớ càng nhiều càng tốt, mà là lưu đúng thông tin, truy xuất đúng ngữ cảnh và bảo vệ dữ liệu của người dùng.
Học thêm về AI và Data tại MCNA Technology School
Nếu bạn muốn củng cố kiến thức Python, Data và ứng dụng AI vào các bài toán thực tế, hãy tham khảo các chương trình học tại MCNA Technology School: