LightGBM là gì? Vì sao LightGBM có thể huấn luyện nhanh trên dữ liệu lớn?
Series: Machine Learning Fundamentals – Bài 23 Ở bài trước, chúng ta đã tìm hiểu…
XGBoost là gì? Vì sao thuật toán này từng thống trị các cuộc thi Machine Learning?
Series: Machine Learning Fundamentals – Bài 22 Ở bài trước, chúng ta đã tìm hiểu…
Gradient Boosting là gì? Vì sao cây sau lại học từ lỗi của cây trước?
Series: Machine Learning Fundamentals – Bài 21 Ở bài trước, chúng ta đã tìm hiểu…
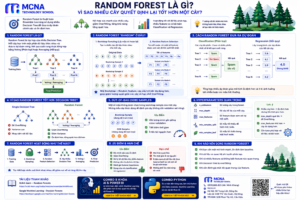
Random Forest là gì? Vì sao nhiều cây quyết định lại tốt hơn một cây?
Series: Machine Learning Fundamentals – Bài 20 Ở bài trước, chúng ta đã tìm hiểu…
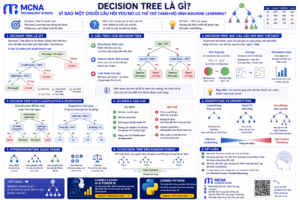
Decision Tree là gì? Vì sao một chuỗi câu hỏi Yes/No có thể trở thành mô hình Machine Learning?
Series: Machine Learning Fundamentals – Bài 19 Hãy tưởng tượng một ngân hàng cần quyết…
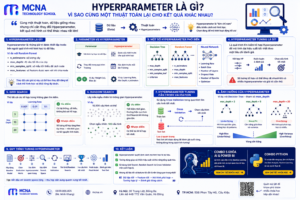
Hyperparameter là gì? Vì sao cùng một thuật toán lại cho kết quả khác nhau?
Series: Machine Learning Fundamentals – Bài 18 Hai Data Scientist cùng sử dụng Random Forest…
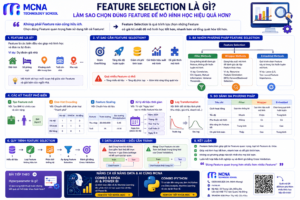
Feature Selection là gì? Làm sao chọn đúng Feature để mô hình học hiệu quả hơn?
Series: Machine Learning Fundamentals – Bài 17 Ở bài trước, chúng ta đã tìm hiểu…
Feature Engineering là gì? Vì sao dữ liệu tốt quan trọng hơn mô hình tốt?
Series: Machine Learning Fundamentals – Bài 16 Khi mới học Machine Learning, nhiều người thường…
Cross Validation là gì? Vì sao không nên chỉ chia Train/Test một lần?
Series: Machine Learning Fundamentals – Bài 15 Sau khi xây dựng mô hình Machine Learning,…