Transformer là gì? Kiến trúc đứng sau ChatGPT và nhiều mô hình AI hiện đại
Ở bài trước, chúng ta đã tìm hiểu Attention Mechanism – cơ chế giúp mô hình xác định mức độ liên quan giữa các phần khác nhau trong một sequence.
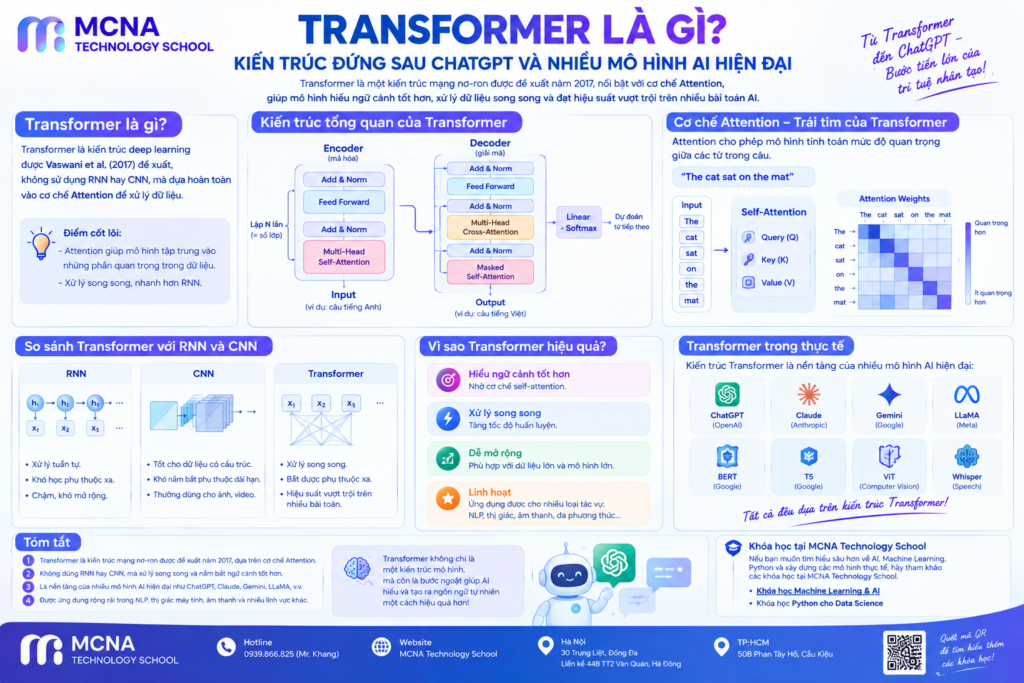
Attention đã tạo ra một thay đổi lớn trong cách xử lý dữ liệu tuần tự. Nhưng bước tiến quan trọng hơn xuất hiện vào năm 2017, khi nhóm nghiên cứu tại Google giới thiệu kiến trúc Transformer trong paper Attention Is All You Need.
Thay vì phụ thuộc vào RNN hoặc LSTM để xử lý dữ liệu tuần tự, Transformer sử dụng Attention làm thành phần trung tâm.
Ngày nay, Transformer là nền tảng của rất nhiều mô hình AI hiện đại, đặc biệt trong lĩnh vực xử lý ngôn ngữ tự nhiên và Generative AI.
1. Transformer là gì?
Transformer là một kiến trúc Deep Learning được thiết kế để xử lý dữ liệu tuần tự bằng cơ chế Attention, đặc biệt là Self-Attention.
Transformer được giới thiệu trong paper:
Điểm khác biệt quan trọng là Transformer không cần xử lý từng phần tử theo đúng thứ tự tuần tự như RNN.
Thay vào đó, mô hình có thể tính toán mối quan hệ giữa nhiều token trong sequence thông qua Attention.
Có thể hình dung quá trình phát triển:
RNN
  ↓
LSTM / GRU
  ↓
Attention
  ↓
Transformer
  ↓
BERT / GPT / LLM
2. Tại sao Transformer ra đời?
RNN, LSTM và GRU có khả năng xử lý dữ liệu tuần tự nhưng có một đặc điểm quan trọng:
Chúng xử lý sequence theo từng timestep.
Token 1
   ↓
Token 2
   ↓
Token 3
   ↓
Token 4
   ↓
...
   ↓
Token N
Cách tiếp cận này khiến việc xử lý sequence dài trở nên khó song song hóa.
Ví dụ với một câu có 100 từ, mô hình recurrent phải truyền trạng thái từ timestep này sang timestep tiếp theo.
Transformer sử dụng Self-Attention để cho phép các token tương tác với nhau trực tiếp hơn:
Token 1 ─────┐
Token 2 ─────┤
Token 3 ─────┼──► Self-Attention
Token 4 ─────┤
...          │
Token N ─────┘
Điều này tạo điều kiện thuận lợi hơn cho việc tính toán song song trên phần cứng hiện đại.
3. Kiến trúc Transformer gồm những gì?
Transformer trong paper gốc có kiến trúc Encoder-Decoder.
Input
  │
  ▼
┌──────────────────┐
│     ENCODER      │
│                  │
│ Self-Attention   │
│       ↓          │
│ Feed Forward     │
└──────────────────┘
  │
  ▼
┌──────────────────┐
│     DECODER      │
│                  │
│ Masked Attention │
│       ↓          │
│ Cross Attention  │
│       ↓          │
│ Feed Forward     │
└──────────────────┘
  │
  ▼
Output
Hai thành phần chính là:
- Encoder: xây dựng biểu diễn của input.
- Decoder: sử dụng biểu diễn đó để tạo output.
Tuy nhiên, các mô hình Transformer hiện đại không nhất thiết sử dụng cả Encoder và Decoder. Một số kiến trúc tập trung vào Encoder, trong khi một số kiến trúc khác tập trung vào Decoder.
4. Transformer Encoder
Encoder nhận sequence đầu vào và biến nó thành một biểu diễn giàu thông tin hơn.
Một Encoder Layer trong Transformer nguyên bản gồm hai thành phần lớn:
- Multi-Head Self-Attention
- Feed-Forward Neural Network
Ngoài ra còn có:
- Residual Connection.
- Layer Normalization.
Có thể hình dung:
Input
  │
  ▼
Multi-Head Self-Attention
  │
  ▼
Add & Norm
  │
  ▼
Feed Forward Network
  │
  ▼
Add & Norm
  │
  ▼
Output
Một Transformer thực tế thường xếp chồng nhiều Encoder Layer lên nhau.
5. Multi-Head Self-Attention
Đây là một trong những thành phần quan trọng nhất của Transformer.
Ở bài trước, chúng ta đã tìm hiểu Self-Attention.
Transformer mở rộng ý tưởng này thành Multi-Head Attention.
Thay vì chỉ thực hiện một phép Attention:
Input
  ↓
Attention
  ↓
Output
Transformer thực hiện nhiều Attention Head:
                 Input
                   │
       ┌───────────┼───────────┐
       ↓           ↓           ↓
    Head 1      Head 2      Head 3
       ↓           ↓           ↓
  Attention    Attention    Attention
       ↓           ↓           ↓
       └───────────┼───────────┘
                   ↓
              Concatenate
                   ↓
              Linear Layer
                   ↓
                 Output
Mỗi head có thể học các mối quan hệ khác nhau trong dữ liệu.
Nhờ đó, mô hình có thể xây dựng biểu diễn phong phú hơn so với việc chỉ sử dụng một Attention operation.
6. Query, Key và Value trong Transformer
Multi-Head Attention vẫn dựa trên ba thành phần quen thuộc:
- Query (Q)
- Key (K)
- Value (V)
Input được biến đổi thông qua các ma trận trọng số để tạo ra Q, K và V:
Input
  │
  ├──► WQ ──► Query
  │
  ├──► WK ──► Key
  │
  └──► WV ──► Value
Sau đó Transformer tính Attention:
Attention(Q,K,V)
=
softmax(QKᵀ / √dₖ)V
Đây là công thức Scaled Dot-Product Attention.
7. Positional Encoding – Transformer biết thứ tự bằng cách nào?
Đây là một câu hỏi rất quan trọng.
RNN vốn xử lý dữ liệu theo thứ tự:
A → B → C → D
Nhưng Transformer có khả năng xử lý nhiều token song song.
Vậy làm thế nào mô hình biết:
"I love AI"
khác với:
"AI love I"
Transformer sử dụng thông tin về vị trí, được gọi là Positional Encoding trong kiến trúc Transformer nguyên bản.
Thông tin vị trí được kết hợp với embedding của token:
Token Embedding
      +
Positional Encoding
      │
      ▼
Transformer Input
Nhờ vậy, mô hình vừa biết:
- Token đó là gì.
- Token đó nằm ở vị trí nào trong sequence.
Trong Transformer nguyên bản, positional encoding sử dụng các hàm sin và cos với các tần số khác nhau.
8. Feed-Forward Network
Sau Multi-Head Attention, dữ liệu được đưa qua một mạng neural feed-forward.
Về cơ bản, đây là một mạng được áp dụng riêng trên biểu diễn của từng vị trí.
Attention Output
      │
      ▼
Linear Layer
      │
      ▼
Activation
      │
      ▼
Linear Layer
      │
      ▼
Output
Trong Transformer nguyên bản, Feed-Forward Network thường gồm hai lớp tuyến tính với một hàm activation ở giữa.
Attention giúp các token tương tác với nhau, trong khi Feed-Forward Network tiếp tục biến đổi biểu diễn tại từng vị trí.
9. Residual Connection và Layer Normalization
Transformer cũng sử dụng Residual Connection để giúp việc huấn luyện mạng sâu hiệu quả hơn.
Có thể hình dung:
Input ───────────────────┐
  │                      │
  ▼                      │
Attention                │
  │                      │
  └────────── + ◄────────┘
             │
             ▼
        Layer Norm
Residual Connection cho phép thông tin từ layer trước được truyền trực tiếp đến layer sau thông qua một đường tắt.
Layer Normalization sau đó được sử dụng để ổn định quá trình huấn luyện.
10. Transformer Decoder là gì?
Trong kiến trúc Transformer nguyên bản, Decoder nhận thông tin từ Encoder và tạo output tuần tự.
Decoder có ba thành phần Attention chính:
- Masked Self-Attention.
- Encoder-Decoder Attention.
- Feed-Forward Network.
Masked Self-Attention rất quan trọng khi mô hình sinh văn bản.
Nó ngăn mô hình nhìn thấy những token ở phía sau token hiện tại trong quá trình training.
Ví dụ:
I      love      studying      AI

I      ✓
love   ✓         ✓
studying ✓       ✓          ✓
AI     ✓         ✓          ✓          ✓
Nhờ masking, khi dự đoán một token, mô hình chỉ được sử dụng những thông tin đã xuất hiện trước đó.
11. Encoder-only, Decoder-only và Encoder-Decoder
Sau khi Transformer ra đời, nhiều kiến trúc khác nhau đã được phát triển dựa trên nó.
| Kiến trúc | Đặc điểm | Ví dụ |
|---|---|---|
| Encoder-only | Tập trung xây dựng biểu diễn input | BERT |
| Decoder-only | Tập trung sinh sequence | GPT |
| Encoder-Decoder | Biến đổi một sequence thành sequence khác | T5 |
Đây là một cách phân loại quan trọng để hiểu các mô hình Transformer hiện đại.
12. Transformer và GPT
GPT là một dòng mô hình ngôn ngữ dựa trên kiến trúc Transformer theo hướng decoder-only.
Ý tưởng cơ bản của language modeling là dự đoán token tiếp theo dựa trên những token trước đó.
Ví dụ:
"The capital of France is"

             ↓

         "Paris"
Mô hình học xác suất của token tiếp theo dựa trên context đã có.
Quá trình này được lặp lại để tạo ra chuỗi văn bản:
The
 ↓
The capital
 ↓
The capital of
 ↓
The capital of France
 ↓
The capital of France is
 ↓
The capital of France is Paris
Đây là một trong những ý tưởng nền tảng của các mô hình ngôn ngữ sinh văn bản.
13. Transformer và BERT
BERT (Bidirectional Encoder Representations from Transformers) là một mô hình dựa trên Transformer Encoder.
Khác với mô hình language generation theo kiểu autoregressive, BERT được thiết kế để học biểu diễn ngôn ngữ dựa trên context hai chiều.
Một kỹ thuật training nổi tiếng của BERT là Masked Language Modeling.
Ví dụ:
"The student studies [MASK] at university."
Mô hình phải sử dụng context xung quanh để dự đoán token bị che.
Paper BERT:
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
14. Tại sao Transformer quan trọng với Generative AI?
Transformer cung cấp một kiến trúc có khả năng xây dựng biểu diễn phức tạp từ dữ liệu thông qua Attention.
Khi kết hợp với:
- Dataset quy mô lớn.
- GPU/TPU.
- Large-scale pretraining.
- Self-Supervised Learning.
- Fine-tuning.
Transformer trở thành nền tảng cho nhiều hệ thống AI hiện đại.
Trong lĩnh vực ngôn ngữ, những mô hình như:
- GPT.
- BERT.
- T5.
- Transformer-based LLMs.
đều dựa trên các biến thể của kiến trúc Transformer.
15. Transformer có phải chỉ dùng cho văn bản?
Không.
Mặc dù Transformer ban đầu được giới thiệu cho bài toán sequence-to-sequence trong Machine Translation, ý tưởng Attention sau đó được áp dụng rộng rãi hơn.
Transformer và các biến thể của nó được nghiên cứu trong nhiều lĩnh vực như:
- Natural Language Processing.
- Computer Vision.
- Speech Recognition.
- Audio Processing.
- Time Series.
- Multimodal AI.
Ví dụ trong Computer Vision, Vision Transformer (ViT) sử dụng Transformer để xử lý các patch của hình ảnh.
An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale
16. Hạn chế của Transformer
Transformer mang lại nhiều lợi ích nhưng cũng có những thách thức.
Chi phí tính toán của Attention
Self-Attention tiêu tốn nhiều tài nguyên khi sequence trở nên rất dài.
Với sequence có độ dài n, ma trận Attention cơ bản có kích thước liên quan đến n × n.
Do đó, khi sequence tăng lên rất lớn, chi phí bộ nhớ và tính toán có thể tăng đáng kể.
Yêu cầu tài nguyên lớn
Những mô hình Transformer quy mô lớn thường cần:
- Dataset lớn.
- GPU hoặc TPU mạnh.
- Thời gian training dài.
- Hệ thống lưu trữ và tính toán đáng kể.
Đây là lý do nghiên cứu về efficient attention, long-context models và các kiến trúc tối ưu hóa Transformer vẫn tiếp tục phát triển.
17. RNN → LSTM → GRU → Attention → Transformer
Toàn bộ chuỗi kiến thức chúng ta đã học có thể tóm tắt như sau:
RNN
 │
 │ Hidden State
 ▼
LSTM
 │
 │ Cell State + Gates
 ▼
GRU
 │
 │ Update Gate + Reset Gate
 ▼
Attention
 │
 │ Query + Key + Value
 ▼
Self-Attention
 │
 │ Multi-Head Attention
 ▼
Transformer
 │
 ├── Encoder
 ├── Decoder
 ├── Positional Information
 ├── Feed-Forward Network
 └── Residual + Normalization
Hiểu được chuỗi phát triển này sẽ giúp chúng ta không chỉ nhớ tên các mô hình mà còn hiểu vì sao các kiến trúc Deep Learning ngày càng phát triển.
18. Tổng kết
Transformer là một kiến trúc Deep Learning dựa trên Attention, được giới thiệu trong paper Attention Is All You Need năm 2017.
Những thành phần quan trọng cần nhớ:
- Self-Attention: cho phép các token tương tác với nhau.
- Multi-Head Attention: sử dụng nhiều Attention Head.
- Positional Encoding: cung cấp thông tin về vị trí.
- Feed-Forward Network: biến đổi biểu diễn tại từng vị trí.
- Residual Connection: tạo đường truyền tắt giữa các layer.
- Layer Normalization: hỗ trợ quá trình training.
- Encoder: xây dựng biểu diễn input.
- Decoder: tạo output dựa trên context.
Có thể ghi nhớ Transformer bằng một ý tưởng đơn giản:
RNN đọc sequence từng bước, còn Transformer sử dụng Attention để mô hình hóa mối quan hệ giữa các phần tử trong sequence.
Transformer chính là bước chuyển quan trọng từ các mô hình recurrent như RNN/LSTM/GRU sang nhiều kiến trúc AI hiện đại.
Ở bài tiếp theo, chúng ta sẽ đi sâu vào một trong những mô hình Transformer nổi tiếng nhất: BERT – cách AI hiểu ngữ cảnh hai chiều và học biểu diễn ngôn ngữ.
Tài liệu tham khảo
Attention Is All You Need
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale
TensorFlow – Transformer Tutorial
🚀 Học Data Science & AI cùng MCNA Technology School
Nếu bạn muốn xây dựng nền tảng từ Python, Data Analysis đến AI và Machine Learning, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Minh Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu