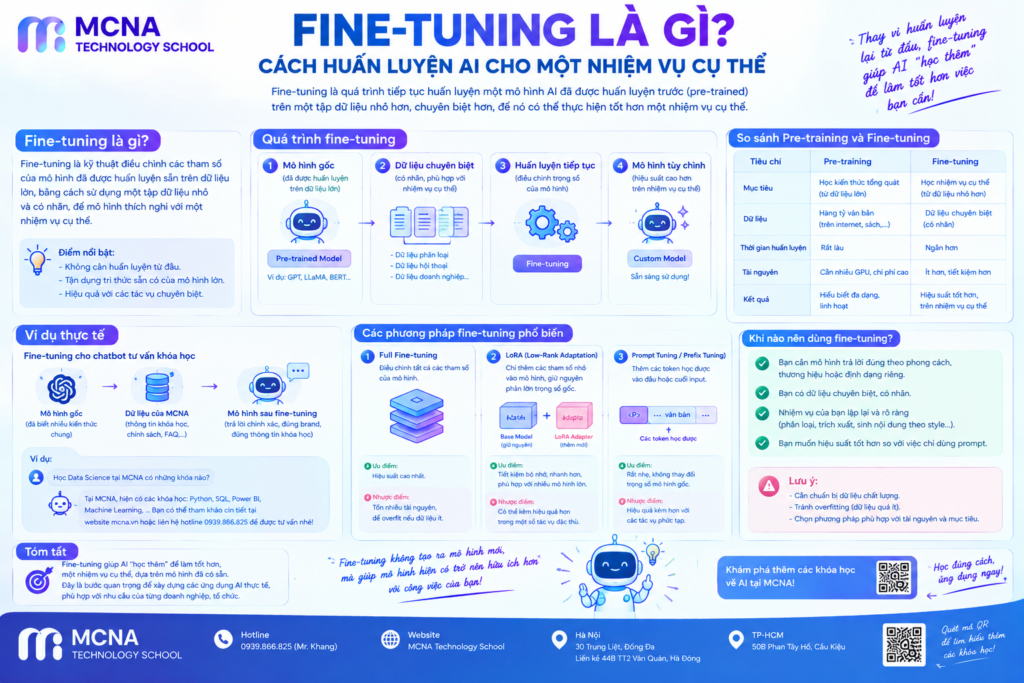
Fine-tuning là gì? Cách huấn luyện AI cho một nhiệm vụ cụ thể
Ở bài trước, chúng ta đã tìm hiểu Large Language Model (LLM) và cách các mô hình ngôn ngữ lớn được huấn luyện trên lượng dữ liệu khổng lồ.
Nhưng một mô hình được pre-trained trên dữ liệu tổng quát chưa chắc đã hoạt động tối ưu cho một nhiệm vụ cụ thể.
Ví dụ, nếu muốn xây dựng một mô hình chuyên phân loại phản hồi khách hàng, viết theo một phong cách nhất định hoặc xử lý tài liệu thuộc một lĩnh vực chuyên môn, chúng ta có thể sử dụng Fine-tuning.
Vậy Fine-tuning là gì? Nó khác Pre-training như thế nào và tại sao không cần huấn luyện lại toàn bộ mô hình từ đầu?
1. Fine-tuning là gì?
Fine-tuning là quá trình tiếp tục huấn luyện một mô hình đã được pre-trained trên một dataset hoặc nhiệm vụ cụ thể.
Thay vì bắt đầu với một mạng neural hoàn toàn mới, chúng ta sử dụng các parameter mà mô hình đã học được làm điểm khởi đầu.
Pre-trained Model
       ↓
Specific Dataset
       ↓
Fine-tuning
       ↓
Specialized Model
Ví dụ:
General LLM
    ↓
Customer Support Dataset
    ↓
Fine-tuning
    ↓
Customer Support Model
Nhờ đó, mô hình có thể thích nghi tốt hơn với một nhiệm vụ hoặc domain cụ thể.
2. Pre-training và Fine-tuning khác nhau như thế nào?
| Đặc điểm | Pre-training | Fine-tuning |
|---|---|---|
| Mục đích | Học kiến thức và pattern tổng quát | Thích nghi với nhiệm vụ cụ thể |
| Dữ liệu | Rất lớn và đa dạng | Thường nhỏ hơn và có mục tiêu rõ ràng |
| Chi phí | Rất cao | Thấp hơn đáng kể |
| Model | Học từ đầu | Bắt đầu từ pretrained model |
| Kết quả | Model tổng quát | Model chuyên biệt hơn |
Có thể hình dung:
Pre-training
      ↓
General Knowledge
      ↓
Fine-tuning
      ↓
Task-specific Knowledge
3. Vì sao không huấn luyện model từ đầu?
Huấn luyện một mô hình lớn từ đầu có thể yêu cầu lượng dữ liệu, compute và thời gian rất lớn.
Trong khi đó, pretrained model đã học được rất nhiều pattern cơ bản.
Ví dụ một LLM đã có thể học:
- Cấu trúc câu.
- Từ vựng.
- Ngữ pháp.
- Mối quan hệ giữa các khái niệm.
- Các pattern phổ biến trong văn bản.
Nếu nhiệm vụ mới chỉ yêu cầu mô hình thích nghi với một domain cụ thể, việc tận dụng những gì model đã học thường hiệu quả hơn so với bắt đầu lại từ đầu.
Train from Scratch

Random Parameters
       ↓
Huge Dataset
       ↓
Huge Compute
       ↓
Train Model


Fine-tuning

Pre-trained Parameters
       ↓
Smaller Task Dataset
       ↓
Fine-tune
       ↓
Specialized Model
4. Dataset dùng cho Fine-tuning
Chất lượng dataset đóng vai trò rất quan trọng.
Ví dụ với bài toán phân loại sentiment:
Text                              Label

"Sản phẩm rất tốt"                Positive
"Dịch vụ quá chậm"                Negative
"Chất lượng ổn"                   Neutral
Mô hình sẽ sử dụng những example này để điều chỉnh parameter nhằm thực hiện nhiệm vụ classification tốt hơn.
Với LLM, dataset có thể có dạng instruction:
Instruction:
"Giải thích Machine Learning cho người mới."

Response:
"Machine Learning là..."
Dataset càng phù hợp với mục tiêu, quá trình fine-tuning càng có cơ sở để đưa model về hành vi mong muốn.
5. Full Fine-tuning là gì?
Trong Full Fine-tuning, toàn bộ hoặc phần lớn parameter của model được cập nhật trong quá trình training.
Pre-trained Model
       │
       ├── Layer 1 → Update
       ├── Layer 2 → Update
       ├── Layer 3 → Update
       ├── Layer 4 → Update
       └── ...
Ưu điểm là model có nhiều khả năng thích nghi với dataset mới.
Tuy nhiên, với các mô hình lớn, full fine-tuning có thể yêu cầu lượng GPU memory và compute đáng kể.
6. Parameter-Efficient Fine-Tuning là gì?
Để giảm chi phí, một hướng tiếp cận khác là Parameter-Efficient Fine-Tuning (PEFT).
Thay vì cập nhật toàn bộ parameter, chỉ một phần nhỏ parameter hoặc các parameter bổ sung được train.
Large Pre-trained Model
          │
          ├── Original Parameters
          │       ↓
          │     Frozen
          │
          └── Small Trainable Parameters
                  ↓
               Updated
Điều này giúp giảm memory và compute cần thiết so với full fine-tuning.
7. LoRA là gì?
Một phương pháp PEFT nổi tiếng là LoRA – Low-Rank Adaptation.
Thay vì cập nhật trực tiếp toàn bộ weight matrix, LoRA bổ sung các ma trận có rank thấp để học phần thay đổi cần thiết.
Có thể hình dung đơn giản:
Original Weight
      +
Small LoRA Matrices
      ↓
Adapted Weight
Ý tưởng quan trọng là phần thay đổi cần thiết cho một nhiệm vụ có thể được biểu diễn bằng một số lượng parameter nhỏ hơn nhiều so với toàn bộ model.
LoRA vì vậy trở thành một phương pháp phổ biến khi fine-tuning các mô hình lớn với tài nguyên hạn chế.
8. Fine-tuning có làm model “học thêm kiến thức” không?
Có thể, nhưng cần hiểu chính xác.
Fine-tuning có thể giúp model thích nghi với dữ liệu mới và domain mới. Tuy nhiên, không nên hiểu đơn giản rằng fine-tuning luôn biến model thành một cơ sở dữ liệu chứa toàn bộ kiến thức của dataset.
Model vẫn học thông qua việc điều chỉnh các parameter để giảm loss trên dữ liệu training.
New Dataset
     ↓
Training Examples
     ↓
Loss
     ↓
Parameter Updates
     ↓
Changed Model Behavior
9. Fine-tuning có thể thay đổi hành vi của model
Ngoài kiến thức hoặc pattern trong domain, fine-tuning còn có thể ảnh hưởng đến cách model phản hồi.
Ví dụ:
General Model

"Explain this concept."

        ↓

General Answer


Fine-tuned Model

"Explain this concept."

        ↓

Answer theo format
và style đã được training
Điều này đặc biệt quan trọng trong những ứng dụng yêu cầu output có cấu trúc nhất quán.
10. Overfitting trong Fine-tuning
Fine-tuning cũng có nguy cơ Overfitting.
Nếu dataset quá nhỏ hoặc training quá lâu, model có thể học quá sát dữ liệu training.
Training Data
      ↓
Model learns examples
      ↓
Training Performance ↑

But:

New Data
      ↓
Performance ↓
Đây là lý do cần sử dụng validation set và theo dõi performance trong quá trình training.
Một số kỹ thuật có thể được sử dụng để hạn chế overfitting:
- Early stopping.
- Regularization.
- Data augmentation.
- Giảm learning rate.
- Sử dụng dataset đa dạng hơn.
11. Learning Rate khi Fine-tuning
Learning Rate quyết định mức độ thay đổi của parameter trong mỗi bước update.
Trong fine-tuning, learning rate thường cần được lựa chọn cẩn thận.
Nếu learning rate quá lớn:
Large Update
     ↓
Pre-trained Knowledge
may be disrupted
Nếu learning rate quá nhỏ:
Very Small Update
     ↓
Model changes slowly
     ↓
May not adapt enough
Do đó, hyperparameter tuning là một phần quan trọng của quá trình fine-tuning.
12. Fine-tuning cho những bài toán nào?
Fine-tuning có thể được sử dụng cho nhiều loại nhiệm vụ.
Text Classification
Customer Review
       ↓
Fine-tuned Model
       ↓
Positive / Negative / Neutral
Named Entity Recognition
"Apple opened a store in Hanoi."

Apple → Organization
Hanoi → Location
Question Answering
Question
   +
Context
   ↓
Fine-tuned Model
   ↓
Answer
Domain-specific Language
Model có thể được điều chỉnh để làm việc tốt hơn với dữ liệu thuộc các lĩnh vực như tài chính, pháp luật, y tế hoặc kỹ thuật.
13. Fine-tuning và Prompt Engineering
Fine-tuning không phải lúc nào cũng là lựa chọn đầu tiên.
Trong một số trường hợp, prompt tốt đã có thể giúp model thực hiện nhiệm vụ mà không cần training thêm.
Problem
  │
  ├── Prompt Engineering
  │
  ├── RAG
  │
  └── Fine-tuning
Ba phương pháp này giải quyết những vấn đề khác nhau.
Prompt Engineering tập trung vào cách cung cấp instruction và context.
RAG giúp model truy xuất thông tin từ nguồn dữ liệu bên ngoài.
Fine-tuning thay đổi model thông qua training.
14. Fine-tuning và RAG có giống nhau không?
Không.
| Fine-tuning | RAG | |
|---|---|---|
| Cách hoạt động | Thay đổi model qua training | Truy xuất dữ liệu bên ngoài khi inference |
| Model parameters | Có thể được cập nhật | Không nhất thiết thay đổi |
| Cập nhật kiến thức | Cần training lại | Có thể cập nhật nguồn dữ liệu |
| Chi phí triển khai | Cần training | Cần hệ thống retrieval |
Trong các hệ thống thực tế, Fine-tuning và RAG thậm chí có thể được sử dụng kết hợp.
15. Quy trình Fine-tuning cơ bản
Một workflow đơn giản có thể gồm:
1. Xác định bài toán
        ↓
2. Chuẩn bị dataset
        ↓
3. Chia Train / Validation
        ↓
4. Chọn Pre-trained Model
        ↓
5. Chọn phương pháp Fine-tuning
        ↓
6. Training
        ↓
7. Evaluation
        ↓
8. Deploy
Trong thực tế, có thể cần thêm nhiều bước như data cleaning, hyperparameter tuning, safety evaluation và monitoring.
16. Fine-tuning không thay thế Data Quality
Một trong những nguyên tắc quan trọng nhất trong Machine Learning vẫn là:
Garbage in, garbage out.
Nếu dataset có nhiều lỗi, nhãn không chính xác hoặc không đại diện cho dữ liệu thực tế, fine-tuning có thể khiến model học những pattern không mong muốn.
Do đó, trước khi tăng thời gian training hoặc thay đổi model, cần kiểm tra:
- Chất lượng dữ liệu.
- Độ chính xác của labels.
- Độ đa dạng của dataset.
- Data leakage.
- Phân bố giữa train và validation.
17. Tổng kết
Fine-tuning là quá trình tiếp tục huấn luyện một pretrained model trên dữ liệu hoặc nhiệm vụ cụ thể để model thích nghi tốt hơn với mục tiêu mới.
Những khái niệm quan trọng cần nhớ:
- Pre-training: học pattern tổng quát từ dữ liệu lớn.
- Fine-tuning: thích nghi model với nhiệm vụ hoặc domain cụ thể.
- Full Fine-tuning: cập nhật phần lớn hoặc toàn bộ parameter.
- PEFT: chỉ cập nhật một phần nhỏ parameter hoặc parameter bổ sung.
- LoRA: một phương pháp Parameter-Efficient Fine-Tuning phổ biến.
- Overfitting: model học quá sát dataset fine-tuning.
- RAG: truy xuất thông tin bên ngoài thay vì thay đổi model qua training.
Có thể ghi nhớ bằng một câu:
Fine-tuning là cách lấy một model đã được học trên dữ liệu tổng quát và tiếp tục huấn luyện nó để phù hợp hơn với một nhiệm vụ hoặc domain cụ thể.
Ở bài tiếp theo, chúng ta sẽ tìm hiểu một kỹ thuật rất quan trọng trong hệ thống AI hiện đại: RAG là gì? – cách AI sử dụng dữ liệu bên ngoài để trả lời câu hỏi mà không cần retrain toàn bộ mô hình.
Tài liệu tham khảo
- LoRA: Low-Rank Adaptation of Large Language Models
- Hugging Face – PEFT Documentation
- Training Language Models to Follow Instructions with Human Feedback
- Hugging Face – Training Documentation
🚀 Học Data Science & AI cùng MCNA Technology School
Nếu bạn muốn xây dựng nền tảng từ Python, Data Analysis đến AI và Machine Learning, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Minh Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu