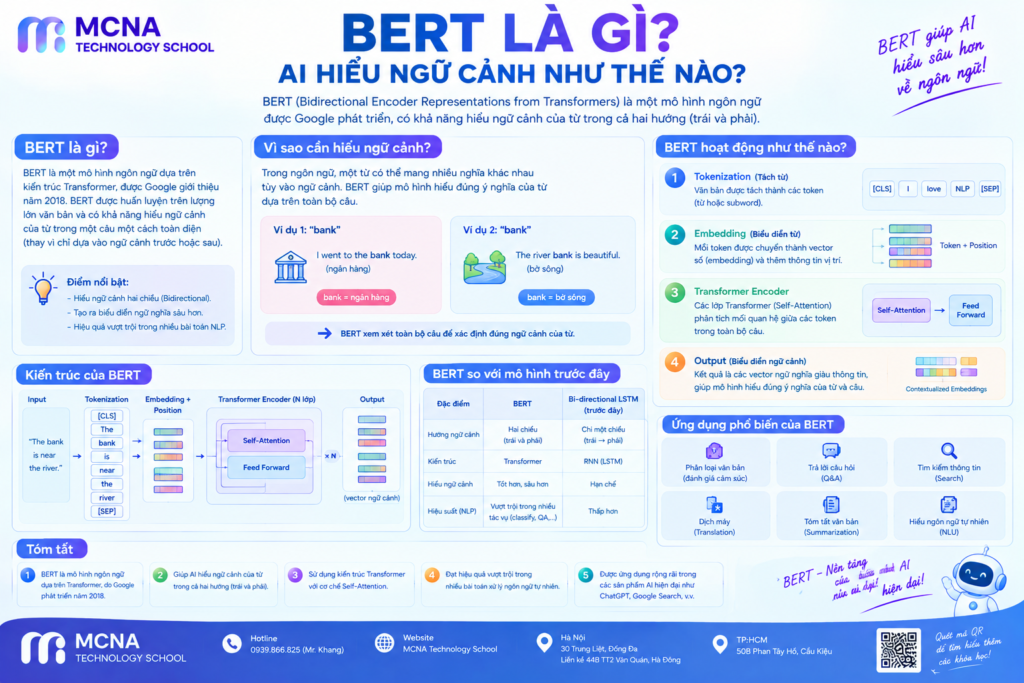
Một trong những mô hình nổi tiếng đầu tiên cho thấy sức mạnh của Transformer trong xử lý ngôn ngữ là BERT.
BERT không được thiết kế chủ yếu để sinh văn bản như các mô hình GPT. Thay vào đó, BERT tập trung vào việc hiểu ngữ cảnh và xây dựng biểu diễn có ý nghĩa cho văn bản.
Vậy BERT là gì? Tại sao cùng một từ nhưng BERT có thể hiểu nó khác nhau tùy theo câu? Và BERT đã thay đổi Natural Language Processing như thế nào?
1. BERT là gì?
BERT là viết tắt của Bidirectional Encoder Representations from Transformers.
BERT được giới thiệu bởi Google vào năm 2018 trong paper BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding.
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
BERT sử dụng kiến trúc Transformer Encoder để học biểu diễn ngôn ngữ.
Có thể hình dung:
Text
 │
 ▼
Tokenization
 │
 ▼
Token Embeddings
 │
 ▼
Transformer Encoder
 │
 ├── Self-Attention
 ├── Feed-Forward Network
 ├── Residual Connection
 └── Layer Normalization
 │
 ▼
Contextual Representation
Điểm quan trọng của BERT là mô hình có thể xem xét ngữ cảnh ở cả hai phía của một token trong quá trình xây dựng biểu diễn.
2. “Bidirectional” trong BERT nghĩa là gì?
Đây là một trong những điểm quan trọng nhất của BERT.
Hãy xét câu:
"The bank is near the river."
Từ “bank” có thể mang nhiều nghĩa khác nhau.
Trong câu trên, các từ “near” và “river” cung cấp thông tin giúp mô hình hiểu rằng “bank” đang liên quan đến bờ sông.
Ngược lại:
"I went to the bank to deposit money."
Trong câu này, “bank” lại mang nghĩa tổ chức tài chính.
BERT sử dụng context xung quanh token để xây dựng biểu diễn phù hợp với từng trường hợp.
"The bank is near the river."

        bank
       /    \
      /      \
   The       river
      \      /
       \    /
       Context
Do đó, cùng một từ có thể có biểu diễn khác nhau tùy vào ngữ cảnh.
3. BERT sử dụng Transformer như thế nào?
BERT sử dụng Transformer Encoder.
Khác với một mô hình Transformer Encoder-Decoder hoàn chỉnh, BERT chỉ sử dụng phần Encoder.
Transformer
│
├── Encoder
│
└── Decoder

BERT
│
└── Transformer Encoder
Encoder của BERT gồm nhiều Transformer Encoder Layer được xếp chồng lên nhau.
Mỗi layer chứa:
- Multi-Head Self-Attention.
- Feed-Forward Network.
- Residual Connection.
- Layer Normalization.
Nhờ nhiều layer, mô hình có thể xây dựng các biểu diễn ngày càng phức tạp của văn bản.
4. BERT đọc câu như thế nào?
Trước khi đưa văn bản vào Transformer, BERT cần chuyển văn bản thành các token.
Ví dụ:
"I love Machine Learning"
Có thể được chuyển thành các token tương ứng:
[I] [love] [Machine] [Learning]
Trong thực tế, BERT sử dụng phương pháp WordPiece Tokenization, nên một từ có thể được chia thành nhiều subword token.
Ví dụ minh họa:
unbelievable

→ un + ##believable
Cách tiếp cận subword giúp mô hình xử lý được nhiều từ khác nhau mà không cần một vocabulary chứa mọi dạng từ hoàn chỉnh.
5. Ba loại Embedding trong BERT
Input của BERT không chỉ đơn giản là token embedding.
Trong kiến trúc BERT gốc, biểu diễn đầu vào được tạo từ ba thành phần:
- Token Embeddings.
- Segment Embeddings.
- Position Embeddings.
Có thể hình dung:
Token Embedding
       +
Segment Embedding
       +
Position Embedding
       │
       ▼
BERT Input Representation
Token Embedding
Cho biết token hiện tại là gì.
Segment Embedding
Cho biết token thuộc câu nào trong những bài toán có nhiều câu đầu vào.
Position Embedding
Cung cấp thông tin về vị trí của token trong sequence.
6. Token [CLS] và [SEP] là gì?
BERT sử dụng một số special token để biểu diễn cấu trúc của input.
[CLS]
[CLS] được đặt ở đầu sequence.
[CLS] I love Machine Learning [SEP]
Biểu diễn của token [CLS] thường được sử dụng làm đại diện cho toàn bộ sequence trong nhiều bài toán classification.
[SEP]
[SEP] được sử dụng để đánh dấu kết thúc một câu hoặc phân tách các sequence.
Ví dụ:
[CLS] Sentence A [SEP] Sentence B [SEP]
Cách biểu diễn này đặc biệt hữu ích trong các bài toán cần xử lý quan hệ giữa hai câu.
7. Masked Language Modeling là gì?
Một trong những ý tưởng quan trọng nhất khi pretrain BERT là Masked Language Modeling (MLM).
Thay vì chỉ đọc một câu và dự đoán token tiếp theo, BERT sẽ che một số token trong câu và yêu cầu mô hình dự đoán chúng.
Ví dụ:
"The student studies [MASK] at university."
Mô hình cần dự đoán token bị che.
"The student studies [MASK] at university."

                    ↓

                "Data Science"
Để thực hiện nhiệm vụ này, mô hình cần sử dụng thông tin từ context xung quanh.
Đây là điểm rất quan trọng giúp BERT học biểu diễn ngôn ngữ dựa trên ngữ cảnh.
8. Vì sao Masked Language Modeling quan trọng?
Hãy xét:
"The company released a new [MASK] model."
Để dự đoán token bị che, mô hình có thể sử dụng nhiều thông tin:
- “company”.
- “released”.
- “new”.
- “model”.
Thay vì chỉ dựa vào những token đứng trước [MASK], mô hình có thể sử dụng context ở cả hai phía.
Điều này giúp BERT học được những biểu diễn ngôn ngữ giàu ngữ cảnh.
9. Next Sentence Prediction
BERT nguyên bản cũng sử dụng một nhiệm vụ pretraining khác là Next Sentence Prediction (NSP).
Mô hình nhận hai câu và dự đoán liệu câu thứ hai có phải câu tiếp theo của câu thứ nhất hay không.
Ví dụ:
Sentence A:
"I went to the library."

Sentence B:
"I borrowed a book."

→ Có thể là hai câu liên tiếp.
Hoặc:
Sentence A:
"I went to the library."

Sentence B:
"The stock market increased today."

→ Không phải hai câu liên tiếp.
NSP được sử dụng trong BERT gốc để học một số mối quan hệ giữa các câu.
Các nghiên cứu sau này đã xem xét và điều chỉnh cách pretraining này, cho thấy thiết kế nhiệm vụ pretraining có ảnh hưởng đáng kể đến hiệu quả của mô hình.
10. Pre-training và Fine-tuning
Một ý tưởng rất quan trọng của BERT là tách quá trình học thành hai giai đoạn:
- Pre-training.
- Fine-tuning.
Pre-training
Đầu tiên, mô hình được huấn luyện trên lượng dữ liệu văn bản lớn để học các biểu diễn ngôn ngữ tổng quát.
Large Text Dataset
        │
        ▼
   Pre-training
        │
        ▼
Pretrained BERT
Fine-tuning
Sau đó, mô hình được điều chỉnh cho một nhiệm vụ cụ thể.
Pretrained BERT
      │
      ▼
Fine-tuning
      │
      ├── Sentiment Analysis
      ├── Text Classification
      ├── Question Answering
      └── Named Entity Recognition
Đây là một ý tưởng quan trọng trong Deep Learning hiện đại: một mô hình được pretrained có thể được sử dụng làm nền tảng cho nhiều nhiệm vụ khác nhau.
11. BERT được ứng dụng vào đâu?
Sentiment Analysis
BERT có thể được fine-tune để phân loại cảm xúc của một câu hoặc một đoạn văn.
"This product is amazing!"

        ↓

      BERT

        ↓

    Positive
Text Classification
Ví dụ phân loại:
- Email spam / không spam.
- Tin tức theo chủ đề.
- Phản hồi khách hàng.
- Ticket hỗ trợ.
Named Entity Recognition
BERT có thể được sử dụng để nhận diện các thực thể trong văn bản:
"Bùi Đình Tuyển học tại Hà Nội."

Bùi Đình Tuyển → PERSON
Hà Nội         → LOCATION
Question Answering
Mô hình có thể được fine-tune để tìm câu trả lời trong một đoạn văn dựa trên câu hỏi.
12. BERT khác GPT như thế nào?
| Đặc điểm | BERT | GPT |
|---|---|---|
| Kiến trúc chính | Transformer Encoder | Transformer Decoder |
| Context | Hai chiều trong biểu diễn | Autoregressive, dựa trên token trước đó khi sinh |
| Mục tiêu tiêu biểu | Hiểu và biểu diễn ngôn ngữ | Sinh văn bản |
| Pretraining tiêu biểu | Masked Language Modeling | Next-token prediction |
| Ứng dụng | Classification, NER, QA… | Text generation, completion… |
Cần lưu ý rằng đây là sự khác biệt ở kiến trúc và mục tiêu training của các dòng mô hình; các hệ thống hiện đại có thể được mở rộng và điều chỉnh theo nhiều cách khác nhau.
13. BERT có thể hiểu ngôn ngữ như con người không?
BERT có thể học được nhiều pattern phức tạp từ dữ liệu văn bản, nhưng không nên hiểu điều này theo nghĩa mô hình có khả năng hiểu ngôn ngữ giống con người.
Mô hình học các biểu diễn và mối quan hệ thống kê từ dữ liệu thông qua quá trình training.
Ví dụ, BERT có thể học rằng:
"Paris" thường liên quan đến "France"

"doctor" thường xuất hiện trong những
ngữ cảnh khác với "football"
Nhưng cách mô hình tạo ra các biểu diễn này dựa trên quá trình tối ưu hóa mạng neural và dữ liệu training, không phải trải nghiệm thế giới theo cách con người có.
14. Hạn chế của BERT
BERT có nhiều ứng dụng nhưng cũng có một số hạn chế.
Không được thiết kế chủ yếu để sinh văn bản dài
Kiến trúc Encoder của BERT phù hợp với việc xây dựng biểu diễn và thực hiện các nhiệm vụ hiểu ngôn ngữ hơn là autoregressive generation.
Chi phí tính toán
Self-Attention có chi phí tăng đáng kể khi sequence trở nên dài.
Phụ thuộc vào dữ liệu pretraining
Chất lượng biểu diễn mà BERT học được phụ thuộc vào dữ liệu và cách mô hình được pretrained.
Không phải mọi bài toán NLP đều cần BERT
Với những nhiệm vụ đơn giản, các phương pháp nhẹ hơn có thể đã đủ đáp ứng yêu cầu.
15. BERT đã thay đổi NLP như thế nào?
Trước thời kỳ của các mô hình pretrained Transformer, nhiều bài toán NLP thường cần xây dựng hoặc huấn luyện mô hình riêng cho từng nhiệm vụ.
BERT góp phần phổ biến một cách tiếp cận khác:
Dữ liệu lớn
    ↓
Pre-training
    ↓
Mô hình ngôn ngữ pretrained
    ↓
Fine-tuning
    ↓
Nhiều nhiệm vụ NLP
Điều này trở thành một trong những nền tảng quan trọng của xu hướng pretrained models và sau đó phát triển mạnh hơn thành các mô hình nền tảng và Large Language Models.
16. Tổng kết
BERT là một mô hình ngôn ngữ dựa trên Transformer Encoder, được thiết kế để học biểu diễn ngôn ngữ có tính ngữ cảnh.
Những khái niệm quan trọng cần nhớ:
- Transformer Encoder: kiến trúc nền tảng của BERT.
- Bidirectional: sử dụng context hai phía khi xây dựng biểu diễn.
- WordPiece: phương pháp tokenization dựa trên subword.
- [CLS]: special token thường dùng làm đại diện cho sequence.
- [SEP]: đánh dấu ranh giới sequence.
- Masked Language Modeling: che một số token và dự đoán chúng.
- Pre-training: học biểu diễn ngôn ngữ từ dữ liệu lớn.
- Fine-tuning: điều chỉnh mô hình cho nhiệm vụ cụ thể.
Có thể ghi nhớ BERT bằng một câu:
BERT sử dụng Transformer Encoder để học cách biểu diễn từ và câu dựa trên ngữ cảnh, sau đó có thể được fine-tune cho nhiều bài toán NLP.
Ở bài tiếp theo, chúng ta sẽ đi theo hướng còn lại của Transformer: GPT là gì? – cách mô hình dự đoán token tiếp theo và từng bước tạo ra văn bản.
Tài liệu tham khảo
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
Hugging Face – BERT Documentation
Attention Is All You Need
🚀 Học Data Science & AI cùng MCNA Technology School
Nếu bạn muốn xây dựng nền tảng từ Python, Data Analysis đến AI và Machine Learning, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Minh Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu