Trong Machine Learning, không phải bộ dữ liệu nào cũng có sẵn nhãn để mô hình học cách dự đoán. Doanh nghiệp có thể sở hữu hàng triệu giao dịch, thông tin khách hàng hoặc dữ liệu hành vi nhưng chưa biết những quan sát đó thuộc nhóm nào, có đặc điểm chung gì hoặc tồn tại cấu trúc tiềm ẩn nào.
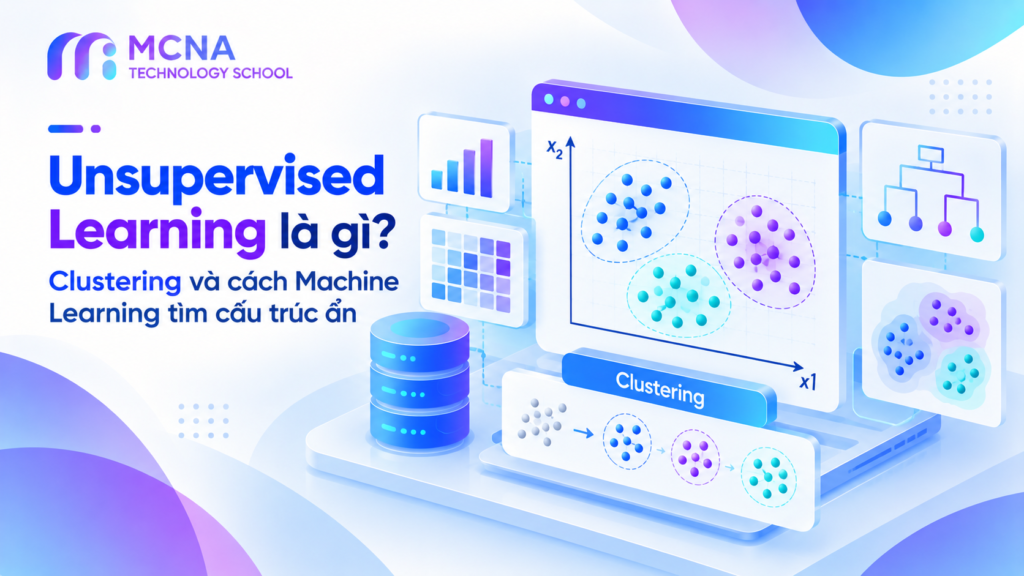
Unsupervised Learning là cách tiếp cận Machine Learning giúp khám phá các mẫu, mối quan hệ và cấu trúc trong dữ liệu mà không cần nhãn mục tiêu được cung cấp trong quá trình huấn luyện. Một trong những ứng dụng quan trọng nhất là Clustering, tức phân nhóm những quan sát có đặc điểm tương đồng.
Bài viết sẽ giải thích bản chất của Unsupervised Learning, sự khác biệt với Supervised Learning, cách Clustering hoạt động, các thuật toán phổ biến như K-Means, Hierarchical Clustering và DBSCAN, đồng thời hướng dẫn triển khai bằng Python.
1. Unsupervised Learning là gì?
Unsupervised Learning (học không giám sát) là nhóm phương pháp Machine Learning học từ dữ liệu không có nhãn mục tiêu để khám phá cấu trúc, biểu diễn hoặc quy luật có trong dữ liệu.
Trong Supervised Learning, mô hình học mối quan hệ giữa Features (X) và Label (y). Ngược lại, Unsupervised Learning thường chỉ nhận Features (X), sau đó tìm ra những đặc điểm có ý nghĩa theo mục tiêu và giả định của thuật toán.
1.1. Ví dụ về Unsupervised Learning
Giả sử một cửa hàng có dữ liệu khách hàng gồm:
- Tuổi khách hàng.
- Tổng số tiền đã chi tiêu.
- Số lần mua hàng.
- Giá trị trung bình mỗi đơn hàng.
- Thời gian kể từ lần mua gần nhất.
Cửa hàng chưa có nhãn xác định khách hàng thuộc nhóm nào. Một thuật toán Clustering có thể phân chia dữ liệu thành các cụm dựa trên mức độ tương đồng về hành vi.
Sau khi phân tích, chuyên viên Data Analyst có thể diễn giải các cụm thành những nhóm như khách hàng mua thường xuyên, khách hàng có giá trị đơn hàng cao hoặc khách hàng ít hoạt động. Đây là các tên gọi do người phân tích đặt dựa trên đặc điểm quan sát được, không phải nhãn có sẵn mà thuật toán tự hiểu theo ý nghĩa kinh doanh.
1.2. Bản chất của việc học không có nhãn
Không có nhãn không có nghĩa là mô hình học hoàn toàn không có mục tiêu. Mỗi thuật toán Unsupervised Learning vẫn tối ưu một tiêu chí cụ thể.
- K-Means cố gắng giảm tổng bình phương khoảng cách từ các điểm đến tâm cụm tương ứng.
- DBSCAN tìm các vùng có mật độ điểm đủ cao và kết nối chúng thành cụm.
- PCA tìm các hướng biểu diễn dữ liệu giữ lại nhiều phương sai nhất theo những ràng buộc nhất định.
Điều quan trọng là các tiêu chí toán học này không tự bảo đảm rằng cấu trúc tìm được sẽ hữu ích về mặt kinh doanh. Việc đánh giá và diễn giải vẫn cần kiến thức chuyên môn về dữ liệu.
2. So sánh Supervised Learning và Unsupervised Learning
| Tiêu chí | Supervised Learning | Unsupervised Learning |
|---|---|---|
| Dữ liệu đầu vào | Features và Labels | Thường chỉ có Features |
| Mục tiêu | Dự đoán nhãn hoặc giá trị mục tiêu | Khám phá cấu trúc, biểu diễn hoặc quan hệ trong dữ liệu |
| Bài toán phổ biến | Classification, Regression | Clustering, Dimensionality Reduction |
| Thuật toán ví dụ | Logistic Regression, Decision Tree, Random Forest, SVM | K-Means, DBSCAN, Hierarchical Clustering, PCA |
| Đánh giá | Có thể so sánh dự đoán với nhãn thực tế | Thường dùng tiêu chí nội tại, độ ổn định và mức độ hữu ích của cấu trúc tìm được |
Hai cách tiếp cận không loại trừ lẫn nhau. Trong một hệ thống Machine Learning thực tế, có thể sử dụng Unsupervised Learning để khám phá dữ liệu hoặc tạo đặc trưng trước khi xây dựng mô hình Supervised Learning. Tuy nhiên, mọi bước tiền xử lý hoặc học biểu diễn phải được thiết kế để tránh Data Leakage.
3. Những nhóm bài toán chính của Unsupervised Learning
Unsupervised Learning không chỉ bao gồm Clustering. Có nhiều hướng tiếp cận tùy thuộc vào cấu trúc mà chúng ta muốn khám phá.
3.1. Clustering – Phân cụm dữ liệu
Clustering chia các quan sát thành những nhóm dựa trên một khái niệm tương đồng hoặc mật độ do thuật toán xác định. Mục tiêu thường là các điểm trong cùng một cụm có đặc điểm gần nhau hơn so với các điểm thuộc những cụm khác, mặc dù không phải mọi thuật toán Clustering đều sử dụng cùng định nghĩa khoảng cách.
Ví dụ: phân nhóm khách hàng theo hành vi mua sắm, phân nhóm sản phẩm theo đặc trưng hoặc khám phá các kiểu sử dụng dịch vụ.
3.2. Dimensionality Reduction – Giảm số chiều dữ liệu
Dimensionality Reduction tìm cách biểu diễn dữ liệu bằng số lượng chiều ít hơn, đồng thời cố gắng giữ lại những thông tin hoặc cấu trúc quan trọng theo tiêu chí của phương pháp.
Ví dụ, dữ liệu có hàng trăm Features có thể được biến đổi thành một số thành phần chính bằng PCA. Những thành phần này là tổ hợp của các Features ban đầu, không nhất thiết có ý nghĩa trực tiếp như từng Feature gốc.
3.3. Anomaly Detection – Phát hiện bất thường
Một số phương pháp học không giám sát có thể phát hiện những quan sát khác biệt đáng kể so với cấu trúc phổ biến của dữ liệu.
Ví dụ, trong dữ liệu giao dịch, một giao dịch có hành vi rất khác thường có thể được đánh dấu để kiểm tra. Tuy nhiên, một quan sát bất thường không đồng nghĩa với gian lận, và một giao dịch gian lận cũng không nhất thiết có biểu hiện bất thường theo mô hình.
4. Clustering hoạt động như thế nào?
Clustering là một trong những bài toán trực quan nhất của Unsupervised Learning. Thay vì học từ nhãn đã có, thuật toán sử dụng cấu trúc của Features để xác định những nhóm dữ liệu.
4.1. Trực giác về sự tương đồng
Giả sử mỗi khách hàng được biểu diễn bằng hai Features: tần suất mua hàng và tổng chi tiêu. Mỗi khách hàng trở thành một điểm trong không gian hai chiều.
Những khách hàng có tần suất mua và mức chi tiêu tương tự nhau có thể nằm gần nhau. Clustering sử dụng thông tin này để xác định các nhóm có cấu trúc phù hợp với thuật toán.
Dữ liệu khách hàng chưa có nhãn
                |
                v
        Lựa chọn Features
                |
                v
      Làm sạch và chuẩn hóa
                |
                v
      Lựa chọn thuật toán
                |
                v
         Thực hiện Clustering
                |
                v
        Đánh giá các cụm
                |
                v
      Phân tích đặc điểm cụm
                |
                v
    Diễn giải và ứng dụng thực tế
4.2. Khoảng cách có vai trò gì?
Nhiều thuật toán Clustering dựa trên khoảng cách giữa các điểm dữ liệu. Một thước đo phổ biến là Euclidean Distance.
Với hai điểm X và Y có d Features, khoảng cách Euclidean được xác định bởi:
d(X, Y) = sqrt(Σ(X_j - Y_j)²), trong đó j chạy từ 1 đến d.
Khoảng cách này phản ánh mức độ khác biệt giữa hai điểm trong không gian đặc trưng. Tuy nhiên, nếu Features có thang đo rất khác nhau, kết quả có thể bị chi phối bởi những Features có giá trị số lớn.
Vì vậy, Feature Scaling thường là bước quan trọng trước khi áp dụng các thuật toán Clustering dựa trên khoảng cách.
5. K-Means Clustering là gì?
K-Means là thuật toán Clustering phổ biến, phân chia dữ liệu thành K cụm. Mỗi cụm được đại diện bởi một điểm trung tâm gọi là Centroid.
Thuật toán cố gắng tìm cách phân cụm sao cho tổng bình phương khoảng cách từ các điểm dữ liệu đến Centroid của cụm tương ứng là nhỏ nhất.
5.1. Các bước hoạt động của K-Means
- Chọn số cụm K.
- Khởi tạo K Centroids.
- Gán mỗi điểm dữ liệu vào Centroid gần nhất.
- Tính lại Centroid bằng trung bình của các điểm thuộc cụm.
- Lặp lại quá trình gán điểm và cập nhật Centroid cho đến khi thỏa điều kiện dừng.
          Chọn K
             |
             v
      Khởi tạo Centroids
             |
             v
     Gán điểm vào cụm gần nhất
             |
             v
       Cập nhật Centroids
             |
             v
       Đã hội tụ hoặc đạt
       điều kiện dừng?
          /       \
        Chưa       Rồi
         |          |
         +-- Lặp    v
                Kết quả Clustering
5.2. Hàm mục tiêu của K-Means
K-Means thường tối thiểu hóa đại lượng gọi là Inertia, hay Within-Cluster Sum of Squares (WCSS):
WCSS = Σ ||x_i - μ_(c_i)||²
Trong đó:
x_ilà quan sát thứ i.c_ilà cụm được gán cho quan sát thứ i.μ_(c_i)là Centroid của cụm tương ứng.
Giá trị WCSS càng nhỏ cho thấy các điểm càng gần Centroid của cụm được gán theo thước đo đang sử dụng. Tuy nhiên, WCSS luôn có xu hướng giảm hoặc không tăng khi số cụm K tăng, vì vậy không thể chỉ chọn K dựa trên WCSS nhỏ nhất.
5.3. K-Means có những hạn chế gì?
- Phải lựa chọn số cụm K trước khi chạy thuật toán.
- Kết quả có thể phụ thuộc vào cách khởi tạo Centroids.
- Nhạy với Outliers vì sử dụng trung bình và khoảng cách bình phương.
- Thường phù hợp hơn với các cụm tương đối gọn và có hình dạng gần lồi trong không gian đặc trưng.
- Có thể hoạt động kém khi các cụm có hình dạng phức tạp, mật độ hoặc kích thước rất khác nhau.
Những hạn chế này là lý do cần tìm hiểu thêm các phương pháp Clustering khác thay vì mặc định sử dụng K-Means cho mọi bài toán.
6. Hierarchical Clustering là gì?
Hierarchical Clustering là nhóm phương pháp xây dựng cấu trúc phân cấp giữa các quan sát hoặc cụm dữ liệu.
Với Agglomerative Hierarchical Clustering, thuật toán bắt đầu bằng cách xem mỗi quan sát là một cụm riêng biệt, sau đó liên tục gộp những cụm phù hợp theo tiêu chí liên kết (Linkage).
6.1. Cơ chế hoạt động
- Khởi tạo mỗi điểm dữ liệu thành một cụm.
- Tính mức độ khác biệt giữa các cụm.
- Gộp hai cụm phù hợp nhất theo Linkage đã chọn.
- Cập nhật quan hệ giữa các cụm.
- Lặp lại để tạo cấu trúc phân cấp.
Kết quả có thể được biểu diễn bằng Dendrogram, một sơ đồ cây thể hiện thứ tự và mức độ khác biệt tại những lần gộp cụm.
6.2. Các phương pháp Linkage
| Linkage | Nguyên tắc |
|---|---|
| Single Linkage | Dựa trên khoảng cách nhỏ nhất giữa hai điểm thuộc hai cụm. |
| Complete Linkage | Dựa trên khoảng cách lớn nhất giữa hai điểm thuộc hai cụm. |
| Average Linkage | Dựa trên khoảng cách trung bình giữa các cặp điểm thuộc hai cụm. |
| Ward Linkage | Chọn cách gộp làm tăng tổng bình phương sai lệch trong cụm ít nhất. |
Hierarchical Clustering hữu ích khi muốn khám phá cấu trúc phân cấp hoặc phân tích dữ liệu ở nhiều mức độ chi tiết. Tuy nhiên, với tập dữ liệu lớn, chi phí bộ nhớ và tính toán có thể là hạn chế đáng kể.
7. DBSCAN là gì?
DBSCAN (Density-Based Spatial Clustering of Applications with Noise) là thuật toán Clustering dựa trên mật độ dữ liệu.
Khác với K-Means, DBSCAN không yêu cầu xác định trước số cụm K. Thuật toán tìm những vùng có đủ nhiều điểm gần nhau, kết nối các vùng có mật độ phù hợp và có thể đánh dấu một số điểm là Noise.
7.1. Hai tham số quan trọng
- eps: Bán kính vùng lân cận được sử dụng để xét mật độ.
- min_samples: Số lượng điểm tối thiểu trong vùng lân cận, tính cả chính điểm đang xét theo cách triển khai của scikit-learn, để một điểm được xem là Core Point.
7.2. Core Point, Border Point và Noise
DBSCAN phân biệt ba dạng điểm:
- Core Point: Điểm có đủ số lượng quan sát trong vùng lân cận eps.
- Border Point: Điểm không đủ điều kiện làm Core Point nhưng nằm trong vùng lân cận của một Core Point.
- Noise Point: Điểm không được gán vào cụm theo quy tắc kết nối mật độ của thuật toán.
DBSCAN có thể nhận diện những cụm có hình dạng phức tạp mà K-Means khó mô hình hóa. Tuy nhiên, nếu dữ liệu có các vùng mật độ rất khác nhau, một bộ tham số eps và min_samples có thể không phù hợp cho tất cả cụm.
8. So sánh K-Means, Hierarchical Clustering và DBSCAN
| Tiêu chí | K-Means | Hierarchical Clustering | DBSCAN |
|---|---|---|---|
| Cơ chế | Dựa trên Centroids | Dựa trên cấu trúc phân cấp và Linkage | Dựa trên mật độ |
| Số cụm | Cần chọn K | Có thể chọn mức cắt phân cấp | Không cần chọn K trước |
| Hình dạng cụm | Phù hợp hơn với cụm tương đối gọn | Phụ thuộc Linkage và Metric | Có thể tìm cụm hình dạng phức tạp |
| Outliers | Nhạy với Outliers | Phụ thuộc phương pháp Linkage | Có khả năng đánh dấu Noise |
| Khả năng mở rộng | Thường thuận lợi với dữ liệu lớn | Có thể tốn bộ nhớ và tính toán | Phụ thuộc cấu trúc dữ liệu, tham số và cách tìm lân cận |
Không có thuật toán Clustering nào luôn tốt nhất. Việc lựa chọn phụ thuộc vào hình dạng cụm, số chiều, quy mô dữ liệu, tỷ lệ nhiễu và mục tiêu phân tích.
9. Làm thế nào để biết Clustering có tốt không?
Trong Supervised Learning, chúng ta thường so sánh dự đoán với nhãn thực tế. Với Clustering, nhãn chuẩn thường không có sẵn, nên đánh giá cần kết hợp tiêu chí định lượng và kiến thức chuyên môn.
9.1. Elbow Method
Elbow Method thường được sử dụng với K-Means. Phương pháp chạy thuật toán với nhiều giá trị K và quan sát sự thay đổi của WCSS.
Khi tăng K, WCSS có xu hướng giảm. Người phân tích tìm một vùng mà việc tăng thêm số cụm chỉ đem lại mức cải thiện nhỏ hơn rõ rệt so với trước đó, thường gọi là điểm khuỷu tay (Elbow).
Tuy nhiên, không phải dữ liệu nào cũng có Elbow rõ ràng. Đây là phương pháp hỗ trợ lựa chọn K, không phải bằng chứng tuyệt đối về số cụm đúng.
9.2. Silhouette Score
Silhouette Score đánh giá mức độ một quan sát phù hợp với cụm của chính nó so với cụm gần nhất khác.
Với một điểm dữ liệu i, Silhouette Coefficient được tính bằng:
s(i) = (b(i) - a(i)) / max(a(i), b(i))
Trong đó:
a(i)là khoảng cách trung bình từ điểm i đến các điểm khác trong cùng cụm.b(i)là khoảng cách trung bình nhỏ nhất từ điểm i đến các điểm thuộc một cụm khác.
Giá trị Silhouette thường nằm trong khoảng từ -1 đến 1. Giá trị cao hơn thường cho thấy điểm được gán phù hợp hơn với cụm của nó so với cụm gần nhất khác. Giá trị âm cho thấy điểm có thể gần một cụm khác hơn theo thước đo đang sử dụng.
Silhouette Score không áp dụng cho mọi tình huống, chẳng hạn khi chỉ có một cụm. Nó cũng có thể ưu tiên những cấu trúc cụm nhất định và không bảo đảm các cụm có ý nghĩa kinh doanh.
9.3. Đánh giá mức độ hữu ích của cụm
Trong thực tế, một kết quả Clustering có Silhouette Score tương đối cao nhưng vẫn có thể khó sử dụng nếu các cụm không thể diễn giải hoặc không tạo ra sự khác biệt có ý nghĩa.
Với bài toán phân khúc khách hàng, nên kiểm tra:
- Các cụm có khác biệt rõ về hành vi hoặc đặc điểm không?
- Kích thước từng cụm có phù hợp với mục tiêu phân tích không?
- Cấu trúc cụm có ổn định khi dữ liệu hoặc tham số thay đổi không?
- Doanh nghiệp có thể sử dụng kết quả để hỗ trợ quyết định hay không?
10. Thực hành Clustering bằng Python
Chúng ta sẽ sử dụng bộ dữ liệu Iris trong scikit-learn để thực hành K-Means. Iris có các đặc trưng đo lường hoa và có nhãn loài, nhưng trong ví dụ này nhãn không được sử dụng để huấn luyện thuật toán. Điều này cho phép minh họa đúng quy trình Unsupervised Learning.
10.1. Cài đặt thư viện
pip install numpy pandas matplotlib scikit-learn10.2. Huấn luyện K-Means
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.datasets import load_iris
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

# 1. Tải dữ liệu
iris = load_iris()
X = pd.DataFrame(
    iris.data,
    columns=iris.feature_names
)

# Không sử dụng iris.target khi huấn luyện

# 2. Chuẩn hóa dữ liệu
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 3. Khởi tạo K-Means
model = KMeans(
    n_clusters=3,
    random_state=42,
    n_init=10
)

# 4. Huấn luyện và lấy nhãn cụm
clusters = model.fit_predict(X_scaled)

# 5. Đánh giá
score = silhouette_score(
    X_scaled,
    clusters
)

print("Silhouette Score:", score)
print("Inertia:", model.inertia_)

# 6. Gắn kết quả vào DataFrame
result = X.copy()
result["Cluster"] = clusters

print(result.head())

# 7. Trực quan hóa bằng hai Features gốc
plt.figure(figsize=(8, 5))

plt.scatter(
    result.iloc[:, 2],
    result.iloc[:, 3],
    c=result["Cluster"],
    cmap="viridis"
)

plt.xlabel(iris.feature_names[2])
plt.ylabel(iris.feature_names[3])
plt.title("K-Means Clustering on Iris Dataset")
plt.colorbar(label="Cluster")
plt.show()
10.3. Giải thích đoạn mã
load_iris(): Tải dữ liệu mẫu Iris.StandardScaler(): Chuẩn hóa các Features để giảm ảnh hưởng của sự khác biệt thang đo.KMeans(n_clusters=3): Yêu cầu thuật toán tìm ba cụm.random_state=42: Cố định nguồn ngẫu nhiên để hỗ trợ tái lập kết quả.n_init=10: Chạy K-Means với nhiều lần khởi tạo và chọn kết quả tốt nhất theo Inertia.fit_predict(): Huấn luyện mô hình và trả về nhãn cụm của các quan sát.silhouette_score(): Đánh giá mức độ gắn kết và phân tách của các cụm.model.inertia_: Trả về tổng bình phương khoảng cách đến Centroids trên dữ liệu đã dùng để fit.
Biểu đồ chỉ sử dụng hai Features gốc để trực quan hóa, trong khi K-Means được huấn luyện trên toàn bộ bốn Features đã chuẩn hóa. Vì vậy, các điểm có vẻ chồng lấn trên biểu đồ hai chiều không nhất thiết có cấu trúc giống hệt trong không gian bốn chiều.
Giá trị K = 3 trong ví dụ là lựa chọn để minh họa, không phải kết luận rằng ba cụm là tối ưu. Cũng không nên mặc định các cụm tìm được tương ứng hoàn toàn với ba loài hoa thực tế.
10.4. Thử nhiều giá trị K
Để nghiên cứu ảnh hưởng của số cụm, có thể thử các giá trị K khác nhau và so sánh Silhouette Score.
scores = []

for k in range(2, 9):
    model_k = KMeans(
        n_clusters=k,
        random_state=42,
        n_init=10
    )

    labels = model_k.fit_predict(X_scaled)

    score = silhouette_score(
        X_scaled,
        labels
    )

    scores.append({
        "K": k,
        "Silhouette": score
    })

scores_df = pd.DataFrame(scores)

print(scores_df)

plt.figure(figsize=(8, 5))
plt.plot(
    scores_df["K"],
    scores_df["Silhouette"],
    marker="o"
)

plt.xlabel("Number of Clusters (K)")
plt.ylabel("Silhouette Score")
plt.title("Silhouette Score by Number of Clusters")
plt.show()
Đoạn mã cho phép quan sát chất lượng phân cụm theo tiêu chí Silhouette. Tuy nhiên, lựa chọn K cuối cùng vẫn cần xem xét cấu trúc dữ liệu, khả năng diễn giải và mục tiêu sử dụng.
11. Những sai lầm phổ biến khi sử dụng Unsupervised Learning
11.1. Cho rằng thuật toán tự tìm ra nhóm đúng
Clustering tìm các nhóm theo tiêu chí toán học đã xác định, không phải theo một khái niệm đúng tuyệt đối. Hai thuật toán khác nhau có thể tạo ra các cụm khác nhau trên cùng dữ liệu, và cả hai đều có thể hợp lý theo những mục tiêu riêng.
11.2. Bỏ qua Feature Scaling
Với thuật toán dựa trên khoảng cách, Features có thang đo lớn có thể chi phối kết quả. Cần kiểm tra đơn vị đo, phân phối dữ liệu và lựa chọn phương pháp chuẩn hóa phù hợp trước khi Clustering.
11.3. Sử dụng quá nhiều Features không liên quan
Thêm nhiều Features không bảo đảm phân cụm tốt hơn. Những Features nhiễu, trùng lặp hoặc không liên quan có thể làm giảm ý nghĩa của khoảng cách và khiến các cụm khó diễn giải.
11.4. Diễn giải nhãn cụm như nhãn thực tế
Nhãn cụm như 0, 1, 2 chỉ là mã định danh do thuật toán tạo ra. Chúng không mang ý nghĩa thứ tự hay giá trị kinh doanh cố định. Khi chạy lại thuật toán, mã cụm có thể thay đổi ngay cả khi cấu trúc phân nhóm tương đương.
11.5. Chỉ dựa vào một chỉ số đánh giá
Silhouette Score, Inertia và các chỉ số nội tại khác cung cấp những góc nhìn hữu ích, nhưng không thay thế được việc kiểm tra tính ổn định, đặc điểm từng cụm và giá trị thực tiễn.
12. Khi nào nên sử dụng Unsupervised Learning?
Unsupervised Learning đặc biệt hữu ích trong giai đoạn khám phá dữ liệu, khi chưa có nhãn mục tiêu hoặc khi muốn tìm hiểu cấu trúc dữ liệu trước khi xây dựng các hệ thống dự đoán.
- Customer Segmentation: Phân nhóm khách hàng dựa trên hành vi và đặc điểm để hỗ trợ chiến lược chăm sóc khách hàng.
- Product Analysis: Khám phá các nhóm sản phẩm có đặc trưng tương đồng.
- Anomaly Detection: Tìm các quan sát khác thường để phục vụ kiểm tra chuyên sâu.
- Exploratory Data Analysis: Khám phá cấu trúc tiềm ẩn trước khi lựa chọn mô hình hoặc giả thuyết phân tích.
- Dimensionality Reduction: Giảm số chiều để trực quan hóa, nén biểu diễn hoặc hỗ trợ các bước phân tích tiếp theo.
Khi triển khai trong doanh nghiệp, nên kết hợp kết quả thuật toán với kiến thức chuyên môn, quy trình đánh giá và kiểm tra tác động thực tế thay vì coi Clustering là kết luận cuối cùng.
13. Kết luận
Unsupervised Learning giúp Machine Learning khám phá cấu trúc dữ liệu mà không cần nhãn mục tiêu trong quá trình huấn luyện. Khác với Supervised Learning tập trung vào dự đoán, Unsupervised Learning thường hướng đến việc tìm nhóm, học biểu diễn hoặc phát hiện những cấu trúc đáng chú ý.
Trong đó, Clustering là một hướng ứng dụng quan trọng. K-Means phân cụm dựa trên Centroids, Hierarchical Clustering xây dựng cấu trúc phân cấp, còn DBSCAN xác định cụm dựa trên mật độ và có thể đánh dấu Noise.
Điều cần ghi nhớ là một kết quả Clustering tốt không chỉ thể hiện qua chỉ số toán học. Kết quả đó còn cần có tính ổn định, khả năng diễn giải và phù hợp với mục tiêu sử dụng dữ liệu.
Hiểu được những nguyên lý này sẽ giúp người học tiếp cận các chủ đề chuyên sâu hơn như K-Means Optimization, Dimensionality Reduction, PCA, Density-Based Clustering và Anomaly Detection một cách có hệ thống.
14. Tài liệu tham khảo
- scikit-learn. Clustering. Tài liệu chính thức về các thuật toán Clustering. https://scikit-learn.org/stable/modules/clustering.html
- scikit-learn. KMeans. Tài liệu API và các tham số của K-Means. https://scikit-learn.org/stable/modules/generated/sklearn.cluster.KMeans.html
- scikit-learn. DBSCAN. Tài liệu API về Density-Based Clustering. https://scikit-learn.org/stable/modules/generated/sklearn.cluster.DBSCAN.html
- scikit-learn. Silhouette Coefficient. Tài liệu về đánh giá chất lượng Clustering. https://scikit-learn.org/stable/modules/generated/sklearn.metrics.silhouette_score.html
- scikit-learn. Principal Component Analysis (PCA). Tài liệu về giảm số chiều dữ liệu. https://scikit-learn.org/stable/modules/decomposition.html#pca
- MacQueen, J. (1967). Some Methods for Classification and Analysis of Multivariate Observations. Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability. Công trình nghiên cứu về K-Means
- Ester, M., Kriegel, H.-P., Sander, J., & Xu, X. (1996). A Density-Based Algorithm for Discovering Clusters in Large Spatial Databases with Noise. Proceedings of KDD. Công trình nghiên cứu DBSCAN
15. Học thêm Data, AI và Machine Learning tại MCNA
Nếu bạn muốn xây dựng nền tảng về Python, phân tích dữ liệu và ứng dụng AI trong công việc, có thể tham khảo các chương trình học tại MCNA Technology School:
- Combo 5 khóa AI & Power BI: Tìm hiểu chương trình học AI & Power BI
- Combo Python: Tìm hiểu chương trình học Python
Tác giả
Nguyễn Quốc Hải – Data Analyst tại MCNA Technology School
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp lớn như Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
🌐 Website: mcna.vn
📘 Facebook: facebook.com/mcnatechnologyschool
▶️ YouTube: youtube.com/@mcna.technology.school
💼 LinkedIn: linkedin.com/company/mcna-vn
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B, TT2, Văn Quán, Hà Đông
📍 TP.HCM: The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu