🪟 CÙNG MỘT BẢNG, HAI CÁCH TÍNH
GROUP BY
gộp 16 dòng thành 4 dòng
| chi_nhanh | tong |
|---|---|
| Hà Nội | 1.760 |
| Hải Phòng | 1.510 |
| Đà Nẵng | 1.150 |
| TP.HCM | 2.030 |
✕ Mất chi tiết từng tháng
Window function
giữ đủ 16 dòng, thêm cột mới
| chi_nhanh | thang | doanh_thu | luy_ke |
|---|---|---|---|
| Hà Nội | 07/2026 | 420 | 420 |
| Hà Nội | 08/2026 | 450 | 870 |
| Hà Nội | 09/2026 | 410 | 1.280 |
| … | … | … | … |
✓ Vừa có chi tiết, vừa có số tổng hợp
Sếp hỏi: “Xếp hạng chi nhánh theo doanh thu tháng này, so với tháng trước tăng bao nhiêu phần trăm, và mỗi chi nhánh chiếm bao nhiêu tỷ trọng?”. Nếu chỉ dùng GROUP BY, bạn sẽ phải viết vài câu truy vấn con, nối bảng với chính nó, hoặc xuất ra Excel để tính tiếp.
Window function giải quyết cả ba việc trong một câu SQL gọn gàng. Bài viết này giải thích window function trong SQL là gì, cách đọc cú pháp OVER (PARTITION BY ... ORDER BY ...), rồi đi qua 6 hàm Data Analyst dùng mỗi ngày với cùng một bộ dữ liệu mẫu, kèm kết quả để bạn đối chiếu.
📂 NỘI DUNG BÀI VIẾT
- Window function là gì?
- Dữ liệu mẫu dùng trong bài
- Hàm 1: ROW_NUMBER – Đánh số thứ tự và lấy dòng đầu tiên
- Hàm 2: RANK và DENSE_RANK – Xếp hạng có đồng hạng
- Hàm 3: LAG và LEAD – So với kỳ trước
- Hàm 4 và 5: SUM OVER và AVG OVER – Lũy kế và trung bình trượt
- Hàm 6: SUM OVER không ORDER BY – Tỷ trọng trong tổng
- 5 lỗi thường gặp khi dùng window function
- Câu hỏi thường gặp về window function
- Kết luận
Window function là gì?
Window function (hàm cửa sổ) là hàm tính toán trên một nhóm dòng có liên quan đến dòng hiện tại, nhưng vẫn giữ nguyên từng dòng trong kết quả. “Cửa sổ” chính là nhóm dòng mà hàm được phép nhìn vào khi tính cho mỗi dòng.
Khác gì GROUP BY?
- GROUP BY gộp nhiều dòng thành một. 16 dòng doanh thu của 4 chi nhánh sau khi GROUP BY theo chi nhánh chỉ còn 4 dòng.
- Window function tính toán trên nhóm nhưng không gộp. Vẫn đủ 16 dòng, mỗi dòng có thêm một cột mới như thứ hạng, doanh thu tháng trước hay tổng lũy kế.
Nhờ vậy bạn vừa thấy chi tiết từng dòng, vừa thấy con số so sánh với cả nhóm, đúng kiểu bảng mà báo cáo thường cần.
Cú pháp cơ bản
PARTITION BY
giống GROUP BY nhưng không gộp dòng. Mỗi chi nhánh là một cửa sổ riêng. Bỏ đi thì cả bảng là một cửa sổ.
ORDER BY
sắp xếp dòng trong cửa sổ, bắt buộc với các hàm xếp hạng và LAG/LEAD.
ROWS BETWEEN
giới hạn cửa sổ vào một số dòng nhất định, dùng cho lũy kế và trung bình trượt.
Các ví dụ trong bài viết cho SQL Server, và chạy được gần như nguyên văn trên PostgreSQL, MySQL 8 và BigQuery.
Dữ liệu mẫu dùng trong bài
Bảng DoanhThu gồm 3 cột: chi_nhanh, thang và doanh_thu (triệu đồng, cột tháng lưu ngày đầu tháng như 2026-10-01), 16 dòng cho 4 chi nhánh trong 4 tháng. Để dễ nhìn, dưới đây trình bày dạng xoay ngang:
| Chi nhánh | 07/2026 | 08/2026 | 09/2026 | 10/2026 |
|---|---|---|---|---|
| Hà Nội | 420 | 450 | 410 | 480 |
| Hải Phòng | 300 | 340 | 390 | 480 |
| Đà Nẵng | 260 | 280 | 300 | 310 |
| TP.HCM | 500 | 470 | 540 | 520 |
Tất cả kết quả bên dưới đều được chạy thật trên bộ dữ liệu này, bạn có thể tự tạo bảng và chạy lại để đối chiếu.
Hàm 1: ROW_NUMBER – Đánh số thứ tự và lấy dòng đầu tiên
HÀM 1 · ROW_NUMBER
ROW_NUMBER() đánh số 1, 2, 3… cho từng dòng trong mỗi cửa sổ theo thứ tự bạn chọn, không bao giờ trùng số. Ứng dụng phổ biến nhất là lấy dòng đầu tiên của mỗi nhóm: đơn gần nhất của mỗi khách, bản ghi mới nhất khi dữ liệu bị trùng, hay tháng doanh thu cao nhất của mỗi chi nhánh.
▶ KẾT QUẢ (✨ cột do window function tạo ra)
| chi_nhanh | thang | doanh_thu |
|---|---|---|
| Hà Nội | 10/2026 | 480 |
| Hải Phòng | 10/2026 | 480 |
| TP.HCM | 09/2026 | 540 |
| Đà Nẵng | 10/2026 | 310 |
⚠ Lưu ý: window function không dùng trực tiếp trong WHERE được, nên ta tính trong CTE rồi lọc ở bước sau.
Hàm 2: RANK và DENSE_RANK – Xếp hạng có đồng hạng
HÀM 2 · RANK / DENSE_RANK
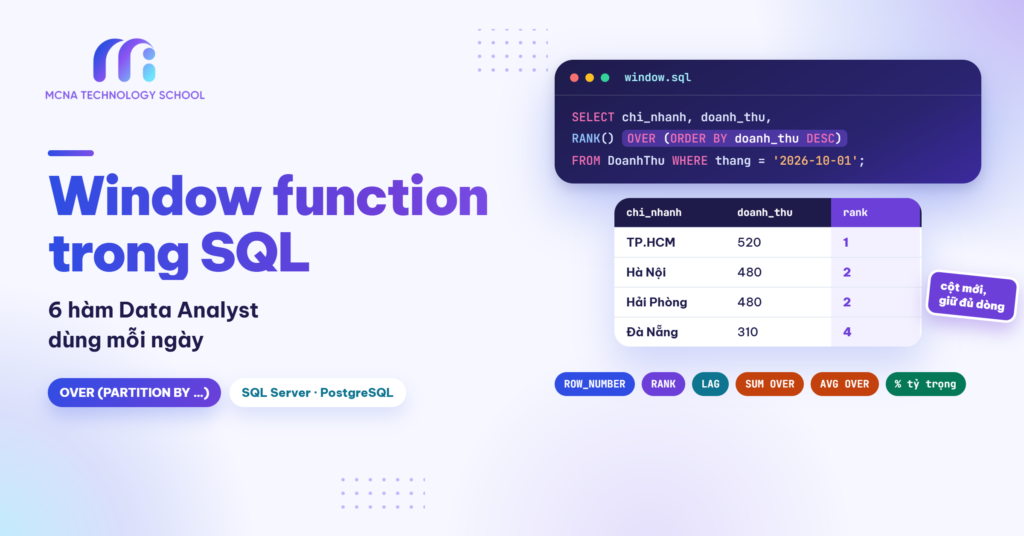
Khi hai dòng bằng nhau, ROW_NUMBER vẫn ép chúng thành hai số khác nhau. RANK và DENSE_RANK cho chúng cùng hạng, chỉ khác ở cách đánh số sau đó.
▶ KẾT QUẢ (✨ cột do window function tạo ra)
| chi_nhanh | doanh_thu | ✨ row_number | ✨ rank | ✨ dense_rank |
|---|---|---|---|---|
| TP.HCM | 520 | 1 | 1 | 1 |
| Hà Nội | 480 | 2 | 2 | 2 |
| Hải Phòng | 480 | 3 | 2 | 2 |
| Đà Nẵng | 310 | 4 | 4 | 3 |
- RANK: đồng hạng rồi nhảy số (1, 2, 2, 4), giống bảng xếp hạng thi đấu.
- DENSE_RANK: đồng hạng nhưng không nhảy số (1, 2, 2, 3), hợp khi cần “top 3 mức doanh thu”.
- ROW_NUMBER: Hà Nội và Hải Phòng cùng 480 nhưng bị chia số 2 và 3 một cách tùy ý. Muốn kết quả ổn định, hãy thêm cột phụ vào ORDER BY, ví dụ
ORDER BY doanh_thu DESC, chi_nhanh.
Hàm 3: LAG và LEAD – So với kỳ trước
HÀM 3 · LAG / LEAD
LAG(cot) lấy giá trị của dòng trước trong cửa sổ, LEAD(cot) lấy giá trị của dòng sau. Đây là cách nhanh nhất để tính tăng trưởng so với tháng trước (MoM), khoảng cách giữa hai lần mua hay thời gian xử lý giữa hai bước.
▶ KẾT QUẢ (✨ cột do window function tạo ra)
| chi_nhanh | thang | doanh_thu | ✨ thang_truoc | ✨ tang_truong_pct |
|---|---|---|---|---|
| Hải Phòng | 07/2026 | 300 | NULL | NULL |
| Hải Phòng | 08/2026 | 340 | 300 | 13,3 |
| Hải Phòng | 09/2026 | 390 | 340 | 14,7 |
| Hải Phòng | 10/2026 | 480 | 390 | 23,1 |
Dòng đầu tiên không có tháng trước nên trả về NULL. Nếu muốn thay bằng 0, dùng tham số thứ ba: LAG(doanh_thu, 1, 0). Muốn so với cùng kỳ năm trước với dữ liệu theo tháng, dùng LAG(doanh_thu, 12).
Con số trên cho thấy Hải Phòng tăng trưởng nhanh dần qua từng tháng, một nhận định khó thấy nếu chỉ nhìn bảng doanh thu thô. Khi đưa lên dashboard, bạn có thể đặt cột tăng trưởng cạnh doanh thu, theo đúng tinh thần của bài Dashboard không phải để đẹp.
Hàm 4 và 5: SUM OVER và AVG OVER – Lũy kế và trung bình trượt
HÀM 4 · SUM OVER · HÀM 5 · AVG OVER
Các hàm tổng hợp quen thuộc như SUM, AVG cũng trở thành window function khi có OVER. Kết hợp với ROWS BETWEEN, bạn có hai chỉ số rất hay dùng trong báo cáo:
- Doanh thu lũy kế (running total): cộng từ tháng đầu tiên đến tháng hiện tại, dùng để so với kế hoạch năm.
- Trung bình trượt 3 tháng (moving average): trung bình của tháng hiện tại và 2 tháng trước, giúp làm mượt biến động để thấy xu hướng.
▶ KẾT QUẢ (✨ cột do window function tạo ra)
| chi_nhanh | thang | doanh_thu | ✨ luy_ke | ✨ tb_truot_3_thang |
|---|---|---|---|---|
| Hà Nội | 07/2026 | 420 | 420 | 420,0 |
| Hà Nội | 08/2026 | 450 | 870 | 435,0 |
| Hà Nội | 09/2026 | 410 | 1.280 | 426,7 |
| Hà Nội | 10/2026 | 480 | 1.760 | 446,7 |
Doanh thu Hà Nội tháng 9 giảm xuống 410, nhưng trung bình trượt chỉ nhích nhẹ rồi tiếp tục tăng, cho thấy đây nhiều khả năng là dao động ngắn hạn chứ chưa phải xu hướng giảm. Lưu ý hai tháng đầu chưa đủ 3 tháng nên trung bình chỉ tính trên số dòng đang có.
Hàm 6: SUM OVER không ORDER BY – Tỷ trọng trong tổng
HÀM 6 · SUM OVER ()
Khi bỏ ORDER BY trong OVER, SUM tính tổng của cả cửa sổ và gắn con số đó vào từng dòng. Chia doanh thu của dòng cho tổng này là ra tỷ trọng.
▶ KẾT QUẢ (✨ cột do window function tạo ra)
| chi_nhanh | doanh_thu | ✨ tong_toan_quoc | ✨ ty_trong_pct |
|---|---|---|---|
| TP.HCM | 520 | 1.790 | 29,1 |
| Hà Nội | 480 | 1.790 | 26,8 |
| Hải Phòng | 480 | 1.790 | 26,8 |
| Đà Nẵng | 310 | 1.790 | 17,3 |
Thêm PARTITION BY để tính tỷ trọng trong từng nhóm, ví dụ SUM(doanh_thu) OVER (PARTITION BY thang) cho tỷ trọng của mỗi chi nhánh trong từng tháng trên cùng một bảng.
📅 Muốn học SQL bài bản từ cơ bản đến window function và ứng dụng vào báo cáo? Xem lịch khai giảng mới nhất tại MCNA.
5 lỗi thường gặp khi dùng window function
⚠ Dùng window function trong WHERE
SQL tính WHERE trước khi tính window function, nên WHERE ROW_NUMBER() OVER (...) = 1 sẽ báo lỗi. Hãy tính trong CTE hoặc truy vấn con rồi mới lọc.
⚠ Lọc dữ liệu làm sai kết quả LAG
nếu WHERE thang = '2026-10-01' đặt cùng câu với LAG, tháng 9 đã bị loại trước nên cột tháng trước toàn là NULL. Tính LAG trên đủ dữ liệu trong CTE, lọc tháng cần xem ở bước sau.
⚠ Quên PARTITION BY
thiếu PARTITION BY chi_nhanh, LAG của dòng đầu tiên của Hải Phòng sẽ lấy nhầm doanh thu tháng cuối của chi nhánh đứng trước.
⚠ Thiếu dòng cho tháng không có dữ liệu
nếu một chi nhánh không có doanh thu tháng 8 và bảng không có dòng đó, LAG của tháng 9 sẽ so với tháng 7. Hãy tạo đủ khung tháng cho mọi chi nhánh trước khi tính.
⚠ Dùng ORDER BY trong SUM OVER mà không ghi rõ phạm vi
khi có ORDER BY mà không có ROWS BETWEEN, nhiều hệ quản trị mặc định dùng RANGE, cộng gộp các dòng có cùng giá trị sắp xếp và cho lũy kế khác mong đợi. Luôn viết rõ ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW.
Câu hỏi thường gặp về window function
?
Window function có làm truy vấn chậm không?
Window function cần sắp xếp dữ liệu theo PARTITION BY và ORDER BY, nên với bảng rất lớn có thể tốn thời gian. Tuy vậy, so với cách cũ là nối bảng với chính nó hay dùng truy vấn con lồng nhau, window function thường nhanh và dễ đọc hơn. Lọc bớt dữ liệu không cần thiết trong CTE đầu tiên sẽ giúp cải thiện tốc độ.
?
Nên dùng RANK hay DENSE_RANK?
Dùng RANK khi muốn thứ hạng phản ánh đúng số người đứng trước, như bảng xếp hạng thi đua. Dùng DENSE_RANK khi muốn lấy “top N mức giá trị” mà không bị hụt vì đồng hạng.
?
Ngoài 6 hàm trên còn hàm nào hữu ích?
NTILE(n) chia dữ liệu thành n nhóm bằng nhau, rất tiện để chấm điểm 1–5 trong phân tích RFM. FIRST_VALUE và LAST_VALUE lấy giá trị đầu hoặc cuối trong cửa sổ, còn COUNT(*) OVER (...) đếm số dòng trong từng nhóm mà không cần GROUP BY.
?
Excel hay Power BI có làm được những việc này không?
Có. Power BI có các hàm DAX tương tự như RANKX hay nhóm hàm thời gian, và bản Power BI gần đây có thêm hàm WINDOW, OFFSET. Tuy nhiên tính sẵn bằng SQL giúp báo cáo nhẹ hơn và dùng lại được cho nhiều công cụ. Xem thêm bài Time Intelligence trong Power BI.
?
Có thể nhờ AI viết window function không?
Có, và AI viết khá tốt nếu bạn mô tả rõ cấu trúc bảng và kết quả mong muốn. Nhưng hãy tự kiểm tra PARTITION BY, ORDER BY và phạm vi ROWS, vì đây là nơi AI hay viết sai mà câu lệnh vẫn chạy được. Bài Prompt cho Data Analyst có mẫu prompt viết SQL bạn có thể dùng ngay.
Kết luận
Window function giúp Data Analyst tính toán trên cả nhóm dòng mà vẫn giữ nguyên chi tiết từng dòng. Chỉ với 6 hàm ROW_NUMBER, RANK/DENSE_RANK, LAG/LEAD, SUM OVER lũy kế, AVG OVER trượt và SUM OVER tỷ trọng, bạn đã xử lý được phần lớn câu hỏi xếp hạng, so sánh kỳ trước và tỷ trọng trong báo cáo hằng ngày.
Hãy nhớ ba điều: chia đúng PARTITION BY, sắp xếp đúng ORDER BY, và viết rõ phạm vi ROWS BETWEEN khi tính lũy kế. Tạo bảng mẫu trong bài và chạy lại từng câu là cách nhanh nhất để nắm vững.
Nếu bạn muốn học SQL bài bản và ứng dụng vào báo cáo thực tế cùng Power BI, các khóa học tại MCNA Technology School sẽ đồng hành cùng bạn. Xem lịch khai giảng mới nhất. Đọc thêm: Phân tích cohort là gì? và Phân tích RFM là gì?.