Series: Machine Learning Fundamentals – Bài 40
Trong các bài viết trước về Học sâu (Deep Learning), chúng ta đã tìm hiểu các kiến trúc mạnh mẽ như CNN (xử lý ảnh), RNN/LSTM (xử lý chuỗi) và Transformer (ngôn ngữ tự nhiên). Tuy nhiên, rào cản lớn nhất khi huấn luyện các mô hình này từ đầu (Training from Scratch) là yêu cầu tập dữ liệu khổng lồ (hàng triệu mẫu) và chi phí tài nguyên phần cứng (GPU/TPU) cực kỳ tốn kém.
Để giải quyết bài toán thiếu hụt dữ liệu và tối ưu chi phí tính toán, kỹ thuật Transfer Learning (Học chuyển giao) đã ra đời như một giải pháp chuẩn mực trong phát triển AI thực tế.
Transfer Learning là gì?
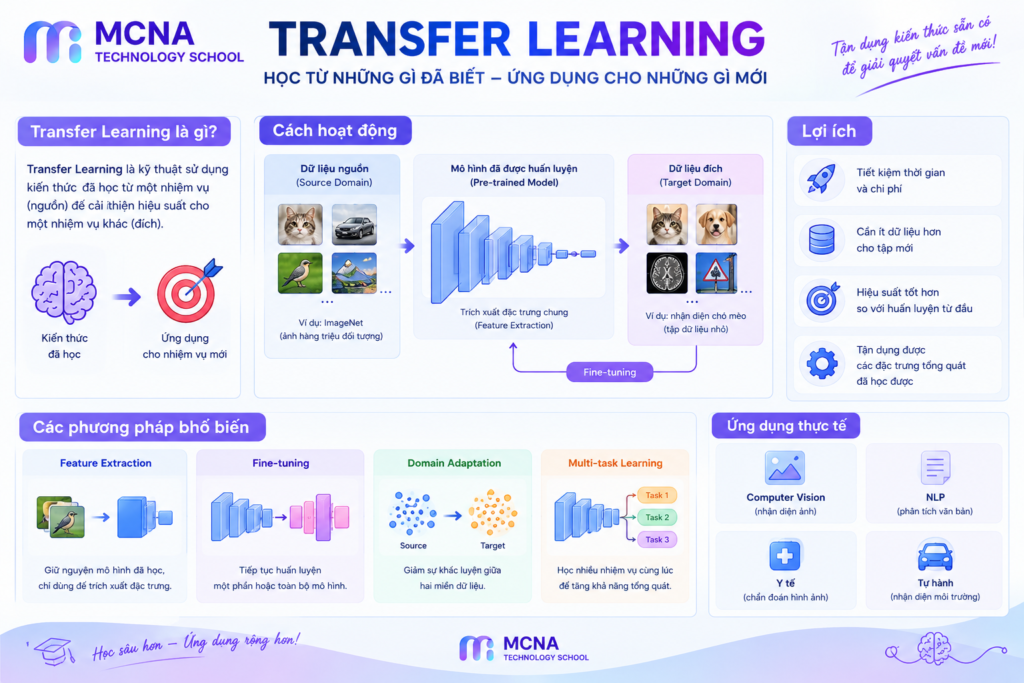
Transfer Learning (Học chuyển giao) là một kỹ thuật trong Deep Learning, nơi một mô hình đã được huấn luyện trước (Pre-trained Model) trên một tập dữ liệu lớn cho một bài toán gốc được tái sử dụng để làm điểm khởi đầu cho một bài toán mới có liên quan.
[Bài toán A: Tập dữ liệu khổng lồ (ví dụ: ImageNet)]
                  │
                  ▼ Huấn luyện mô hình cơ sở (Pre-trained Model)
      [Mô hình đã học các đặc trưng cốt lõi]
                  │
                  ▼ Chuyển giao tri thức (Transfer Learning)
[Bài toán B: Tập dữ liệu nhỏ (ví dụ: Chẩn đoán bệnh X-quang)]
Tài liệu chính thức mô tả Transfer Learning giúp tận dụng các đặc trưng tổng quát (như đường nét, hình dáng, cấu trúc câu) mà mô hình đã học được trước đó để giải quyết bài toán mới nhanh hơn và đạt độ chính xác cao hơn. Xem thêm tại TensorFlow Transfer Learning Guide.
Hai chiến lược cốt lõi trong Transfer Learning
Khi áp dụng Transfer Learning, bạn có 2 chiến lược thực thi chính:
1. Feature Extraction (Trích xuất đặc trưng)
-
Cơ chế: Đóng băng (Freeze) toàn bộ các tầng trích xuất đặc trưng (Convolutional Base) của mô hình Pre-trained, chỉ thay thế và huấn luyện tầng phân loại cuối cùng (Top Classifier Layer) trên tập dữ liệu mới.
-
Trường hợp áp dụng: Tập dữ liệu mới có kích thước nhỏ và có tính chất tương đồng cao với tập dữ liệu gốc mà mô hình Pre-trained đã học.
2. Fine-Tuning (Mở khóa và tinh chỉnh)
-
Cơ chế: Đóng băng các tầng đầu (nơi học các đặc trưng thô như đường kẻ, góc cạnh), sau đó mở khóa (Unfreeze) một số tầng sâu phía sau cùng với tầng Classifier mới để huấn luyện lại với tốc độ học (Learning Rate) rất nhỏ.
-
Trường hợp áp dụng: Tập dữ liệu mới có kích thước vừa hoặc lớn, hoặc có sự khác biệt nhất định so với tập dữ liệu gốc.
Ma trận lựa chọn chiến lược Transfer Learning
| Kích thước Dataset mới | Độ tương đồng với Dataset gốc | Chiến lược đề xuất |
| Nhỏ | Cao (vd: Ảnh mèo/chó giống ImageNet) | Feature Extraction: Chỉ huấn luyện Classifier tầng cuối. |
| Nhỏ | Thấp (vd: Ảnh siêu âm y tế) | Trích xuất đặc trưng từ các tầng nông hoặc dùng mô hình chuyên biệt. |
| Lớn | Cao (vd: Tập ảnh xe cộ quy mô lớn) | Fine-Tuning: Mở khóa các tầng sâu để tối ưu hóa độ chính xác. |
| Lớn | Thấp (vd: Tín hiệu sóng não) | Huấn luyện từ đầu (Train from scratch) hoặc Fine-Tuning toàn bộ. |
Các mô hình Pre-trained phổ biến hiện nay
-
Thị giác máy tính (Computer Vision): ResNet (ResNet50, ResNet101), VGG (VGG16, VGG19), EfficientNet, MobileNet (dùng cho thiết bị di động), Vision Transformer (ViT).
-
Xử lý ngôn ngữ tự nhiên (NLP): BERT, RoBERTa, GPT, T5, LLaMA (được tiền huấn luyện trên hàng tỷ văn bản Wikipedia, BookCorpus, Web).
Dữ liệu có cần Preprocessing / Scaling không?
CỰC KỲ BẮT BUỘC VÀ BẮT BUỘC ĐỒNG BỘ.
Khi sử dụng một mô hình Pre-trained, dữ liệu mới của bạn bắt buộc phải được tiền xử lý chuẩn xác theo đúng quy chuẩn mà mô hình gốc đã sử dụng:
-
Đúng kích thước ảnh (Input Shape): Ví dụ ResNet50 yêu cầu đầu vào $224 \times 224 \times 3$.
-
Đúng vạch chuẩn hóa (Normalization): Nếu mô hình gốc chuẩn hóa Pixel theo trung bình $\mu$ và độ lệch chuẩn $\sigma$ của tập ImageNet, bạn phải áp dụng đúng bộ thông số đó cho dữ liệu mới:
$$\text{Pixel}_{\text{norm}} = \frac{\text{Pixel} – \mu}{\sigma}$$
Ưu điểm và Nhược điểm của Transfer Learning
Ưu điểm
-
Rút ngắn thời gian huấn luyện: Giảm thời gian huấn luyện từ nhiều ngày/tuần xuống chỉ còn vài phút/giờ.
-
Cần ít dữ liệu hơn: Đạt độ chính xác cao ngay cả khi tập dữ liệu mới chỉ có vài trăm mẫu.
-
Tiết kiệm chi phí phần cứng: Không cần hệ thống siêu máy tính để huấn luyện mô hình cơ sở từ đầu.
Nhược điểm
-
Negative Transfer (Chuyển giao tiêu cực): Độ chính xác bị giảm nếu bài toán mới quá xa rời và không có mối liên quan nào với bài toán gốc.
-
Overfitting: Nếu tập dữ liệu mới quá nhỏ mà thực hiện Fine-Tuning quá nhiều tầng, mô hình sẽ rất dễ bị học thuộc lòng.
Tóm tắt
-
Transfer Learning tái sử dụng tri thức từ mô hình Pre-trained để giải quyết bài toán mới.
-
Hai chiến lược chính là Feature Extraction (giữ nguyên gốc) và Fine-Tuning (tinh chỉnh lại các tầng sâu).
-
Tiết kiệm tối đa thời gian, tài nguyên tính toán và dung lượng dữ liệu cần thiết.
-
Bắt buộc tiền xử lý và chuẩn hóa dữ liệu đồng nhất $100\%$ với mô hình Pre-trained gốc.
Tài liệu tham khảo
-
TensorFlow Documentation: Transfer learning and fine-tuning
-
PyTorch Tutorials: Transfer Learning for Computer Vision Tutorial
-
Pan & Yang (2009): A Survey on Transfer Learning – Bài báo khảo sát kinh điển về Transfer Learning.
Khóa học tại MCNA Technology School
Nếu bạn muốn thực hành Machine Learning, Python và xây dựng các mô hình trên dữ liệu thực tế, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
📞 Hotline: 0939.866.825 (Mr. Khang)
🌐 Website: MCNA Technology School
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
📍 TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu