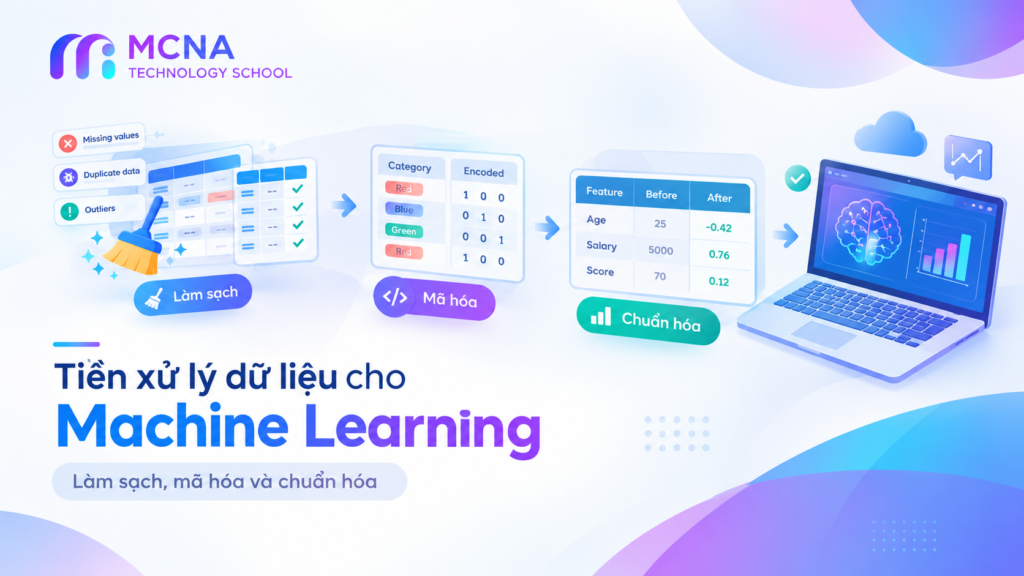
Trong Machine Learning, dữ liệu thô hiếm khi có thể được đưa trực tiếp vào mô hình mà không cần xử lý. Dữ liệu có thể chứa giá trị thiếu, bản ghi trùng lặp, thông tin không nhất quán hoặc các biến phân loại chưa được chuyển đổi sang dạng phù hợp. Nếu những vấn đề này không được xử lý, mô hình có thể học sai quy luật hoặc đưa ra dự đoán thiếu tin cậy.
Tiền xử lý dữ liệu trong Machine Learning (Data Preprocessing) là quá trình kiểm tra, làm sạch và chuyển đổi dữ liệu để mô hình có thể sử dụng dữ liệu một cách phù hợp. Đây là bước tiếp nối tự nhiên sau khi tìm hiểu Machine Learning là gì? và bài viết về Dataset, Feature, Label và Train/Test.
Bài viết tập trung vào ba nhóm kỹ thuật quan trọng: làm sạch dữ liệu, mã hóa dữ liệu và chuẩn hóa thang đo. Đồng thời, bạn sẽ tìm hiểu cách lựa chọn phương pháp phù hợp, triển khai bằng Python và tránh các lỗi thường gặp khi xây dựng mô hình.
1. Tiền xử lý dữ liệu trong Machine Learning là gì?
Data Preprocessing là quá trình biến đổi dữ liệu ban đầu thành dạng phù hợp hơn cho thuật toán Machine Learning. Quá trình này có thể bao gồm xử lý giá trị thiếu, sửa dữ liệu sai định dạng, mã hóa biến phân loại, điều chỉnh thang đo và tổ chức các bước biến đổi thành một quy trình nhất quán.
Bản chất của tiền xử lý không phải là làm cho dữ liệu trông đẹp hơn, mà là bảo đảm mỗi giá trị được hiểu đúng, có ý nghĩa và phù hợp với cách thuật toán học.
Ví dụ, một bộ dữ liệu khách hàng có thể chứa các cột sau:
| Tuổi | Thu nhập | Giới tính | Đăng ký dịch vụ |
|---|---|---|---|
| 25 | 12.000.000 | Nam | Có |
| 32 | 18.000.000 | Nữ | Không |
| Trống | 15.000.000 | Nữ | Có |
| 41 | Trống | Nam | Không |
Dữ liệu trên có hai giá trị thiếu và hai cột dạng văn bản. Tùy thuật toán, các giá trị này có thể cần được xử lý trước khi huấn luyện. Ngoài ra, thu nhập có thang đo lớn hơn nhiều so với tuổi, nên một số mô hình có thể cần chuẩn hóa thang đo.
Quy trình tiền xử lý dữ liệu tổng quát
Dữ liệu thô
    |
    v
Kiểm tra chất lượng dữ liệu
    |
    v
Làm sạch dữ liệu
    |
    v
Xử lý giá trị thiếu và ngoại lệ
    |
    v
Mã hóa biến phân loại
    |
    v
Chuẩn hóa hoặc điều chỉnh thang đo khi cần
    |
    v
Dữ liệu đầu vào cho mô hình Machine Learning
Đây là quy trình minh họa, không phải thứ tự bắt buộc cho mọi dự án. Trong thực tế, cần chia dữ liệu thành tập huấn luyện và tập kiểm tra đúng cách trước khi học các tham số tiền xử lý từ dữ liệu.
2. Vì sao tiền xử lý dữ liệu quan trọng?
Chất lượng dữ liệu ảnh hưởng trực tiếp đến thông tin mà mô hình có thể học được. Một thuật toán phức tạp không thể tự động khắc phục mọi lỗi trong dữ liệu đầu vào.
- Giảm sai lệch: phát hiện giá trị sai, đơn vị không đồng nhất hoặc dữ liệu bị ghi nhận nhầm.
- Bảo toàn thông tin: xử lý dữ liệu thiếu có phương pháp thay vì xóa hàng loạt bản ghi.
- Tương thích với thuật toán: chuyển dữ liệu văn bản hoặc danh mục sang dạng mô hình có thể xử lý.
- Hỗ trợ quá trình học: đưa các đặc trưng về thang đo phù hợp khi thuật toán nhạy với độ lớn của giá trị.
- Đánh giá đáng tin cậy hơn: tránh để thông tin từ tập kiểm tra ảnh hưởng đến quá trình huấn luyện.
Cần lưu ý rằng tiền xử lý không phải lúc nào cũng cải thiện kết quả. Một phép biến đổi không phù hợp có thể làm mất thông tin, tạo thêm nhiễu hoặc khiến kết quả khó giải thích hơn.
3. Làm sạch dữ liệu (Data Cleaning)
Data Cleaning là quá trình phát hiện và xử lý các vấn đề về chất lượng dữ liệu trước khi đưa vào mô hình. Những vấn đề phổ biến gồm giá trị thiếu, bản ghi trùng lặp, sai định dạng, dữ liệu không nhất quán và giá trị bất thường.
3.1. Kiểm tra kiểu dữ liệu và tính nhất quán
Một cột ngày tháng có thể đang được lưu dưới dạng chuỗi văn bản; cột thu nhập có thể chứa dấu phân cách hoặc ký hiệu tiền tệ; cùng một danh mục có thể được ghi thành nhiều cách khác nhau như HCM, TP.HCM và Ho Chi Minh.
Trước khi chuyển đổi, cần xác định ý nghĩa thực tế của dữ liệu. Không nên tự động thay thế các giá trị chỉ vì chúng có hình thức khác nhau: hai nhãn gần giống nhau có thể đại diện cho cùng một nhóm, nhưng cũng có thể mang ý nghĩa khác biệt.
import pandas as pd

df = pd.read_csv("customers.csv")

# Kiểm tra kiểu dữ liệu và số lượng giá trị không thiếu
print(df.info())

# Kiểm tra một số thống kê tổng quát
print(df.describe(include="all"))

# Kiểm tra số lượng giá trị thiếu theo cột
print(df.isna().sum())
3.2. Xử lý bản ghi trùng lặp
Bản ghi trùng lặp có thể làm một số khách hàng hoặc sự kiện được tính nhiều lần, khiến thống kê và mô hình bị ảnh hưởng. Tuy nhiên, hai dòng có giá trị giống nhau chưa chắc là dữ liệu trùng: một khách hàng có thể thực hiện cùng một giao dịch ở hai thời điểm khác nhau.
Vì vậy, cần xác định khóa nhận diện và quy tắc nghiệp vụ trước khi xóa dữ liệu trùng.
# Đếm số dòng trùng hoàn toàn
print(df.duplicated().sum())

# Chỉ xóa sau khi đã xác nhận quy tắc trùng lặp phù hợp
df = df.drop_duplicates()
3.3. Xử lý giá trị thiếu (Missing Values)
Giá trị thiếu xuất hiện khi thông tin không được ghi nhận, không được cung cấp hoặc không tồn tại trong một trường hợp cụ thể. Trong Python, dữ liệu thiếu có thể được biểu diễn bằng NaN, None hoặc NaT, tùy kiểu dữ liệu.
Không nên mặc định rằng mọi giá trị thiếu đều có thể thay bằng 0. Chẳng hạn, thu nhập bằng 0 có ý nghĩa khác với thu nhập chưa được ghi nhận.
| Phương pháp | Cách hoạt động | Khi có thể cân nhắc |
|---|---|---|
| Xóa hàng | Loại bỏ bản ghi có giá trị thiếu | Số lượng bị thiếu nhỏ và việc xóa không gây sai lệch đáng kể |
| Xóa cột | Loại bỏ đặc trưng thiếu quá nhiều thông tin | Cột ít hữu ích hoặc khó khôi phục hợp lý |
| Mean Imputation | Thay bằng giá trị trung bình | Đặc trưng số, khi trung bình phù hợp với phân phối dữ liệu |
| Median Imputation | Thay bằng trung vị | Đặc trưng số có phân phối lệch hoặc có ngoại lệ |
| Mode Imputation | Thay bằng giá trị xuất hiện nhiều nhất | Đặc trưng phân loại |
| Model-based Imputation | Ước lượng giá trị thiếu từ các đặc trưng khác | Khi có lý do để dùng phương pháp phức tạp hơn và có thể kiểm soát sai lệch |
Ví dụ, nếu tuổi của một khách hàng bị thiếu, có thể cân nhắc thay bằng trung vị tuổi trong tập huấn luyện. Nhưng nếu việc không khai báo tuổi có liên quan đến hành vi của khách hàng, cách thay thế này có thể bỏ qua một thông tin quan trọng.
from sklearn.impute import SimpleImputer

imputer = SimpleImputer(strategy="median")

# Minh họa với một cột số
age = df[["age"]]
df["age"] = imputer.fit_transform(age).ravel()
Đoạn mã trên minh họa thao tác imputation. Khi xây dựng mô hình có đánh giá Train/Test, cần học giá trị thay thế từ tập huấn luyện rồi áp dụng cho tập kiểm tra, thay vì tính trên toàn bộ dữ liệu trước khi chia tập.
3.4. Xử lý ngoại lệ (Outliers)
Outlier là giá trị khác biệt đáng kể so với phần còn lại của dữ liệu. Ví dụ, mức thu nhập được ghi nhận là 500.000.000 đồng mỗi tháng có thể là một trường hợp thực tế, một khách hàng đặc biệt hoặc lỗi nhập liệu.
Không phải mọi ngoại lệ đều là dữ liệu sai. Nếu xóa những trường hợp hợp lệ chỉ vì chúng hiếm gặp, mô hình có thể mất khả năng xử lý những tình huống quan trọng.
Một số cách phát hiện ngoại lệ gồm:
- Kiểm tra giới hạn nghiệp vụ và đơn vị đo lường.
- Dùng Boxplot để quan sát các giá trị nằm xa phần lớn phân phối.
- Sử dụng IQR để đánh dấu những điểm nằm ngoài khoảng tham chiếu.
- Áp dụng phương pháp thống kê hoặc thuật toán phát hiện bất thường khi phù hợp.
Với quy tắc IQR, khoảng tham chiếu thường được tính như sau:
IQR = Q3 - Q1

Lower Bound = Q1 - 1.5 * IQR
Upper Bound = Q3 + 1.5 * IQR
Đây là quy tắc phát hiện điểm cần kiểm tra, không phải bằng chứng rằng mọi giá trị nằm ngoài khoảng đều sai. Tùy bài toán, có thể giữ nguyên ngoại lệ, sửa lỗi dữ liệu, giới hạn giá trị (capping), biến đổi phân phối hoặc sử dụng phương pháp ít nhạy với ngoại lệ hơn.
4. Mã hóa dữ liệu (Encoding)
Nhiều thuật toán Machine Learning cần dữ liệu đầu vào ở dạng số. Trong khi đó, dữ liệu thực tế thường có các biến phân loại như giới tính, khu vực, loại sản phẩm hoặc phương thức thanh toán. Encoding chuyển các danh mục này thành biểu diễn phù hợp với thuật toán.
Điểm quan trọng là: chuyển nhãn thành số không có nghĩa là các nhãn tự nhiên có thứ tự hoặc khoảng cách về mặt toán học.
4.1. Label Encoding
Label Encoding gán một số nguyên cho mỗi nhãn. Ví dụ, các lớp đầu ra trong bài toán phân loại có thể được biểu diễn thành 0, 1 và 2.
from sklearn.preprocessing import LabelEncoder

encoder = LabelEncoder()

y = ["Không mua", "Mua", "Không mua", "Mua"]
y_encoded = encoder.fit_transform(y)

print(y_encoded)
Label Encoding thường phù hợp để mã hóa nhãn mục tiêu trong các bài toán phân loại. Với biến đầu vào không có thứ tự, việc gán số nguyên rồi đưa trực tiếp vào một số mô hình có thể khiến mô hình hiểu sai rằng nhãn này lớn hơn hoặc gần nhãn kia.
4.2. Ordinal Encoding
Ordinal Encoding được dùng cho biến phân loại có thứ tự tự nhiên. Ví dụ, mức độ hài lòng gồm Thấp, Trung bình và Cao có thể được mã hóa thành 0, 1 và 2.
| Mức độ hài lòng | Mã hóa minh họa |
|---|---|
| Thấp | 0 |
| Trung bình | 1 |
| Cao | 2 |
Cách mã hóa này giữ lại thứ tự. Tuy nhiên, việc gán 0, 1, 2 không tự động chứng minh rằng khoảng cách giữa Thấp và Trung bình bằng khoảng cách giữa Trung bình và Cao. Ý nghĩa của các mã số vẫn phụ thuộc vào giả định của mô hình.
4.3. One-Hot Encoding
One-Hot Encoding tạo một cột nhị phân cho mỗi danh mục. Phương pháp này thường hữu ích khi các danh mục không có thứ tự tự nhiên.
Giả sử biến Phương thức thanh toán có ba giá trị: Tiền mặt, Thẻ và Ví điện tử.
| Phương thức thanh toán | Tiền mặt | Thẻ | Ví điện tử |
|---|---|---|---|
| Tiền mặt | 1 | 0 | 0 |
| Thẻ | 0 | 1 | 0 |
| Ví điện tử | 0 | 0 | 1 |
import pandas as pd

df = pd.DataFrame({
    "payment": ["Tiền mặt", "Thẻ", "Ví điện tử", "Thẻ"]
})

encoded = pd.get_dummies(df, columns=["payment"], dtype=int)

print(encoded)
One-Hot Encoding tránh tạo ra thứ tự giả giữa các danh mục, nhưng có thể làm số lượng cột tăng mạnh khi một biến có rất nhiều giá trị khác nhau. Với dữ liệu có số lượng danh mục lớn, cần cân nhắc thêm các phương pháp như Feature Hashing hoặc Target Encoding, đồng thời kiểm soát nguy cơ Data Leakage đối với phương pháp có sử dụng thông tin mục tiêu.
4.4. Chọn phương pháp Encoding như thế nào?
| Loại dữ liệu | Phương pháp thường cân nhắc | Lưu ý |
|---|---|---|
| Biến danh mục không có thứ tự | One-Hot Encoding | Tránh tạo thứ tự giả |
| Biến danh mục có thứ tự | Ordinal Encoding | Xác định thứ tự dựa trên ý nghĩa thực tế |
| Nhãn mục tiêu phân loại | Label Encoding hoặc biểu diễn nhãn phù hợp | Không nhầm cách mã hóa nhãn với cách mã hóa Feature |
| Danh mục có rất nhiều giá trị | Feature Hashing, Target Encoding hoặc phương pháp phù hợp khác | Cân nhắc kích thước dữ liệu, hiệu quả và nguy cơ rò rỉ thông tin |
5. Chuẩn hóa dữ liệu (Feature Scaling)
Feature Scaling là nhóm kỹ thuật điều chỉnh thang đo của các đặc trưng số. Ví dụ, một bộ dữ liệu có thể chứa tuổi từ vài chục, thu nhập tính bằng hàng triệu và số lần mua hàng chỉ từ 0 đến vài chục. Sự khác biệt về thang đo có thể ảnh hưởng đến quá trình học của những thuật toán dựa trên khoảng cách, tối ưu hóa hoặc regularization.
Không phải thuật toán nào cũng cần scaling. Các mô hình dựa trên cây quyết định thường ít nhạy với phép biến đổi thang đo đơn điệu của từng đặc trưng hơn so với những mô hình dựa trên khoảng cách hoặc hệ số. Vì vậy, lựa chọn scaling nên dựa trên thuật toán và dữ liệu cụ thể.
5.1. Min-Max Scaling
Min-Max Scaling chuyển các giá trị của một đặc trưng về một khoảng xác định, thường là từ 0 đến 1.
x_scaled = (x - x_min) / (x_max - x_min)Ví dụ, nếu giá trị nhỏ nhất là 10 và lớn nhất là 50, giá trị 30 sẽ được chuyển thành 0.5.
Ưu điểm của phương pháp này là dễ diễn giải và tạo thang đo thống nhất. Hạn chế là kết quả nhạy với ngoại lệ: nếu có một giá trị cực lớn, phần lớn dữ liệu còn lại có thể bị nén vào một khoảng hẹp.
5.2. Standardization với StandardScaler
Standardization chuyển dữ liệu theo trung bình và độ lệch chuẩn của đặc trưng. Công thức phổ biến là:
z = (x - mean) / standard_deviationSau khi biến đổi, dữ liệu trong tập dùng để tính tham số sẽ có trung bình xấp xỉ 0 và độ lệch chuẩn xấp xỉ 1, với các điều kiện tính toán thông thường. Phương pháp này không đảm bảo dữ liệu có phân phối chuẩn.
StandardScaler thường được cân nhắc cho các mô hình như Logistic Regression, Support Vector Machine và các thuật toán tối ưu hóa nhạy với thang đo. Phương pháp này vẫn nhạy với ngoại lệ vì trung bình và độ lệch chuẩn có thể bị ảnh hưởng bởi các giá trị cực đoan.
5.3. Robust Scaling
Robust Scaling sử dụng trung vị và khoảng tứ phân vị thay vì trung bình và độ lệch chuẩn. Vì vậy, phương pháp này có thể phù hợp hơn khi dữ liệu có ngoại lệ đáng kể.
Tuy nhiên, Robust Scaling không tự động xử lý hoặc loại bỏ ngoại lệ. Nó chỉ thay đổi cách xác định vị trí trung tâm và thang đo của dữ liệu.
5.4. Normalization có giống Standardization không?
Trong thực tế, thuật ngữ Normalization đôi khi được dùng theo nghĩa rộng để chỉ việc đưa dữ liệu về một thang đo khác. Trong scikit-learn, Normalizer thường chỉ phép biến đổi từng mẫu dữ liệu để vector của mẫu có chuẩn nhất định, ví dụ chuẩn L2 bằng 1.
Điều này khác với StandardScaler, vốn tính trung bình và độ lệch chuẩn riêng cho từng đặc trưng dựa trên các mẫu trong tập huấn luyện.
| Phương pháp | Ý tưởng chính | Lưu ý |
|---|---|---|
| MinMaxScaler | Đưa mỗi đặc trưng về một khoảng xác định | Nhạy với giá trị cực đoan |
| StandardScaler | Trừ trung bình và chia độ lệch chuẩn | Không bảo đảm phân phối chuẩn; nhạy với ngoại lệ |
| RobustScaler | Dùng trung vị và khoảng tứ phân vị | Có thể phù hợp hơn khi có ngoại lệ |
| Normalizer | Điều chỉnh từng mẫu theo chuẩn vector | Không giống việc scaling riêng từng cột |
5.5. Triển khai Scaling bằng Python
from sklearn.preprocessing import StandardScaler, MinMaxScaler

# Standardization
standard_scaler = StandardScaler()
X_train_standard = standard_scaler.fit_transform(X_train)
X_test_standard = standard_scaler.transform(X_test)

# Min-Max Scaling
minmax_scaler = MinMaxScaler()
X_train_minmax = minmax_scaler.fit_transform(X_train)
X_test_minmax = minmax_scaler.transform(X_test)
Ví dụ trên giả định rằng X_train và X_test đã được tách trước đó. Phương thức fit_transform() học tham số từ tập huấn luyện và biến đổi dữ liệu huấn luyện; phương thức transform() áp dụng chính các tham số đó lên tập kiểm tra.
6. Feature Scaling có bắt buộc với mọi thuật toán?
Không. Việc có cần scaling hay không phụ thuộc vào cách thuật toán sử dụng dữ liệu.
- Thường cần cân nhắc scaling: K-Nearest Neighbors (KNN), K-Means, Support Vector Machine (SVM), Logistic Regression, Linear Regression có regularization và các mô hình dựa trên gradient.
- Thường ít nhạy hơn với scaling: Decision Tree, Random Forest và nhiều mô hình Gradient Boosting dựa trên cây.
- Cần kiểm tra theo bài toán: các mô hình hoặc thư viện cụ thể có thể có yêu cầu riêng về dữ liệu đầu vào.
Ví dụ, nếu dùng KNN để tìm khách hàng tương tự dựa trên tuổi và thu nhập, thu nhập có thể chi phối khoảng cách chỉ vì con số lớn hơn. Scaling giúp hai đặc trưng đóng góp theo thang đo phù hợp hơn, dù không tự quyết định mức độ quan trọng thực sự của chúng.
7. Data Leakage trong tiền xử lý dữ liệu
Data Leakage xảy ra khi thông tin không nên được sử dụng trong quá trình huấn luyện lại ảnh hưởng đến mô hình hoặc quá trình đánh giá. Trong preprocessing, lỗi phổ biến là tính trung bình, trung vị hoặc các tham số scaling trên toàn bộ dữ liệu trước khi chia Train/Test.
Ví dụ, nếu tính trung bình thu nhập từ cả tập huấn luyện và tập kiểm tra, thông tin phân phối của tập kiểm tra đã tham gia vào bước xây dựng quy trình xử lý dữ liệu. Kết quả đánh giá có thể trở nên quá lạc quan hoặc không phản ánh đúng cách mô hình hoạt động với dữ liệu mới.
Quy tắc quan trọng là:
1. Chia dữ liệu thành Train và Test.
2. Dùng Train để học tham số preprocessing.
3. Biến đổi Train bằng các tham số đã học.
4. Biến đổi Test bằng chính các tham số đó.
5. Huấn luyện mô hình trên Train.
6. Đánh giá trên Test mà không dùng Test để điều chỉnh quy trình.
Quy tắc này cũng áp dụng cho imputation, encoding có học tham số, feature selection và các bước biến đổi khác. Trong dự án thực tế, Pipeline của scikit-learn giúp đóng gói các bước này và giảm nguy cơ Data Leakage.
8. Xây dựng quy trình Preprocessing bằng Pipeline
Trong dữ liệu thực tế, các cột thường có kiểu khác nhau. Cột tuổi và thu nhập là dữ liệu số; cột khu vực và phương thức thanh toán là dữ liệu phân loại. Mỗi nhóm cần được xử lý theo cách riêng.
ColumnTransformer cho phép áp dụng những phép biến đổi khác nhau lên các nhóm cột. Khi kết hợp với Pipeline, toàn bộ quá trình preprocessing và huấn luyện được tổ chức thành một quy trình thống nhất.
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# X: các đặc trưng đầu vào
# y: nhãn mục tiêu
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

numeric_features = ["age", "income"]
categorical_features = ["region", "payment_method"]

numeric_pipeline = Pipeline(steps=[
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler())
])

categorical_pipeline = Pipeline(steps=[
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("encoder", OneHotEncoder(handle_unknown="ignore"))
])

preprocessor = ColumnTransformer(transformers=[
    ("num", numeric_pipeline, numeric_features),
    ("cat", categorical_pipeline, categorical_features)
])

model = Pipeline(steps=[
    ("preprocessor", preprocessor),
    ("classifier", LogisticRegression(max_iter=1000))
])

model.fit(X_train, y_train)

predictions = model.predict(X_test)
print("Accuracy:", accuracy_score(y_test, predictions))
Đây là ví dụ minh họa cho bài toán phân loại nhị phân hoặc đa lớp với nhãn phù hợp. Các tên cột cần tồn tại trong dữ liệu thực tế, và cách đánh giá phải phù hợp với bài toán. Với dữ liệu mất cân bằng, Accuracy có thể chưa đủ; nên xem xét thêm Precision, Recall, F1-score hoặc các chỉ số khác tùy mục tiêu.
Ưu điểm của Pipeline là các bước xử lý được học trong quá trình gọi fit() trên tập huấn luyện. Khi dự đoán, dữ liệu mới đi qua đúng các bước biến đổi đã được học, giúp hạn chế tình trạng huấn luyện và dự đoán sử dụng hai cách xử lý khác nhau.
9. Ví dụ tổng hợp: Tiền xử lý dữ liệu khách hàng
Giả sử mục tiêu là dự đoán khách hàng có đăng ký một dịch vụ hay không. Dữ liệu đầu vào gồm tuổi, thu nhập, khu vực và phương thức thanh toán; biến mục tiêu là trạng thái đăng ký.
- Kiểm tra ý nghĩa, kiểu dữ liệu và các giá trị bất thường.
- Xác định các cột số và cột phân loại.
- Kiểm tra dữ liệu thiếu và chọn phương pháp xử lý dựa trên bản chất dữ liệu.
- Chia dữ liệu thành Train/Test trước khi học tham số preprocessing.
- Dùng imputation cho các giá trị thiếu và encoding cho biến phân loại.
- Cân nhắc scaling đối với các đặc trưng số nếu thuật toán cần.
- Huấn luyện mô hình trên tập Train và đánh giá bằng tập Test.
- Lưu cả mô hình lẫn quy trình preprocessing để áp dụng nhất quán khi có dữ liệu mới.
Điều quan trọng không phải là áp dụng càng nhiều kỹ thuật càng tốt. Mỗi bước cần có lý do rõ ràng, phù hợp với dữ liệu và mục tiêu dự đoán.
10. Những lỗi thường gặp khi tiền xử lý dữ liệu
- Thay mọi giá trị thiếu bằng 0: có thể biến dữ liệu chưa biết thành một giá trị có ý nghĩa thực tế khác.
- Xóa toàn bộ ngoại lệ: có thể loại bỏ các trường hợp hiếm nhưng hợp lệ.
- Mã hóa mọi danh mục bằng số nguyên: có thể tạo ra thứ tự giả giữa các nhãn không có thứ tự tự nhiên.
- Scaling toàn bộ dữ liệu trước khi chia tập: tạo nguy cơ Data Leakage.
- Preprocessing Train và Test khác nhau: khiến dữ liệu đưa vào mô hình không còn cùng cách biểu diễn.
- Scaling tất cả các mô hình một cách máy móc: có thể tăng độ phức tạp mà không mang lại lợi ích cần thiết.
- Chỉ đánh giá bằng Accuracy: có thể che giấu hiệu quả kém ở lớp thiểu số trong bài toán mất cân bằng.
- Không lưu quy trình xử lý: dễ dẫn đến việc dữ liệu mới được biến đổi khác với dữ liệu dùng khi huấn luyện.
11. Checklist tiền xử lý dữ liệu cho người mới học
- Đã hiểu ý nghĩa của từng cột và từng giá trị chưa?
- Đã kiểm tra kiểu dữ liệu, giá trị thiếu, dữ liệu trùng lặp và tính nhất quán chưa?
- Đã xác định ngoại lệ là lỗi hay trường hợp hợp lệ chưa?
- Đã phân biệt biến số, biến phân loại có thứ tự và biến phân loại không có thứ tự chưa?
- Đã lựa chọn Encoding dựa trên bản chất của từng biến chưa?
- Đã xác định thuật toán có cần Feature Scaling không?
- Đã chia Train/Test trước khi học tham số preprocessing chưa?
- Đã áp dụng cùng quy trình biến đổi lên dữ liệu huấn luyện và dữ liệu mới chưa?
- Đã sử dụng Pipeline khi cần kết hợp nhiều bước xử lý chưa?
12. Kết luận
Tiền xử lý dữ liệu trong Machine Learning là bước chuyển đổi dữ liệu thô thành biểu diễn phù hợp cho thuật toán. Làm sạch dữ liệu giúp phát hiện và xử lý vấn đề chất lượng; Encoding chuyển biến phân loại sang dạng mô hình có thể sử dụng; Feature Scaling điều chỉnh thang đo khi cần thiết.
Không có một quy trình preprocessing duy nhất phù hợp với mọi bộ dữ liệu. Cách làm đúng là hiểu bản chất dữ liệu, lựa chọn phép biến đổi có cơ sở và bảo đảm các tham số xử lý chỉ được học từ tập huấn luyện. Khi được tổ chức bằng Pipeline, quy trình trở nên nhất quán hơn và giảm nguy cơ Data Leakage.
Sau khi nắm vững dữ liệu và tiền xử lý, bạn có thể tiếp tục tìm hiểu các thuật toán học có giám sát, cách huấn luyện mô hình và cách đánh giá khả năng tổng quát hóa trên dữ liệu chưa từng thấy.
13. Tài liệu tham khảo
- Scikit-learn: Preprocessing data – tài liệu về scaling, encoding và các phép biến đổi dữ liệu.
- Scikit-learn: Imputation of missing values – các phương pháp xử lý giá trị thiếu.
- Scikit-learn: Common pitfalls and recommended practices – Data Leakage và thực hành tiền xử lý an toàn.
- Scikit-learn: Pipelines and composite estimators – kết hợp nhiều bước preprocessing bằng Pipeline và ColumnTransformer.
- Pandas: Working with missing data – cách biểu diễn và xử lý dữ liệu thiếu trong pandas.
14. Học Data, AI và Python cùng MCNA
Nếu bạn muốn xây dựng nền tảng về phân tích dữ liệu, lập trình Python và ứng dụng AI vào công việc, hãy tham khảo các chương trình học tại MCNA Technology School.
- Combo 5 khóa AI & Power BI – tìm hiểu các kỹ năng dữ liệu, trực quan hóa và ứng dụng AI.
- Combo Python – củng cố nền tảng lập trình phục vụ phân tích dữ liệu và Machine Learning.
Tác giả
Nguyễn Quốc Hải – Data Analyst tại MCNA Technology School
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp lớn như Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
🌐 Website: mcna.vn
📘 Facebook: facebook.com/mcnatechnologyschool
▶️ YouTube: youtube.com/@mcna.technology.school
💼 LinkedIn: linkedin.com/company/mcna-vn
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B, TT2, Văn Quán, Hà Đông
📍 TP.HCM: The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu