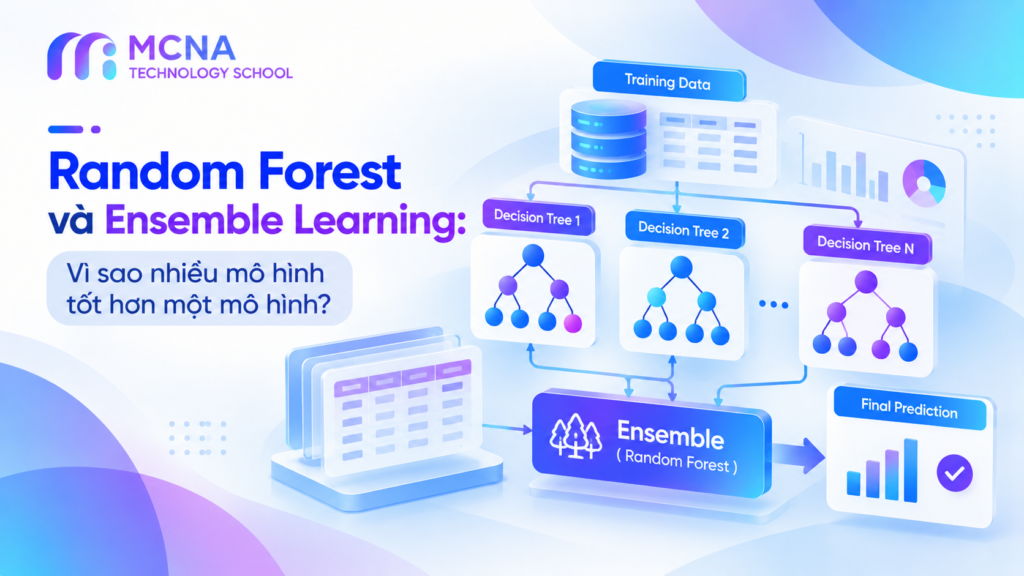
Trong Machine Learning, một mô hình có thể học được quy luật từ dữ liệu nhưng vẫn mắc sai lầm khi gặp những trường hợp mới. Chẳng hạn, một Decision Tree có thể phân loại khách hàng khá tốt trên tập huấn luyện nhưng đưa ra dự đoán thiếu ổn định khi dữ liệu thay đổi một chút.
Thay vì phụ thuộc hoàn toàn vào một mô hình, chúng ta có thể kết hợp nhiều mô hình để tạo ra dự đoán cuối cùng. Cách tiếp cận này được gọi là Ensemble Learning. Trong đó, Random Forest là một thuật toán tiêu biểu, sử dụng nhiều Decision Tree và tổng hợp dự đoán của chúng nhằm cải thiện khả năng khái quát hóa.
Để hiểu rõ Random Forest, chúng ta cần trả lời ba câu hỏi: Vì sao nhiều mô hình có thể tốt hơn một mô hình? Làm thế nào để các mô hình không mắc cùng một lỗi? Và khi nào việc kết hợp mô hình thực sự mang lại lợi ích?
1. Ensemble Learning là gì?
Ensemble Learning là phương pháp kết hợp dự đoán từ nhiều mô hình học máy, thường được gọi là base learners hoặc base estimators, để tạo ra một dự đoán tổng hợp. Mục tiêu là cải thiện khả năng dự đoán trên dữ liệu chưa từng xuất hiện trong quá trình huấn luyện.
Ví dụ, một ngân hàng muốn dự đoán khách hàng có khả năng trả nợ trễ hạn hay không. Ba mô hình có thể đưa ra ba kết quả khác nhau:
| Mô hình | Dự đoán | Xác suất trễ hạn minh họa |
|---|---|---|
| Decision Tree A | Có khả năng trễ hạn | 80% |
| Decision Tree B | Không có khả năng trễ hạn | 35% |
| Decision Tree C | Có khả năng trễ hạn | 65% |
Lưu ý: Các xác suất trên chỉ là ví dụ giả định để minh họa cơ chế kết hợp mô hình, không phải kết quả thực nghiệm.
Nếu mỗi mô hình đóng góp một dự đoán, hệ thống có thể tổng hợp chúng bằng cách lấy trung bình xác suất hoặc bỏ phiếu theo nhãn. Cách tổng hợp cụ thể phụ thuộc vào thuật toán Ensemble đang sử dụng.
1.1. Vì sao nhiều mô hình có thể tốt hơn một mô hình?
Bản chất của Ensemble Learning không nằm ở việc tăng số lượng mô hình một cách đơn thuần, mà nằm ở việc kết hợp các mô hình có năng lực dự đoán và có những sai lầm không hoàn toàn giống nhau.
Giả sử một Decision Tree dự đoán sai một khách hàng do quá nhạy với một số đặc trưng. Nếu các cây khác dựa trên những mẫu dữ liệu hoặc đặc trưng khác nhau, chúng có thể đưa ra dự đoán đúng. Khi tổng hợp kết quả, sai lầm riêng lẻ có thể được giảm bớt.
Ngược lại, nếu tất cả mô hình đều học cùng một quy luật sai và đưa ra cùng một dự đoán sai, việc kết hợp chúng sẽ không giải quyết được vấn đề. Vì vậy, chất lượng của từng mô hình và mức độ đa dạng giữa các mô hình đều quan trọng.
1.2. Ba khái niệm cần phân biệt
- Base learner: Mô hình thành phần, chẳng hạn một Decision Tree.
- Ensemble model: Hệ thống tổng hợp dự đoán từ nhiều mô hình thành phần.
- Aggregation: Quy tắc kết hợp dự đoán, ví dụ majority voting hoặc averaging.
2. Bias, Variance và lý do cần kết hợp mô hình
Để hiểu tại sao Random Forest thường hoạt động tốt hơn một Decision Tree đơn lẻ, cần xem xét hai nguồn sai số quan trọng trong mô hình học máy: Bias và Variance.
2.1. Bias là gì?
Bias phản ánh mức độ sai lệch có tính hệ thống do những giả định hoặc giới hạn của mô hình. Một mô hình quá đơn giản có thể không đủ khả năng mô tả mối quan hệ phức tạp trong dữ liệu, dẫn đến Underfitting.
Ví dụ, nếu mối quan hệ giữa giá nhà và diện tích không hoàn toàn tuyến tính nhưng mô hình chỉ sử dụng một đường thẳng, mô hình có thể bỏ lỡ nhiều quy luật quan trọng.
2.2. Variance là gì?
Variance thể hiện mức độ dự đoán của mô hình thay đổi khi mô hình được huấn luyện trên những tập dữ liệu khác nhau lấy từ cùng một nguồn dữ liệu.
Decision Tree có độ sâu lớn thường có thể tạo ra các quy tắc rất cụ thể để phù hợp với dữ liệu huấn luyện. Khi thay đổi một số quan sát, cấu trúc cây có thể thay đổi đáng kể. Đây là một biểu hiện của Variance cao và có thể dẫn đến Overfitting.
2.3. Random Forest tác động đến Bias và Variance như thế nào?
Random Forest thường xây dựng nhiều cây tương đối phức tạp, sau đó tổng hợp dự đoán của chúng. Việc lấy trung bình hoặc bỏ phiếu có thể làm giảm Variance nếu sai số giữa các cây không tương quan quá cao.
Tuy nhiên, Random Forest không bảo đảm loại bỏ Bias. Việc tạo ngẫu nhiên trong quá trình xây dựng cây đôi khi làm tăng Bias một chút, trong khi giảm Variance đáng kể. Kết quả cuối cùng phụ thuộc vào dữ liệu và cấu hình mô hình.
Trong một số bài toán hồi quy với các giả định phù hợp, sai số dự đoán có thể được phân tích gần đúng thành Bias bình phương, Variance và sai số không thể giảm do nhiễu dữ liệu. Đây là cách nhìn lý thuyết hữu ích, nhưng không phải một công thức phân rã chính xác áp dụng nguyên xi cho mọi bài toán phân loại.
3. Random Forest là gì?
Random Forest là thuật toán Ensemble Learning xây dựng nhiều Decision Tree có tính ngẫu nhiên, sau đó kết hợp kết quả dự đoán của các cây để tạo ra đầu ra cuối cùng.
Random Forest được Leo Breiman trình bày trong công trình nghiên cứu công bố năm 2001. Điểm cốt lõi của thuật toán là tạo ra một tập hợp các cây đủ mạnh nhưng có sự khác biệt trong quá trình xây dựng, nhờ đó hạn chế sự phụ thuộc vào một cây đơn lẻ.
Random Forest hỗ trợ cả hai nhóm bài toán chính:
- Classification: Dự đoán nhãn hoặc nhóm, chẳng hạn khách hàng có rời bỏ dịch vụ hay không.
- Regression: Dự đoán giá trị số, chẳng hạn doanh thu, giá nhà hoặc nhu cầu sản phẩm.
3.1. Kiến trúc tổng quát của Random Forest
Dữ liệu huấn luyện
        |
        +-------------------------------+
        |               |               |
  Bootstrap A     Bootstrap B     Bootstrap C
        |               |               |
   Decision Tree  Decision Tree  Decision Tree
        |               |               |
   Prediction A    Prediction B    Prediction C
        |               |               |
        +---------------+---------------+
                        |
              Tổng hợp dự đoán
                        |
                 Kết quả cuối cùng
Trong Random Forest tiêu chuẩn, các cây được xây dựng trên những mẫu Bootstrap khác nhau. Đồng thời, tại mỗi nút cần chia nhánh, thuật toán chỉ xem xét một tập con ngẫu nhiên của các đặc trưng. Hai nguồn ngẫu nhiên này giúp các cây không hoàn toàn giống nhau.
4. Random Forest hoạt động như thế nào?
Quá trình xây dựng Random Forest có thể được chia thành bốn bước chính.
4.1. Bước 1: Tạo Bootstrap Samples
Bootstrap Sampling là cách lấy mẫu có hoàn lại từ tập dữ liệu ban đầu. Với một tập huấn luyện gồm N quan sát, một Bootstrap Sample thường được tạo bằng cách lấy N lần, mỗi lần chọn ngẫu nhiên một quan sát và cho phép một quan sát được chọn nhiều lần.
Do lấy mẫu có hoàn lại, một số quan sát có thể xuất hiện nhiều lần trong một mẫu Bootstrap, trong khi một số quan sát không xuất hiện trong mẫu đó. Mỗi cây được huấn luyện trên một mẫu Bootstrap riêng.
Ví dụ, dữ liệu ban đầu gồm các quan sát A, B, C, D và E. Một mẫu Bootstrap có thể là A, B, B, D, E. Một mẫu khác có thể là A, C, C, D, D. Đây chỉ là minh họa cách lấy mẫu.
4.2. Bước 2: Chọn ngẫu nhiên các đặc trưng tại mỗi nút
Nếu mọi cây đều xem xét tất cả đặc trưng tại mọi nút, các cây có thể thường xuyên lựa chọn cùng một đặc trưng mạnh nhất và trở nên tương tự nhau. Random Forest hạn chế hiện tượng này bằng cách chỉ xem xét một tập con đặc trưng ngẫu nhiên tại mỗi lần chia nhánh.
Ví dụ, dữ liệu khách hàng có các đặc trưng:
- Tuổi.
- Thu nhập.
- Lịch sử trả nợ.
- Số dư tài khoản.
- Thời gian sử dụng dịch vụ.
Tại một nút, cây thứ nhất có thể chỉ xem xét Tuổi và Thu nhập. Một cây khác có thể xem xét Lịch sử trả nợ và Số dư tài khoản. Tập đặc trưng thực tế được chọn phụ thuộc vào cơ chế lấy mẫu ngẫu nhiên và cấu hình của thuật toán.
Trong tập đặc trưng được xem xét, thuật toán vẫn tìm cách chia nhánh tốt nhất theo tiêu chí của Decision Tree. Tính ngẫu nhiên không đồng nghĩa với việc chọn một phép chia hoàn toàn tùy tiện.
4.3. Bước 3: Huấn luyện nhiều Decision Tree
Mỗi cây phát triển từ mẫu Bootstrap của nó và thực hiện các phép chia nhánh theo quy tắc của Decision Tree. Các cây có thể khác nhau về cấu trúc, đặc trưng được sử dụng và những quan sát xuất hiện trong từng nhánh.
Random Forest tiêu chuẩn thường sử dụng nhiều cây có độ sâu tương đối lớn. Thay vì buộc từng cây phải đơn giản hóa mạnh, thuật toán giảm sự phụ thuộc vào từng cây bằng cách tổng hợp nhiều dự đoán.
4.4. Bước 4: Tổng hợp dự đoán
Quy tắc tổng hợp phụ thuộc vào loại bài toán:
- Classification: Có thể tổng hợp phiếu dự đoán hoặc xác suất dự đoán từ các cây. Trong triển khai scikit-learn, RandomForestClassifier lấy trung bình các xác suất dự đoán của cây rồi chọn lớp có xác suất trung bình cao nhất.
- Regression: RandomForestRegressor lấy trung bình các giá trị dự đoán của những cây thành phần.
Ví dụ với bài toán Classification, nếu 7 trong 10 cây dự đoán khách hàng thuộc nhóm có nguy cơ trễ hạn, đa số phiếu sẽ nghiêng về nhóm đó. Tuy nhiên, nếu sử dụng xác suất trung bình, kết quả cuối cùng còn phụ thuộc vào mức độ tự tin của từng cây.
5. Vì sao Random Forest có thể giảm Variance?
Giả sử mỗi cây đưa ra một dự đoán số và dự đoán cuối cùng là trung bình của M cây. Nếu sai số của các cây có phương sai tương đương là σ² và hệ số tương quan giữa từng cặp sai số là ρ, thì trong một mô hình hóa đơn giản, phương sai của trung bình có dạng:
Var(Trung bình) = σ² × [ρ + (1 - ρ) / M]
Công thức này giả định các cây có cùng phương sai và tương quan cặp đôi như nhau. Nó giúp minh họa hai ý tưởng:
- Khi số cây M tăng, thành phần liên quan đến sai số riêng lẻ có thể giảm.
- Nếu các cây tương quan rất cao, lợi ích của việc tăng số cây sẽ bị giới hạn bởi thành phần ρ.
Nếu các cây có sai số độc lập, tương quan bằng 0 và phương sai của trung bình trong mô hình đơn giản trên giảm theo tỷ lệ 1/M. Trong thực tế, các cây không hoàn toàn độc lập vì chúng được huấn luyện từ cùng một nguồn dữ liệu.
Do đó, Random Forest không chỉ cần nhiều cây mà còn cần sự đa dạng hợp lý giữa chúng. Bootstrap Sampling và lựa chọn đặc trưng ngẫu nhiên là hai cơ chế quan trọng giúp tạo ra sự đa dạng đó.
6. Phân biệt Bagging, Random Forest và Boosting
Các thuật toán này đều thuộc nhóm Ensemble Learning nhưng khác nhau ở cách tạo mô hình thành phần và cách kết hợp chúng.
| Phương pháp | Cách xây dựng mô hình | Cách kết hợp | Mục tiêu thường gặp |
|---|---|---|---|
| Bagging | Huấn luyện các mô hình trên những mẫu dữ liệu được lấy ngẫu nhiên, thường là Bootstrap Samples | Lấy trung bình hoặc bỏ phiếu | Giảm Variance |
| Random Forest | Bagging với Decision Tree, kết hợp lấy mẫu dữ liệu và chọn ngẫu nhiên đặc trưng tại các nút | Lấy trung bình hoặc tổng hợp dự đoán cây | Giảm Variance và tăng độ ổn định |
| Boosting | Huấn luyện mô hình theo chuỗi; các bước sau điều chỉnh để cải thiện những điểm mô hình trước xử lý chưa tốt | Kết hợp có trọng số hoặc cộng các đóng góp của mô hình | Cải thiện hiệu năng bằng cách giảm sai số còn lại |
| Voting | Kết hợp các mô hình có thể thuộc những thuật toán khác nhau | Bỏ phiếu theo nhãn hoặc tổng hợp xác suất | Tận dụng điểm mạnh của nhiều mô hình |
| Stacking | Huấn luyện các mô hình cơ sở, sau đó dùng dự đoán của chúng làm đầu vào cho mô hình Meta-Learner | Mô hình Meta-Learner học cách kết hợp | Học quy tắc phối hợp mô hình từ dữ liệu |
6.1. Bagging và Random Forest khác nhau ở đâu?
Bagging là một chiến lược Ensemble Learning tổng quát. Nó có thể sử dụng nhiều loại mô hình cơ sở khác nhau. Random Forest là một trường hợp cụ thể, sử dụng Decision Tree và bổ sung cơ chế chọn đặc trưng ngẫu nhiên tại mỗi nút.
Vì vậy, có thể xem Random Forest là một phương pháp thuộc họ Bagging, nhưng không phải mọi mô hình Bagging đều là Random Forest.
6.2. Random Forest và Boosting khác nhau ở đâu?
Random Forest thường xây dựng các cây tương đối độc lập với nhau dựa trên những mẫu và tập đặc trưng ngẫu nhiên. Các cây có thể được huấn luyện song song.
Ngược lại, Boosting xây dựng mô hình theo từng giai đoạn. Mỗi mô hình mới được thêm vào nhằm cải thiện dự đoán của tổ hợp hiện tại, chẳng hạn bằng cách tập trung vào các quan sát khó hoặc tối ưu hàm mất mát.
Không có phương pháp nào luôn tốt hơn trong mọi bài toán. Random Forest thường là một lựa chọn nền tảng mạnh cho dữ liệu dạng bảng, trong khi các thuật toán Gradient Boosting có thể cạnh tranh rất tốt và cần được đánh giá trên dữ liệu cụ thể.
7. Ví dụ thực hành Random Forest bằng Python
Chúng ta sẽ xây dựng một mô hình Random Forest để phân loại các loài hoa trong bộ dữ liệu Iris có sẵn trong scikit-learn. Đây là dữ liệu mẫu phục vụ học tập, không đại diện cho một bài toán kinh doanh thực tế.
7.1. Cài đặt thư viện
pip install scikit-learn7.2. Huấn luyện và đánh giá mô hình
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report
from sklearn.metrics import confusion_matrix

# 1. Tải dữ liệu
iris = load_iris()
X = iris.data
y = iris.target

# 2. Chia dữ liệu train/test
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

# 3. Khởi tạo Random Forest
model = RandomForestClassifier(
    n_estimators=100,
    max_features="sqrt",
    random_state=42,
    n_jobs=-1
)

# 4. Huấn luyện mô hình
model.fit(X_train, y_train)

# 5. Dự đoán trên tập test
y_pred = model.predict(X_test)

# 6. Đánh giá
print("Accuracy:", accuracy_score(y_test, y_pred))
print("Confusion Matrix:")
print(confusion_matrix(y_test, y_pred))
print("Classification Report:")
print(classification_report(y_test, y_pred, target_names=iris.target_names))
7.3. Giải thích các thành phần chính
load_iris(): Tải bộ dữ liệu mẫu Iris.train_test_split(): Chia dữ liệu thành tập huấn luyện và tập kiểm tra.stratify=y: Giữ tỷ lệ các lớp tương đối nhất quán giữa hai tập dữ liệu.n_estimators=100: Xây dựng 100 cây quyết định.max_features="sqrt": Với bài toán Classification, mỗi nút xem xét một tập con đặc trưng có kích thước theo căn bậc hai của tổng số đặc trưng.random_state=42: Cố định nguồn ngẫu nhiên để thuận tiện tái lập kết quả trong cùng môi trường và cấu hình.n_jobs=-1: Cho phép sử dụng các bộ xử lý có sẵn để thực hiện những tác vụ hỗ trợ song song.accuracy_score(): Tính tỷ lệ dự đoán đúng.confusion_matrix()vàclassification_report(): Giúp xem mô hình phân loại từng lớp như thế nào.
Đoạn mã trên tạo ra kết quả khi được chạy trong môi trường Python phù hợp. Không nên gán trước một giá trị Accuracy cụ thể nếu chưa thực sự thực thi mã. Với dữ liệu thực tế, cần đánh giá thêm bằng Cross-Validation và các chỉ số phù hợp với mục tiêu kinh doanh.
7.4. Xem mức độ quan trọng của đặc trưng
Random Forest có thể cung cấp thông tin về mức độ quan trọng của các đặc trưng thông qua thuộc tính feature_importances_. Ví dụ:
import pandas as pd

importance = pd.DataFrame({
    "feature": iris.feature_names,
    "importance": model.feature_importances_
})

importance = importance.sort_values(
    by="importance",
    ascending=False
)

print(importance)
Trong Random Forest của scikit-learn, mức độ quan trọng mặc định dựa trên tổng mức giảm impurity do đặc trưng tạo ra trong các cây. Chỉ số này có thể thiên lệch về một số loại đặc trưng, chẳng hạn đặc trưng liên tục có nhiều điểm chia khả dĩ.
Vì vậy, Feature Importance không nên được diễn giải như bằng chứng về quan hệ nhân quả. Khi cần đánh giá mức độ đóng góp của đặc trưng đáng tin cậy hơn, có thể xem xét Permutation Importance trên tập dữ liệu phù hợp.
8. Các tham số quan trọng của Random Forest
| Tham số | Ý nghĩa | Ảnh hưởng cần lưu ý |
|---|---|---|
n_estimators |
Số lượng cây trong rừng | Tăng số cây có thể làm dự đoán ổn định hơn nhưng tăng thời gian và tài nguyên tính toán. |
max_depth |
Độ sâu tối đa của mỗi cây | Giới hạn độ sâu có thể giảm độ phức tạp và hạn chế Overfitting. |
max_features |
Số lượng hoặc tỷ lệ đặc trưng được xem xét tại mỗi nút | Giá trị nhỏ hơn thường tăng tính ngẫu nhiên nhưng có thể làm từng cây yếu hơn. |
min_samples_split |
Số mẫu tối thiểu để một nút được phép chia | Giá trị lớn hơn hạn chế việc tạo các nhánh quá chi tiết. |
min_samples_leaf |
Số mẫu tối thiểu tại một nút lá | Giúp tránh những lá được hình thành từ quá ít quan sát. |
class_weight |
Điều chỉnh trọng số của các lớp trong Classification | Có thể hữu ích khi dữ liệu mất cân bằng, nhưng cần đánh giá bằng các chỉ số phù hợp. |
Không có một bộ tham số tối ưu cho mọi tập dữ liệu. Nên lựa chọn tham số bằng Cross-Validation trên tập huấn luyện và chỉ sử dụng tập test để đánh giá cuối cùng, tránh điều chỉnh mô hình liên tục dựa trên kết quả test.
9. Ưu điểm và hạn chế của Random Forest
9.1. Ưu điểm
- Giảm sự phụ thuộc vào một cây: Tổng hợp nhiều cây có thể làm giảm Variance và tăng độ ổn định.
- Hỗ trợ Classification và Regression: Có thể sử dụng cho nhiều loại mục tiêu dự đoán.
- Học được quan hệ phi tuyến: Cây có thể biểu diễn các quy tắc và tương tác giữa đặc trưng mà không yêu cầu mối quan hệ tuyến tính đơn giản.
- Ít phụ thuộc vào chuẩn hóa: Thông thường không cần Standardization như nhiều thuật toán dựa trên khoảng cách hoặc tối ưu hệ số.
- Có thể đánh giá đặc trưng: Hỗ trợ phân tích Feature Importance, dù cần diễn giải thận trọng.
9.2. Hạn chế
- Tốn tài nguyên hơn một cây: Nhiều cây làm tăng dung lượng mô hình và chi phí dự đoán.
- Khó diễn giải tổng thể: Một rừng gồm hàng trăm cây thường khó giải thích trực quan hơn một Decision Tree đơn lẻ.
- Không bảo đảm vượt trội: Với dữ liệu có quy luật đơn giản hoặc phù hợp với mô hình khác, Random Forest có thể không phải lựa chọn tốt nhất.
- Không tự khắc phục chất lượng dữ liệu: Dữ liệu rò rỉ thông tin, nhãn sai lệch, mẫu không đại diện hoặc phân phối thay đổi vẫn có thể dẫn đến dự đoán kém.
- Không ngoại suy tốt trong Regression: Dự đoán thường dựa trên giá trị ở các nút lá, nên khó ngoại suy xu hướng vượt xa phạm vi dữ liệu huấn luyện.
10. Khi nào nên sử dụng Random Forest?
Random Forest là lựa chọn đáng cân nhắc khi cần một mô hình mạnh cho dữ liệu dạng bảng, có nhiều đặc trưng và tồn tại các quan hệ phi tuyến. Một số tình huống thường gặp gồm:
- Phân tích khách hàng: Dự đoán khả năng rời bỏ dịch vụ hoặc phản hồi chiến dịch.
- Tài chính và ngân hàng: Hỗ trợ xây dựng mô hình phân loại rủi ro tín dụng, với quy trình kiểm định và quản trị mô hình phù hợp.
- Bán hàng: Dự đoán nhu cầu hoặc doanh thu từ các đặc trưng đầu vào.
- Vận hành: Phân loại sự cố hoặc dự đoán khả năng phát sinh lỗi.
- Phân tích dữ liệu: Xây dựng mô hình baseline để so sánh với các thuật toán phức tạp hơn.
Trong bài toán cần giải thích rõ lý do của từng dự đoán, cần cân nhắc yêu cầu về khả năng diễn giải. Với dữ liệu chuỗi thời gian, cần thiết kế cách chia train/test theo thứ tự thời gian thay vì chia ngẫu nhiên một cách máy móc. Với bài toán có dữ liệu mất cân bằng, không nên chỉ nhìn vào Accuracy mà cần xem xét Precision, Recall, F1-score, PR-AUC hoặc các chỉ số phù hợp với chi phí sai lầm.
11. Những hiểu lầm phổ biến về Ensemble Learning
11.1. Càng nhiều mô hình thì kết quả luôn càng tốt
Không chính xác. Khi tăng số cây, Random Forest thường có thể ổn định hơn trong một khoảng nhất định, nhưng lợi ích sẽ giảm dần. Nhiều cây hơn cũng làm tăng thời gian huấn luyện, dung lượng mô hình và thời gian dự đoán. Nếu các cây có sai số tương quan cao, việc tăng số lượng cây có thể đem lại ít cải thiện.
11.2. Ensemble Learning luôn loại bỏ Overfitting
Ensemble Learning có thể giảm một số dạng sai số, nhưng không loại bỏ hoàn toàn Overfitting. Mô hình vẫn có thể học từ dữ liệu bị rò rỉ, nhãn nhiễu hoặc mẫu không đại diện. Việc đánh giá đúng cách và kiểm soát độ phức tạp vẫn cần thiết.
11.3. Feature Importance cho biết nguyên nhân gây ra kết quả
Feature Importance phản ánh cách đặc trưng được sử dụng trong mô hình theo một định nghĩa cụ thể. Nó không tự chứng minh quan hệ nhân quả. Những đặc trưng tương quan mạnh với nhau cũng có thể khiến việc phân bổ mức độ quan trọng trở nên khó diễn giải.
12. Kết luận
Ensemble Learning là cách tiếp cận kết hợp dự đoán từ nhiều mô hình nhằm cải thiện khả năng khái quát hóa và độ ổn định. Tuy nhiên, hiệu quả của nó phụ thuộc vào năng lực của các mô hình thành phần, mức độ đa dạng giữa chúng và cách tổng hợp dự đoán.
Random Forest hiện thực hóa ý tưởng này bằng cách huấn luyện nhiều Decision Tree trên các mẫu Bootstrap và sử dụng tập con đặc trưng ngẫu nhiên tại mỗi nút. Nhờ giảm sự phụ thuộc vào một cây đơn lẻ, thuật toán có thể hạn chế Variance và là một lựa chọn nền tảng hữu ích cho nhiều bài toán Classification và Regression.
Khi học Machine Learning, hãy ghi nhớ mối liên hệ: Decision Tree cung cấp mô hình thành phần; Bagging tạo ra nhiều mô hình từ các mẫu dữ liệu khác nhau; Random Forest bổ sung tính ngẫu nhiên ở đặc trưng; còn Boosting, Voting và Stacking là những cách kết hợp mô hình khác nhau. Hiểu sự khác biệt này sẽ giúp bạn chọn thuật toán dựa trên bản chất bài toán thay vì chỉ dựa vào độ phổ biến.
13. Tài liệu tham khảo
- Breiman, L. (2001). Random Forests. Machine Learning, 45, 5–32. https://doi.org/10.1023/A:1010933404324
- scikit-learn. Ensembles: Gradient boosting, random forests, bagging, voting, stacking. Tài liệu chính thức về Ensemble Learning
- scikit-learn. RandomForestClassifier. Tài liệu API RandomForestClassifier
- scikit-learn. RandomForestRegressor. Tài liệu API RandomForestRegressor
- scikit-learn. Permutation Feature Importance. Tài liệu về Permutation Importance
14. Học thêm Data, AI và Machine Learning tại MCNA
Nếu bạn muốn xây dựng nền tảng từ Python, phân tích dữ liệu đến ứng dụng AI trong công việc, có thể tham khảo các chương trình học sau:
Tác giả
Nguyễn Quốc Hải – Data Analyst tại MCNA Technology School
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp lớn như Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
🌐 Website: mcna.vn
📘 Facebook: facebook.com/mcnatechnologyschool
▶️ YouTube: youtube.com/@mcna.technology.school
💼 LinkedIn: linkedin.com/company/mcna-vn
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B, TT2, Văn Quán, Hà Đông
📍 TP.HCM: The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu