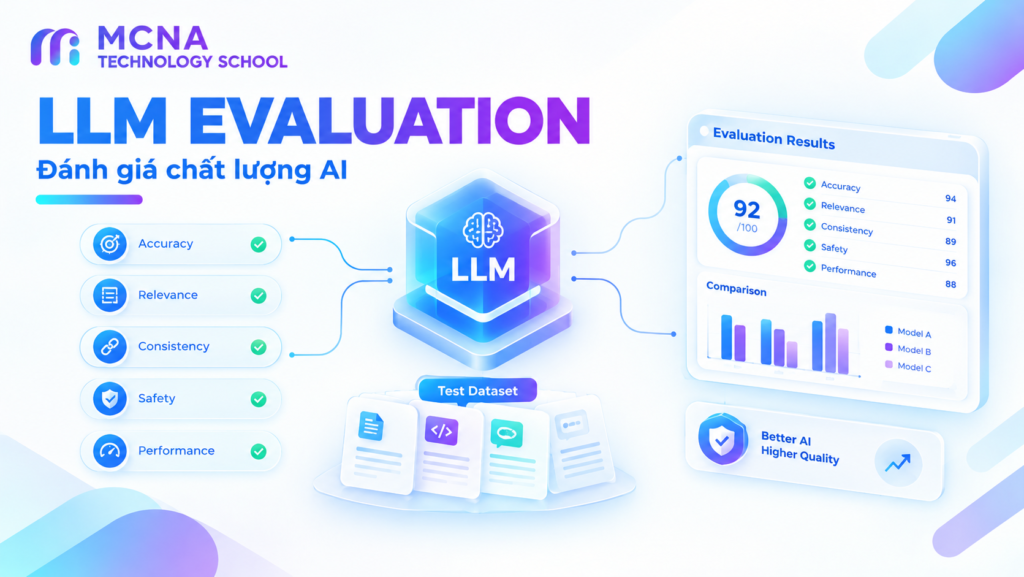
Trong quá trình phát triển ứng dụng trí tuệ nhân tạo, một câu trả lời nghe có vẻ hợp lý chưa chắc đã chính xác. Một chatbot có thể phản hồi trôi chảy nhưng vẫn cung cấp thông tin sai, bỏ sót yêu cầu hoặc đưa ra kết quả không nhất quán giữa những lần chạy khác nhau.
Đó là lý do LLM Evaluation trở thành một bước quan trọng trong quá trình xây dựng và vận hành ứng dụng AI. Thay vì chỉ kiểm tra thủ công một vài câu trả lời, LLM Evaluation giúp đội ngũ phát triển xây dựng tiêu chí, bộ dữ liệu kiểm thử và quy trình đo lường chất lượng một cách có hệ thống.
1. LLM Evaluation là gì?
LLM Evaluation (đánh giá mô hình ngôn ngữ lớn) là quá trình đo lường chất lượng đầu ra của Large Language Model (LLM) hoặc toàn bộ ứng dụng sử dụng LLM, dựa trên những tiêu chí và dữ liệu kiểm thử được xác định trước.
Tùy mục tiêu, quá trình đánh giá có thể tập trung vào độ chính xác của câu trả lời, mức độ liên quan, khả năng tuân thủ định dạng, tính nhất quán, độ an toàn, độ trễ hoặc chi phí vận hành.
Ví dụ, với chatbot tư vấn khóa học, câu trả lời tốt không chỉ cần dễ đọc mà còn phải đúng với thông tin khóa học, trả lời đúng câu hỏi của người dùng và không tự bịa ra học phí hay lịch khai giảng.
2. Vì sao cần đánh giá ứng dụng LLM?
2.1. Phát hiện lỗi trước khi triển khai
LLM có thể tạo ra thông tin sai lệch, diễn giải nhầm dữ liệu hoặc không tuân thủ yêu cầu. Kiểm thử có hệ thống giúp phát hiện những trường hợp này trước khi chúng ảnh hưởng đến người dùng thật.
2.2. So sánh prompt và mô hình
Khi thay đổi prompt, mô hình hoặc tham số sinh nội dung, chất lượng đầu ra có thể thay đổi. Một bộ kiểm thử cố định giúp so sánh các phiên bản trên cùng điều kiện thay vì dựa vào một vài ví dụ ngẫu nhiên.
2.3. Hạn chế lỗi phát sinh sau khi cập nhật
Một thay đổi có thể cải thiện khả năng trả lời một nhóm câu hỏi nhưng làm giảm chất lượng ở nhóm khác. Chạy lại bộ đánh giá sau mỗi lần cập nhật giúp nhận biết hiện tượng suy giảm chất lượng (regression).
2.4. Cân bằng chất lượng và chi phí
Mô hình có khả năng cao hơn chưa chắc là lựa chọn tối ưu cho mọi ứng dụng. Đánh giá đồng thời chất lượng, tốc độ phản hồi và chi phí giúp đội ngũ chọn giải pháp phù hợp với nhu cầu thực tế.
3. Các tiêu chí phổ biến trong LLM Evaluation
| Tiêu chí | Câu hỏi cần trả lời | Ví dụ |
|---|---|---|
| Correctness | Thông tin có chính xác không? | Học phí có khớp dữ liệu chính thức? |
| Relevance | Câu trả lời có đúng trọng tâm không? | Hỏi về Python nhưng AI không lan man sang chủ đề khác. |
| Faithfulness / Groundedness | Câu trả lời có được hỗ trợ bởi nguồn dữ liệu được cung cấp không? | Chatbot không thêm chính sách chưa xuất hiện trong tài liệu. |
| Instruction Following | Mô hình có làm đúng yêu cầu không? | Người dùng yêu cầu trả lời bằng ba gạch đầu dòng. |
| Safety | Đầu ra có vi phạm các quy tắc an toàn không? | Không tiết lộ dữ liệu nhạy cảm trái phép. |
| Latency | Hệ thống phản hồi nhanh đến đâu? | Thời gian từ khi gửi câu hỏi đến khi nhận câu trả lời. |
| Cost | Mỗi lần xử lý tốn bao nhiêu tài nguyên? | Chi phí trung bình cho một lượt hỏi đáp. |
Không có một chỉ số duy nhất phù hợp cho tất cả ứng dụng. Bộ tiêu chí nên được lựa chọn theo mục tiêu và rủi ro của sản phẩm.
4. Những phương pháp đánh giá LLM phổ biến
4.1. Đánh giá bằng quy tắc (rule-based evaluation)
Phương pháp này sử dụng các điều kiện xác định trước để kiểm tra đầu ra. Ví dụ: kết quả có phải JSON hợp lệ không, có chứa trường bắt buộc không, hoặc có khớp chính xác với đáp án chuẩn không.
Ưu điểm là dễ tự động hóa và cho kết quả nhất quán khi tiêu chí rõ ràng. Hạn chế là khó đánh giá những khía cạnh ngữ nghĩa hoặc chất lượng diễn đạt phức tạp.
4.2. Đánh giá bởi con người (human evaluation)
Người đánh giá đọc câu trả lời và chấm theo bộ tiêu chí, chẳng hạn độ chính xác, tính hữu ích và mức độ dễ hiểu. Cách này đặc biệt hữu ích khi tiêu chuẩn chất lượng cần phán đoán chuyên môn.
Để tăng độ tin cậy, cần có hướng dẫn chấm điểm rõ ràng, ví dụ minh họa và quy trình xử lý khi những người đánh giá bất đồng.
4.3. Đánh giá bằng mô hình (LLM-as-a-judge)
Một mô hình khác được giao nhiệm vụ chấm đầu ra theo rubric (bộ tiêu chí chấm điểm) đã định nghĩa. Phương pháp này có thể hỗ trợ đánh giá ở quy mô lớn nhưng bản thân mô hình chấm cũng có thể thiên lệch hoặc chấm sai.
Vì vậy, nên hiệu chỉnh kết quả bằng các mẫu do con người đánh giá, đặc biệt với các quyết định có ảnh hưởng lớn.
4.4. Đánh giá theo bộ dữ liệu chuẩn (benchmark và test dataset)
Hệ thống được kiểm tra trên một tập câu hỏi, đầu vào hoặc tình huống đã chuẩn bị trước. Kết quả được tổng hợp thành các chỉ số để so sánh giữa những phiên bản hoặc cấu hình khác nhau.
Benchmark công khai có thể hữu ích để tham khảo, nhưng bộ dữ liệu kiểm thử riêng vẫn rất quan trọng vì dữ liệu công khai có thể không phản ánh đúng người dùng, ngôn ngữ và nghiệp vụ của sản phẩm.
5. Cách xây dựng bộ dữ liệu kiểm thử cho LLM
Một bộ dữ liệu đánh giá có thể được tổ chức dưới dạng bảng, trong đó mỗi dòng đại diện cho một tình huống cần kiểm tra.
| Input | Expected behavior | Tiêu chí |
|---|---|---|
| Khóa học Python dành cho ai? | Trả lời đúng đối tượng học theo thông tin chính thức. | Correctness, Relevance |
| Khóa học có cam kết việc làm không? | Chỉ nêu cam kết nếu tài liệu chính thức xác nhận. | Correctness, Groundedness |
| Trả lời bằng hai gạch đầu dòng. | Đầu ra gồm hai ý chính. | Instruction Following |
| Thông tin này không có trong tài liệu. | Thừa nhận thiếu dữ liệu hoặc hướng dẫn liên hệ phù hợp. | Hallucination, Safety |
Khi xây dựng test dataset, nên bao gồm:
- Các tình huống phổ biến nhất trong thực tế.
- Các câu hỏi mơ hồ, thiếu thông tin hoặc có nhiều cách diễn đạt.
- Các trường hợp ngoại lệ và tình huống có nguy cơ tạo thông tin sai.
- Các yêu cầu về định dạng, ngôn ngữ và phong cách phản hồi.
- Các tình huống liên quan đến quyền riêng tư và an toàn nếu phù hợp với ứng dụng.
Đáp án chuẩn hoặc tiêu chí chấm cần đủ rõ để người khác có thể đánh giá lại. Đồng thời, nên giữ riêng một phần dữ liệu để kiểm tra cuối cùng, tránh điều chỉnh hệ thống quá sát với chính những ví dụ dùng để phát triển.
6. Quy trình LLM Evaluation trong thực tế
- Xác định mục tiêu: Làm rõ ứng dụng cần giải quyết vấn đề gì và lỗi nào gây ảnh hưởng lớn nhất.
- Chọn tiêu chí: Xác định các chỉ số phản ánh đúng chất lượng cần đo, thay vì thu thập quá nhiều chỉ số không có ý nghĩa.
- Chuẩn bị dữ liệu: Tạo bộ câu hỏi đại diện, đáp án chuẩn hoặc rubric chấm điểm.
- Chạy hệ thống: Đưa từng đầu vào qua phiên bản mô hình và cấu hình cần kiểm thử.
- Chấm điểm: Kết hợp các quy tắc tự động, đánh giá của con người hoặc LLM-as-a-judge tùy trường hợp.
- Phân tích lỗi: Xem các trường hợp thất bại để xác định nguyên nhân, thay vì chỉ nhìn điểm trung bình.
- Cải thiện và kiểm thử lại: Điều chỉnh prompt, dữ liệu, mô hình hoặc logic ứng dụng rồi chạy lại cùng bộ kiểm thử.
7. Ví dụ: Đánh giá chatbot tư vấn khóa học
Giả sử một trung tâm đào tạo sử dụng chatbot để trả lời câu hỏi về khóa học. Nhóm phát triển chuẩn bị 100 tình huống kiểm thử và định nghĩa ba tiêu chí chính: độ chính xác, mức độ liên quan và khả năng xử lý câu hỏi không có thông tin.
Ví dụ, khi người dùng hỏi về một chính sách chưa có trong tài liệu, chatbot tốt cần nói rõ rằng chưa đủ thông tin thay vì tự tạo ra câu trả lời chắc chắn.
Sau khi chạy kiểm thử, nhóm có thể tổng hợp tỷ lệ trả lời đúng, tỷ lệ trả lời đúng trọng tâm và tỷ lệ bịa thông tin trong các tình huống thiếu dữ liệu. Các kết quả này giúp nhóm nhận biết điểm yếu để ưu tiên cải thiện.
Điểm số cụ thể cần được tính từ kết quả thực nghiệm; không nên giả định hệ thống tốt chỉ vì đã có bộ test hoặc vì câu trả lời nghe tự nhiên.
8. Công cụ hỗ trợ đánh giá LLM
- OpenAI – Working with evals: tài liệu về việc kiểm thử và cải thiện đầu ra mô hình theo tiêu chí xác định.
- OpenAI – Getting started with datasets: hướng dẫn bắt đầu với dữ liệu đánh giá và quy trình gắn nhãn kết quả.
- Ragas – Available metrics: tổng hợp các chỉ số đánh giá cho những trường hợp như RAG, agent và so sánh ngôn ngữ.
Việc chọn công cụ nên dựa trên kiến trúc ứng dụng, yêu cầu bảo mật, ngân sách và khả năng tích hợp. Hãy kiểm tra tài liệu hiện hành trước khi lựa chọn nền tảng hoặc API cụ thể.
9. Những sai lầm thường gặp khi đánh giá LLM
- Chỉ thử vài câu hỏi: Một số ví dụ thành công không đại diện cho toàn bộ tình huống sử dụng.
- Chỉ dùng một điểm tổng hợp: Điểm trung bình có thể che giấu các lỗi nghiêm trọng ở một nhóm người dùng.
- Dùng LLM chấm mà không kiểm chứng: Mô hình đánh giá có thể thiên lệch hoặc không đồng thuận với chuyên gia.
- Không cập nhật dữ liệu kiểm thử: Bộ test cũ có thể không phản ánh các tình huống mới trong thực tế.
- Không đo chi phí và tốc độ: Chất lượng đầu ra tốt nhưng quá chậm hoặc quá đắt vẫn có thể không phù hợp với sản phẩm.
- Nhầm benchmark với chất lượng thực tế: Điểm benchmark cao không bảo đảm hệ thống đáp ứng tốt mọi nhu cầu của người dùng.
10. Kết luận
LLM Evaluation là bước quan trọng để biến một ứng dụng AI từ bản thử nghiệm thành hệ thống có thể đo lường, cải thiện và vận hành đáng tin cậy. Một quy trình đánh giá tốt bắt đầu từ mục tiêu rõ ràng, bộ dữ liệu đại diện, tiêu chí phù hợp và việc phân tích lỗi có hệ thống.
Thay vì chỉ hỏi “AI trả lời có hay không?”, hãy đặt những câu hỏi cụ thể hơn: câu trả lời có đúng không, có đáp ứng yêu cầu không, có được hỗ trợ bởi dữ liệu không, và chất lượng có ổn định sau mỗi lần cập nhật không?
Tài liệu tham khảo
Tìm hiểu thêm về Data và AI tại MCNA
Nếu bạn muốn xây dựng nền tảng Python, phân tích dữ liệu và ứng dụng AI vào các bài toán thực tế, hãy tham khảo các chương trình học tại MCNA Technology School: