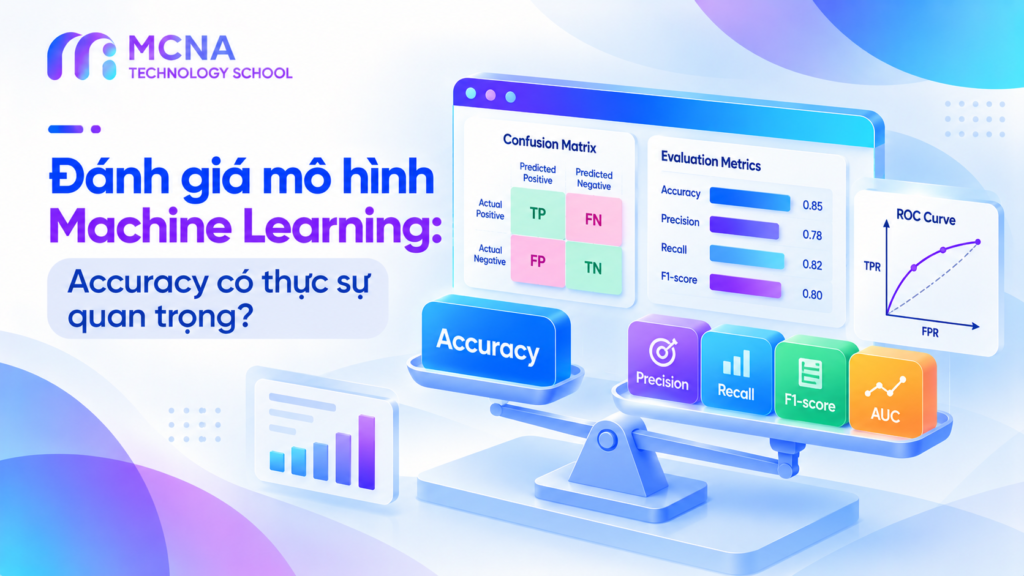
Đánh giá mô hình Machine Learning: Accuracy có thực sự quan trọng?
Trong Machine Learning, xây dựng được một mô hình dự đoán chỉ là một phần của quá trình giải quyết bài toán. Câu hỏi quan trọng hơn là: làm thế nào để biết mô hình đó có thực sự hoạt động tốt trên dữ liệu chưa từng gặp?
Một mô hình đạt Accuracy 95% nghe có vẻ rất tốt. Tuy nhiên, nếu 95% dữ liệu thuộc cùng một lớp, mô hình chỉ cần dự đoán tất cả quan sát vào lớp đó cũng có thể đạt Accuracy 95% mà không phát hiện được bất kỳ trường hợp nào thuộc lớp còn lại.
Đây là lý do đánh giá mô hình Machine Learning (Model Evaluation) không thể chỉ dựa vào một con số. Cần hiểu mô hình đang mắc những loại lỗi nào, chi phí của từng loại lỗi và liệu kết quả đánh giá có phản ánh đúng điều kiện sử dụng thực tế hay không.
Bài viết sẽ đi từ bản chất của Model Evaluation đến các chỉ số Classification và Regression, cách lựa chọn Metric, vai trò của Cross-Validation và ví dụ thực hành bằng Python.
1. Đánh giá mô hình Machine Learning là gì?
Model Evaluation là quá trình đo lường khả năng hoạt động của một mô hình Machine Learning theo các tiêu chí phù hợp với mục tiêu bài toán.
Đối với Supervised Learning, việc đánh giá thường dựa trên so sánh giữa dự đoán của mô hình và giá trị thực tế trên dữ liệu không được sử dụng để fit mô hình.
Tuy nhiên, mục tiêu không chỉ là kiểm tra mô hình dự đoán đúng bao nhiêu lần. Model Evaluation còn giúp trả lời những câu hỏi:
- Mô hình có khả năng Generalization trên dữ liệu mới hay không?
- Mô hình thường mắc loại lỗi nào?
- Kết quả có tốt hơn một Baseline đơn giản không?
- Chỉ số đánh giá có phản ánh đúng mục tiêu kinh doanh không?
- Mô hình có ổn định khi thay đổi dữ liệu hoặc điều kiện sử dụng không?
1.1. Training Performance và Generalization
Một mô hình có thể hoạt động rất tốt trên Training Set nhưng kém hiệu quả trên dữ liệu mới. Hiện tượng này thường liên quan đến Overfitting.
Ngược lại, nếu mô hình không học được những quy luật quan trọng ngay cả trên dữ liệu huấn luyện, nó có thể đang Underfitting.
Vì vậy, đánh giá mô hình cần tập trung vào khả năng Generalization thay vì chỉ nhìn vào kết quả trên Training Set.
1.2. Không tồn tại một Metric tốt nhất cho mọi bài toán
Mỗi Metric phản ánh một khía cạnh khác nhau của mô hình. Accuracy đo tỷ lệ dự đoán đúng, Recall đo khả năng nhận diện lớp dương, còn Precision cho biết mức độ đáng tin cậy của các dự đoán dương.
Trong Regression, các chỉ số như MAE, RMSE và R² lại phản ánh sai số hoặc mức độ giải thích biến thiên của biến mục tiêu.
Do đó, việc lựa chọn Metric phải bắt đầu từ bản chất bài toán, không phải từ chỉ số mà mô hình đạt giá trị cao nhất.
2. Vì sao Accuracy cao chưa chắc là mô hình tốt?
Accuracy là tỷ lệ số dự đoán đúng trên tổng số quan sát được đánh giá.
Accuracy = Số dự đoán đúng / Tổng số quan sátAccuracy trực quan và dễ hiểu, nhưng có thể gây hiểu nhầm khi dữ liệu mất cân bằng giữa các lớp.
2.1. Ví dụ về dữ liệu mất cân bằng
Giả sử một bộ dữ liệu minh họa gồm 1.000 giao dịch:
- 990 giao dịch bình thường.
- 10 giao dịch gian lận.
Nếu mô hình dự đoán toàn bộ 1.000 giao dịch là bình thường, kết quả sẽ là:
Số dự đoán đúng = 990
Tổng số giao dịch = 1.000

Accuracy = 990 / 1.000 = 99%
Mô hình đạt Accuracy 99%, nhưng không phát hiện được giao dịch gian lận nào.
Đây là ví dụ giả định nhằm giải thích bản chất của Imbalanced Data, không phải số liệu từ một hệ thống tài chính thực tế.
2.2. Accuracy bỏ qua điều gì?
Accuracy xem mỗi dự đoán đúng hoặc sai như một đơn vị đóng góp vào kết quả tổng thể. Chỉ số này không trực tiếp phân biệt giữa việc bỏ sót một giao dịch gian lận và việc đánh dấu nhầm một giao dịch bình thường.
Trong thực tế, chi phí của hai loại lỗi có thể khác nhau đáng kể.
Do đó, Accuracy phù hợp hơn khi các lớp tương đối cân bằng và chi phí của các loại lỗi không khác biệt quá lớn. Với dữ liệu mất cân bằng hoặc bài toán có chi phí sai lầm không đối xứng, cần xem xét thêm các Metric khác.
3. Confusion Matrix: Nền tảng của Classification Metrics
Confusion Matrix là bảng thống kê số lượng dự đoán đúng và sai theo từng lớp. Với Binary Classification, bảng này giúp phân biệt bốn trường hợp quan trọng.
| Thực tế / Dự đoán | Dự đoán Positive | Dự đoán Negative |
|---|---|---|
| Actual Positive | True Positive (TP) | False Negative (FN) |
| Actual Negative | False Positive (FP) | True Negative (TN) |
3.1. Ý nghĩa của TP, TN, FP và FN
- True Positive (TP): Mô hình dự đoán Positive và thực tế cũng là Positive.
- True Negative (TN): Mô hình dự đoán Negative và thực tế cũng là Negative.
- False Positive (FP): Mô hình dự đoán Positive nhưng thực tế là Negative.
- False Negative (FN): Mô hình dự đoán Negative nhưng thực tế là Positive.
Trong bài toán phát hiện gian lận, nếu quy ước Positive là giao dịch gian lận:
- FP là giao dịch bình thường bị đánh dấu nhầm là gian lận.
- FN là giao dịch gian lận bị bỏ sót.
Việc xác định rõ lớp Positive rất quan trọng vì Precision, Recall và nhiều Metric khác được tính theo lớp này.
3.2. Ví dụ Confusion Matrix
Giả sử một mô hình được đánh giá trên 1.000 giao dịch với kết quả minh họa:
| Thành phần | Số lượng |
|---|---|
| TP | 8 |
| FN | 2 |
| FP | 20 |
| TN | 970 |
Những số liệu này chỉ dùng để minh họa cách tính Metric. Từ Confusion Matrix, chúng ta có thể tính Accuracy, Precision, Recall và F1-score.
4. Precision: Khi dự đoán Positive cần đáng tin cậy
Precision đo tỷ lệ dự đoán Positive thực sự đúng trong tổng số quan sát được mô hình dự đoán là Positive.
Precision = TP / (TP + FP)Với ví dụ trên:
Precision = 8 / (8 + 20)
          = 8 / 28
          ≈ 28,57%
Điều này có nghĩa là trong các giao dịch được mô hình đánh dấu là gian lận, khoảng 28,57% thực sự là gian lận trong bộ dữ liệu minh họa.
4.1. Khi nào Precision quan trọng?
Precision đặc biệt đáng quan tâm khi False Positive tạo ra chi phí đáng kể.
Ví dụ, nếu một hệ thống tự động khóa tài khoản mỗi khi dự đoán có gian lận, False Positive có thể gây gián đoạn cho người dùng hợp lệ.
Trong tình huống đó, Precision cao có thể giúp giảm tỷ lệ cảnh báo sai trong những trường hợp được mô hình đánh dấu.
Tuy nhiên, chỉ tối ưu Precision có thể khiến mô hình bỏ sót nhiều trường hợp Positive. Vì vậy, cần xem xét đồng thời Recall.
5. Recall: Khi bỏ sót Positive là vấn đề lớn
Recall, còn gọi là Sensitivity hoặc True Positive Rate, đo tỷ lệ các quan sát Positive thực tế được mô hình phát hiện đúng.
Recall = TP / (TP + FN)Với ví dụ minh họa:
Recall = 8 / (8 + 2)
       = 8 / 10
       = 80%
Mô hình phát hiện được 80% số giao dịch gian lận trong bộ dữ liệu đánh giá.
5.1. Khi nào Recall quan trọng?
Recall thường được ưu tiên khi False Negative gây ra hậu quả lớn.
Ví dụ:
- Hệ thống sàng lọc nhằm hạn chế bỏ sót những trường hợp cần kiểm tra chuyên sâu.
- Hệ thống phát hiện gian lận cần nhận diện phần lớn các giao dịch đáng ngờ.
- Hệ thống giám sát thiết bị cần hạn chế bỏ sót những dấu hiệu hỏng hóc quan trọng.
Tuy nhiên, Recall cao không có nghĩa là mô hình tốt trong mọi trường hợp. Một mô hình dự đoán tất cả quan sát là Positive sẽ đạt Recall 100% nếu tập đánh giá có ít nhất một quan sát Positive, nhưng đồng thời có thể tạo ra rất nhiều False Positive.
6. Precision và Recall: Vì sao thường phải đánh đổi?
Trong nhiều mô hình Classification, kết quả dự đoán được tạo ra bằng cách so sánh một Score hoặc xác suất ước lượng với một Decision Threshold.
Ví dụ, mô hình có thể dự đoán Positive nếu xác suất ước lượng lớn hơn hoặc bằng 0,5.
Nếu P(Positive | X) >= Threshold:
    Dự đoán Positive

Ngược lại:
    Dự đoán Negative
Khi giảm Threshold, mô hình thường dự đoán Positive cho nhiều quan sát hơn. Điều này có thể làm Recall tăng nhưng cũng có thể làm tăng False Positive, từ đó ảnh hưởng đến Precision.
Khi tăng Threshold, mô hình thường thận trọng hơn trước khi dự đoán Positive. Precision có thể tăng trong một số trường hợp, nhưng Recall thường có nguy cơ giảm.
Đây là một xu hướng thường gặp, không phải quy luật bảo đảm Precision luôn tăng hoặc giảm đơn điệu theo Threshold trên mọi tập dữ liệu.
6.1. Lựa chọn Threshold theo chi phí sai lầm
Threshold mặc định 0,5 không nhất thiết phù hợp với mọi bài toán.
Ví dụ, hệ thống phát hiện gian lận có thể ưu tiên Recall nếu chi phí bỏ sót gian lận cao. Ngược lại, hệ thống tự động áp dụng biện pháp hạn chế tài khoản có thể cần kiểm soát False Positive chặt chẽ hơn.
Threshold nên được lựa chọn dựa trên Validation Data hoặc quy trình Cross-Validation phù hợp, sau đó mới đánh giá kết quả cuối cùng trên Test Set.
7. F1-score: Kết hợp Precision và Recall
F1-score là trung bình điều hòa của Precision và Recall.
F1 = 2 × (Precision × Recall)
         / (Precision + Recall)
Cũng có thể viết trực tiếp theo Confusion Matrix:
F1 = 2TP / (2TP + FP + FN)Với ví dụ minh họa:
TP = 8
FP = 20
FN = 2

F1 = 16 / (16 + 20 + 2)
   = 16 / 38
   ≈ 42,11%
7.1. Vì sao dùng trung bình điều hòa?
Trung bình điều hòa khiến F1-score bị ảnh hưởng mạnh khi Precision hoặc Recall thấp. Một mô hình có Recall cao nhưng Precision rất thấp sẽ khó đạt F1-score cao.
F1-score hữu ích khi muốn cân bằng Precision và Recall, đặc biệt trong các bài toán có Imbalanced Data.
7.2. Giới hạn của F1-score
F1-score không sử dụng trực tiếp số lượng True Negative. Vì vậy, chỉ số này có thể bỏ qua một phần thông tin quan trọng trong những bài toán mà khả năng nhận diện Negative cũng cần được đánh giá.
Ngoài ra, F1-score xem Precision và Recall có vai trò cân bằng theo công thức của nó. Nếu chi phí của FP và FN khác nhau đáng kể, F1-score có thể không phản ánh đầy đủ mục tiêu thực tế.
Trong trường hợp muốn ưu tiên Recall hoặc Precision rõ ràng hơn, có thể cân nhắc F-beta Score với trọng số phù hợp.
8. Accuracy, Precision, Recall và F1-score khác nhau thế nào?
| Metric | Đo lường | Điểm cần lưu ý |
|---|---|---|
| Accuracy | Tỷ lệ dự đoán đúng trên toàn bộ quan sát | Có thể gây hiểu nhầm khi dữ liệu mất cân bằng |
| Precision | Tỷ lệ Positive dự đoán đúng trong các dự đoán Positive | Phù hợp khi cần kiểm soát False Positive |
| Recall | Tỷ lệ Positive thực tế được phát hiện | Phù hợp khi cần hạn chế False Negative |
| F1-score | Kết hợp Precision và Recall bằng trung bình điều hòa | Không trực tiếp phản ánh True Negative hoặc chi phí thực tế |
Quay lại ví dụ 1.000 giao dịch với TP = 8, FN = 2, FP = 20 và TN = 970:
| Metric | Giá trị minh họa |
|---|---|
| Accuracy | 97,8% |
| Precision | 28,57% |
| Recall | 80% |
| F1-score | 42,11% |
Mặc dù Accuracy đạt 97,8%, Precision chỉ khoảng 28,57%. Đây là minh họa cho thấy một mô hình có tỷ lệ dự đoán đúng tổng thể cao nhưng vẫn tạo ra nhiều cảnh báo sai so với số trường hợp Positive được phát hiện.
9. ROC Curve và ROC-AUC là gì?
Accuracy, Precision, Recall và F1-score thường được tính từ các nhãn dự đoán tại một Threshold cụ thể. Trong khi đó, ROC Curve xem xét hành vi của mô hình khi thay đổi Threshold.
9.1. ROC Curve
ROC Curve biểu diễn mối quan hệ giữa:
- True Positive Rate (TPR): Chính là Recall.
- False Positive Rate (FPR): Tỷ lệ Negative thực tế bị dự đoán sai thành Positive.
TPR = TP / (TP + FN)

FPR = FP / (FP + TN)
ROC Curve giúp quan sát sự đánh đổi giữa khả năng phát hiện Positive và tỷ lệ cảnh báo sai trên các quan sát Negative khi thay đổi Threshold.
9.2. ROC-AUC
ROC-AUC là diện tích dưới ROC Curve. Chỉ số này có thể được diễn giải theo khả năng xếp hạng: với một quan sát Positive và một quan sát Negative được lấy ngẫu nhiên, ROC-AUC phản ánh xác suất mô hình xếp Score của Positive cao hơn Negative, có tính đến trường hợp bằng điểm theo quy ước AUC.
ROC-AUC bằng 0,5 tương ứng với khả năng xếp hạng ở mức ngẫu nhiên theo cách diễn giải này. Giá trị gần 1 cho thấy khả năng phân biệt thứ hạng giữa hai lớp tốt hơn.
Tuy nhiên, ROC-AUC không trực tiếp cho biết Precision tại Threshold triển khai, cũng không đánh giá chất lượng Calibration của xác suất dự đoán.
10. PR Curve và PR-AUC: Khi Positive là lớp hiếm
Precision-Recall Curve (PR Curve) biểu diễn mối quan hệ giữa Precision và Recall khi thay đổi Threshold.
PR Curve đặc biệt hữu ích khi lớp Positive hiếm và người phân tích quan tâm đến hiệu quả nhận diện lớp đó.
10.1. Vì sao PR Curve hữu ích với Imbalanced Data?
Trong dữ liệu có rất nhiều Negative, False Positive Rate có thể vẫn thấp dù số lượng False Positive đáng kể.
Precision phản ánh trực tiếp tỷ lệ Positive đúng trong các dự đoán Positive. Vì vậy, PR Curve có thể cho thấy rõ hơn chất lượng của các cảnh báo Positive trong những bài toán như phát hiện gian lận hoặc nhận diện sự kiện hiếm.
10.2. PR-AUC và Average Precision
PR-AUC là diện tích dưới Precision-Recall Curve theo một phương pháp tích phân xác định. Trong scikit-learn, average_precision_score tính Average Precision (AP) bằng tổng có trọng số của Precision theo mức tăng Recall.
AP và diện tích PR Curve tính bằng quy tắc hình thang không nhất thiết bằng nhau. Vì vậy, khi báo cáo kết quả cần ghi rõ đang sử dụng PR-AUC theo phương pháp nào hay Average Precision.
Đường cơ sở của Precision trong bài toán Binary Classification liên quan đến tỷ lệ Positive của tập dữ liệu. Do đó, khi so sánh PR Curve giữa các bộ dữ liệu có tỷ lệ Positive khác nhau, cần xem xét sự khác biệt này.
11. Đánh giá Multiclass Classification
Trong Multiclass Classification, mô hình cần phân loại một quan sát vào một trong nhiều lớp, chẳng hạn phân loại sản phẩm thành các nhóm khác nhau.
Precision, Recall và F1-score vẫn có thể được sử dụng, nhưng cần xác định cách tổng hợp kết quả giữa các lớp.
11.1. Macro Average
Macro Average tính Metric riêng cho từng lớp rồi lấy trung bình không trọng số.
Cách này xem mỗi lớp có vai trò ngang nhau, bất kể số lượng quan sát của từng lớp.
11.2. Weighted Average
Weighted Average tính trung bình Metric giữa các lớp, với trọng số dựa trên số lượng quan sát thực tế của từng lớp.
Cách này phản ánh phân phối lớp trong dữ liệu đánh giá, nhưng kết quả có thể bị chi phối bởi những lớp có nhiều quan sát.
11.3. Micro Average
Micro Average tổng hợp TP, FP và FN trên các lớp trước khi tính Metric.
Trong bài toán Multiclass một nhãn, khi xét toàn bộ các lớp, Micro Precision, Micro Recall và Micro F1 bằng Accuracy.
Với dữ liệu mất cân bằng, nên xem kết quả theo từng lớp cùng Macro Average và Weighted Average, thay vì chỉ sử dụng một chỉ số tổng hợp.
12. Đánh giá Regression: Không thể dùng Accuracy như Classification
Không phải mọi bài toán Machine Learning đều là Classification. Trong Regression, mô hình dự đoán một giá trị liên tục, chẳng hạn doanh thu, giá nhà hoặc nhu cầu sản phẩm.
Vì dự đoán thường không trùng khớp tuyệt đối với giá trị thực tế, Accuracy theo định nghĩa Classification không phải Metric tiêu chuẩn cho Regression.
12.1. Mean Absolute Error (MAE)
MAE đo trung bình độ lớn sai số tuyệt đối giữa giá trị thực tế và dự đoán.
MAE = (1/n) × Σ |y_i - ŷ_i|MAE có cùng đơn vị với biến mục tiêu, giúp diễn giải sai số theo ngữ cảnh thực tế.
12.2. Root Mean Squared Error (RMSE)
RMSE là căn bậc hai của trung bình bình phương sai số.
RMSE = sqrt((1/n) × Σ(y_i - ŷ_i)²)Do bình phương sai số trước khi lấy trung bình, RMSE nhạy hơn với những sai số lớn so với MAE.
12.3. R-squared (R²)
R² so sánh tổng bình phương sai số của mô hình với tổng bình phương độ lệch của giá trị thực tế quanh trung bình.
R² = 1 - [Σ(y_i - ŷ_i)² / Σ(y_i - ȳ)²]Trong đó ȳ là trung bình của giá trị thực tế trên tập đánh giá.
R² bằng 1 thể hiện dự đoán hoàn hảo. R² bằng 0 tương ứng với tổng bình phương sai số bằng cách dự đoán trung bình của giá trị thực tế trên tập đánh giá. R² có thể âm nếu mô hình có tổng bình phương sai số lớn hơn Baseline này.
Với tập đánh giá có biến mục tiêu không thay đổi, công thức R² thông thường không được xác định theo cách diễn giải chuẩn.
12.4. Chọn Metric nào cho Regression?
| Metric | Đặc điểm | Khi nên cân nhắc |
|---|---|---|
| MAE | Đo sai số tuyệt đối trung bình | Khi muốn diễn giải sai số trực tiếp theo đơn vị mục tiêu |
| RMSE | Nhạy hơn với sai số lớn | Khi những sai số lớn cần được chú ý nhiều hơn |
| R² | Đo mức cải thiện tương đối về tổng bình phương sai số so với Baseline trung bình | Khi cần một chỉ số bổ sung về mức độ phù hợp của mô hình |
13. Train, Validation và Test: Đánh giá đúng quy trình
Một Metric chỉ đáng tin cậy khi quy trình tạo ra nó được thiết kế phù hợp.
13.1. Vai trò của từng tập dữ liệu
- Training Set: Dùng để fit mô hình và các bước tiền xử lý cần học từ dữ liệu.
- Validation Set: Dùng để lựa chọn mô hình, Hyperparameters và Decision Threshold.
- Test Set: Dùng để đánh giá cuối cùng sau khi các quyết định lựa chọn đã được hoàn tất.
              Dataset
                 |
                 v
          Chia dữ liệu
                 |
        +--------+--------+
        |                 |
        v                 v
   Training Data       Test Data
        |                 |
        v                 |
  Cross-Validation        |
        |                 |
        v                 |
  Chọn Hyperparameters    |
        |                 |
        v                 |
  Fit mô hình cuối        |
        |                 |
        +--------+--------+
                 |
                 v
       Đánh giá trên Test
                 |
                 v
        Báo cáo kết quả
13.2. Cross-Validation là gì?
Cross-Validation đánh giá mô hình qua nhiều lần chia dữ liệu huấn luyện thành các phần fit và validation khác nhau.
Ví dụ, với 5-Fold Cross-Validation, dữ liệu được chia thành năm phần. Mỗi lần, bốn phần được dùng để fit mô hình và một phần được dùng để đánh giá. Quy trình được lặp lại để mỗi phần đóng vai trò validation một lần.
Điểm trung bình giữa các Fold giúp đánh giá mô hình ít phụ thuộc hơn vào một lần chia dữ liệu cụ thể. Tuy nhiên, các Fold không hoàn toàn độc lập và độ lệch chuẩn giữa các Fold không nên tự động được xem là khoảng tin cậy thống kê.
13.3. Chọn cách chia dữ liệu phù hợp
Với Classification, Stratified Split thường hữu ích để duy trì tỷ lệ các lớp tương đối giống nhau giữa các tập.
Với dữ liệu chuỗi thời gian, việc chia ngẫu nhiên có thể không phù hợp vì làm mất thứ tự thời gian hoặc gây rò rỉ thông tin tương lai.
Nếu nhiều quan sát thuộc cùng một khách hàng, bệnh nhân hoặc thiết bị, có thể cần Group-Based Split để tránh cùng một thực thể xuất hiện ở cả Training và Test theo cách khiến đánh giá quá lạc quan.
14. Thực hành đánh giá mô hình Classification bằng Python
Ví dụ dưới đây sử dụng bộ dữ liệu Breast Cancer Wisconsin trong scikit-learn để minh họa các Metric Classification.
Đây là dữ liệu học thuật dùng cho thực hành Machine Learning, không phải mô hình được xác nhận để sử dụng trong chẩn đoán y khoa.
Trong bộ dữ liệu gốc, nhãn 0 là malignant và nhãn 1 là benign. Để ví dụ tập trung vào khả năng nhận diện malignant, chúng ta chuyển nhãn thành 1 cho malignant và 0 cho benign.
14.1. Cài đặt thư viện
pip install numpy pandas matplotlib scikit-learn14.2. Huấn luyện và tính các Metric
import numpy as np
import matplotlib.pyplot as plt

from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score,
    f1_score,
    confusion_matrix,
    classification_report,
    roc_auc_score,
    average_precision_score,
    RocCurveDisplay,
    PrecisionRecallDisplay
)

# 1. Tải dữ liệu
data = load_breast_cancer()

X = data.data

# Quy ước Positive = malignant
y = (data.target == 0).astype(int)

# 2. Chia Train/Test
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

# 3. Xây dựng Pipeline
model = Pipeline([
    ("scaler", StandardScaler()),
    ("classifier", LogisticRegression(
        max_iter=1000
    ))
])

# 4. Huấn luyện
model.fit(X_train, y_train)

# 5. Dự đoán nhãn và xác suất
y_pred = model.predict(X_test)
y_score = model.predict_proba(X_test)[:, 1]

# 6. Tính Metrics
print("Accuracy:", accuracy_score(y_test, y_pred))
print("Precision:", precision_score(y_test, y_pred))
print("Recall:", recall_score(y_test, y_pred))
print("F1-score:", f1_score(y_test, y_pred))

print("ROC-AUC:", roc_auc_score(y_test, y_score))

print(
    "Average Precision:",
    average_precision_score(y_test, y_score)
)

# 7. Confusion Matrix
cm = confusion_matrix(
    y_test,
    y_pred,
    labels=[0, 1]
)

print("Confusion Matrix:")
print(cm)

print(
    classification_report(
        y_test,
        y_pred,
        target_names=["Benign", "Malignant"]
    )
)

# 8. ROC Curve
RocCurveDisplay.from_predictions(
    y_test,
    y_score
)

plt.title("ROC Curve")
plt.show()

# 9. Precision-Recall Curve
PrecisionRecallDisplay.from_predictions(
    y_test,
    y_score
)

plt.title("Precision-Recall Curve")
plt.show()
14.3. Giải thích đoạn mã
train_test_split(): Tách dữ liệu để đánh giá trên các quan sát chưa được dùng để fit mô hình.stratify=y: Giúp duy trì tỷ lệ lớp tương đối giống nhau giữa Train và Test.Pipeline: Kết hợp StandardScaler và Logistic Regression, hạn chế Data Leakage trong tiền xử lý.predict(): Trả về nhãn dự đoán.predict_proba(): Trả về xác suất ước lượng của các lớp.accuracy_score(): Tính tỷ lệ dự đoán đúng.precision_score(): Đo Precision của lớp Positive.recall_score(): Đo Recall của lớp Positive.f1_score(): Tính F1-score.roc_auc_score(): Đánh giá khả năng xếp hạng theo ROC-AUC.average_precision_score(): Tính Average Precision từ các Score dự đoán.
Đoạn mã không giả định trước kết quả của mô hình. Các giá trị Metric thực tế sẽ được tính khi chạy chương trình.
15. Thử thay đổi Decision Threshold
Với Logistic Regression, predict() thường sử dụng quy tắc quyết định tương đương Threshold 0,5 cho Binary Classification khi làm việc với xác suất dự đoán.
Để nghiên cứu sự đánh đổi giữa Precision và Recall, có thể thử nhiều Threshold trên dữ liệu đánh giá.
from sklearn.metrics import (
    precision_score,
    recall_score,
    f1_score
)

thresholds = [0.3, 0.5, 0.7]

for threshold in thresholds:
    predictions = (
        y_score >= threshold
    ).astype(int)

    precision = precision_score(
        y_test,
        predictions,
        zero_division=0
    )

    recall = recall_score(
        y_test,
        predictions,
        zero_division=0
    )

    f1 = f1_score(
        y_test,
        predictions,
        zero_division=0
    )

    print(f"Threshold: {threshold}")
    print(f"Precision: {precision:.4f}")
    print(f"Recall: {recall:.4f}")
    print(f"F1-score: {f1:.4f}")
    print("-" * 30)
Đoạn mã này minh họa ảnh hưởng của Threshold đến các Metric. Nếu dùng tập test để quan sát kết quả, không nên chọn Threshold tối ưu dựa trên những kết quả đó rồi báo cáo chính điểm test ấy như một đánh giá cuối cùng độc lập.
Trong quy trình triển khai đúng, Threshold nên được lựa chọn bằng Validation Set hoặc Cross-Validation trên dữ liệu huấn luyện, sau đó được cố định trước khi đánh giá trên Test Set.
16. Những sai lầm phổ biến khi đánh giá mô hình
16.1. Chỉ báo cáo Accuracy
Accuracy không mô tả đầy đủ loại lỗi mô hình mắc phải. Với Classification, nên bổ sung Confusion Matrix và các Metric phù hợp với chi phí False Positive và False Negative.
16.2. Đánh giá trên dữ liệu đã huấn luyện
Training Performance thường lạc quan hơn khả năng Generalization. Cần sử dụng Validation hoặc Test Data phù hợp để đánh giá mô hình trên các quan sát chưa được dùng để fit.
16.3. Data Leakage trong tiền xử lý
Nếu StandardScaler, PCA, Feature Selection hoặc những phép biến đổi cần học từ dữ liệu được fit trước khi chia Train/Test, thông tin từ tập test có thể ảnh hưởng đến mô hình.
Pipeline là một công cụ hữu ích để hạn chế sai lầm này khi sử dụng Cross-Validation.
16.4. So sánh mô hình trên các tập dữ liệu khác nhau
Nếu hai mô hình được đánh giá trên các tập test có phân phối khác nhau, kết quả có thể không so sánh trực tiếp được.
Khi thực hiện Model Comparison, nên sử dụng cùng tập đánh giá, cùng cách định nghĩa Metric và cùng các điều kiện quan trọng khác.
16.5. Bỏ qua Baseline
Một mô hình phức tạp không nhất thiết tốt hơn một phương pháp đơn giản.
Trong Classification, có thể sử dụng DummyClassifier làm Baseline. Trong Regression, có thể sử dụng DummyRegressor để dự đoán trung bình hoặc một thống kê đơn giản khác.
Baseline giúp xác định mô hình có tạo ra giá trị thực sự so với một chiến lược dự đoán cơ bản hay không.
16.6. Nhầm lẫn giữa khả năng xếp hạng và chất lượng xác suất
ROC-AUC và Average Precision đánh giá khả năng xếp hạng các quan sát theo Score. Chúng không trực tiếp bảo đảm xác suất dự đoán được Calibration tốt.
Nếu hệ thống cần sử dụng xác suất để ra quyết định, có thể cần đánh giá thêm Calibration Curve, Brier Score hoặc Log Loss tùy bài toán.
17. Quy trình đánh giá mô hình Machine Learning trong thực tế
Một quy trình Model Evaluation đáng tin cậy nên bắt đầu từ mục tiêu sử dụng mô hình và chi phí của những quyết định sai.
- Xác định mục tiêu: Mô hình dự đoán điều gì và kết quả sẽ được sử dụng như thế nào?
- Phân tích dữ liệu: Kiểm tra phân phối lớp, chất lượng nhãn, Outliers và khả năng thay đổi phân phối theo thời gian.
- Chọn Metric chính: Xác định chỉ số phù hợp với mục tiêu trước khi thử nhiều mô hình.
- Thiết kế cách chia dữ liệu: Sử dụng Stratified, Group-Based hoặc Time-Based Split khi cần.
- Xây dựng Baseline: So sánh với một chiến lược đơn giản để có điểm tham chiếu.
- Cross-Validation: Đánh giá và lựa chọn Hyperparameters trên dữ liệu huấn luyện.
- Điều chỉnh Threshold: Nếu cần, lựa chọn Threshold theo chi phí sai lầm trên dữ liệu validation.
- Đánh giá cuối cùng: Sử dụng Test Set chưa tham gia vào quá trình lựa chọn.
- Kiểm tra khả năng triển khai: Xem xét độ trễ dự đoán, tính ổn định, Calibration và sự thay đổi dữ liệu trong vận hành.
Đối với những hệ thống có tác động lớn, nên xem xét thêm kết quả trên các nhóm dữ liệu có ý nghĩa, mức độ bất định của Metric và kế hoạch giám sát sau triển khai.
18. Kết luận: Accuracy có thực sự quan trọng?
Accuracy vẫn là một Metric quan trọng, đặc biệt khi các lớp tương đối cân bằng và chi phí của các loại lỗi gần nhau. Tuy nhiên, Accuracy không đủ để kết luận một mô hình Machine Learning có thực sự tốt hay không.
Precision và Recall giúp hiểu rõ hơn hai loại sai lầm quan trọng trong Classification. F1-score hỗ trợ đánh giá sự cân bằng giữa chúng, trong khi ROC-AUC và PR Curve cung cấp góc nhìn về khả năng phân biệt hoặc nhận diện Positive khi thay đổi Threshold.
Với Regression, MAE, RMSE và R² phản ánh những khía cạnh khác nhau của sai số dự đoán. Không có một Metric duy nhất phù hợp cho mọi tình huống.
Quan trọng hơn cả, một kết quả đánh giá chỉ có ý nghĩa khi được tạo ra từ quy trình đúng: chia dữ liệu phù hợp, tránh Data Leakage, lựa chọn mô hình bằng Validation hoặc Cross-Validation và sử dụng Test Set độc lập cho bước đánh giá cuối cùng.
Hiểu được những nguyên tắc này sẽ giúp người học chuyển từ việc chỉ xây dựng mô hình sang việc đánh giá, lựa chọn và triển khai Machine Learning một cách có cơ sở khoa học.
19. Tài liệu tham khảo
- scikit-learn. Metrics and Scoring: Quantifying the Quality of Predictions. Tài liệu chính thức về Classification Metrics và Regression Metrics. https://scikit-learn.org/stable/modules/model_evaluation.html
- scikit-learn. Confusion Matrix. Tài liệu về cách tính và diễn giải Confusion Matrix. https://scikit-learn.org/stable/modules/generated/sklearn.metrics.confusion_matrix.html
- scikit-learn. Precision, Recall and F-measures. Tài liệu về các chỉ số Classification. https://scikit-learn.org/stable/modules/model_evaluation.html#precision-recall-f-measure-metrics
- scikit-learn. ROC AUC Score. Tài liệu về ROC-AUC và cách tính chỉ số. https://scikit-learn.org/stable/modules/generated/sklearn.metrics.roc_auc_score.html
- scikit-learn. Average Precision Score. Tài liệu về Average Precision. https://scikit-learn.org/stable/modules/generated/sklearn.metrics.average_precision_score.html
- scikit-learn. Cross-validation: Evaluating Estimator Performance. Tài liệu về Cross-Validation. https://scikit-learn.org/stable/modules/cross_validation.html
- scikit-learn. Common Pitfalls and Recommended Practices. Tài liệu về Data Leakage và thực hành đánh giá mô hình. https://scikit-learn.org/stable/common_pitfalls.html
- Saito, T., & Rehmsmeier, M. (2015). The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets. PLOS ONE. https://doi.org/10.1371/journal.pone.0118432
20. Học thêm Data, AI và Machine Learning tại MCNA
Nếu bạn muốn xây dựng nền tảng về Python, Data Analysis và ứng dụng AI trong công việc, có thể tham khảo các chương trình học tại MCNA Technology School:
- Combo 5 khóa AI & Power BI: Tìm hiểu chương trình Combo 5 khóa AI & Power BI
- Combo Python: Tìm hiểu chương trình Combo Python
Tác giả
Nguyễn Quốc Hải – Data Analyst tại MCNA Technology School
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp lớn như Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
🌐 Website: mcna.vn
📘 Facebook: facebook.com/mcnatechnologyschool
▶️ YouTube: youtube.com/@mcna.technology.school
💼 LinkedIn: linkedin.com/company/mcna-vn
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B, TT2, Văn Quán, Hà Đông
📍 TP.HCM: The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu