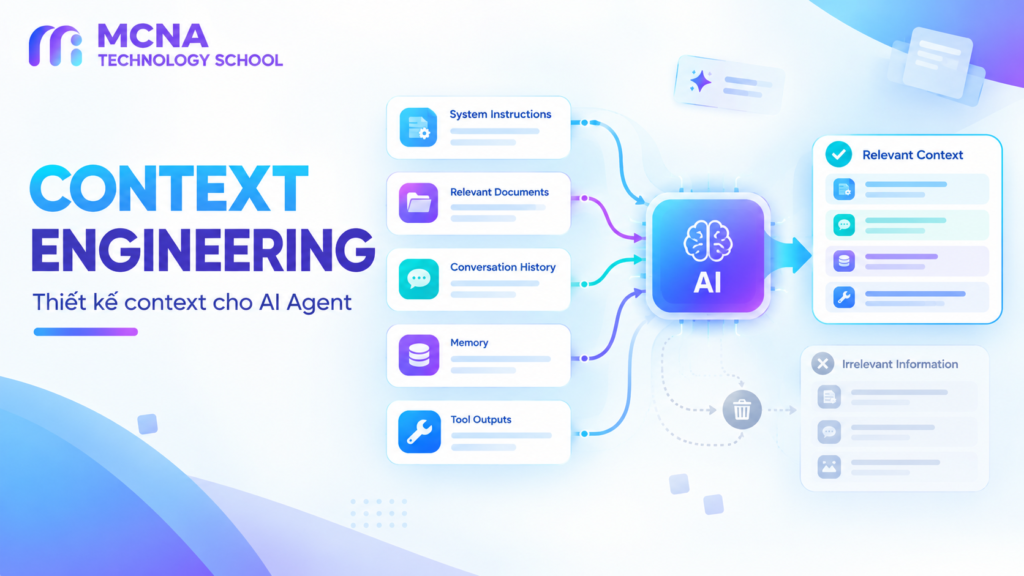
Context Engineering là gì? Cách thiết kế context để LLM và AI Agent hoạt động hiệu quả
Khi làm việc với Large Language Model (LLM), nhiều người thường tập trung vào việc viết prompt sao cho rõ ràng và chi tiết. Tuy nhiên, với những ứng dụng AI phức tạp, đặc biệt là AI Agent có khả năng sử dụng công cụ và thực hiện nhiều bước liên tiếp, prompt tốt thôi là chưa đủ.
Mô hình còn cần những thông tin phù hợp để hiểu nhiệm vụ, dữ liệu liên quan để đưa ra quyết định, lịch sử tương tác để duy trì tính nhất quán và kết quả từ các công cụ để tiếp tục xử lý công việc.
Đây là lúc Context Engineering trở nên quan trọng. Thay vì chỉ tối ưu câu lệnh đầu vào, phương pháp này tập trung vào cách lựa chọn, tổ chức và cập nhật toàn bộ thông tin mà mô hình có thể sử dụng tại mỗi bước xử lý.
Trong bài viết này, MCNA Technology School sẽ cùng bạn tìm hiểu Context Engineering là gì, khác Prompt Engineering như thế nào và cách áp dụng vào quá trình xây dựng ứng dụng LLM, AI Agent.
1. Context Engineering là gì?
Context Engineering là quá trình thiết kế, lựa chọn, tổ chức và quản lý thông tin được cung cấp cho mô hình ngôn ngữ lớn tại thời điểm mô hình thực hiện một tác vụ.
Context có thể bao gồm nhiều thành phần, chẳng hạn:
- Instructions: Các chỉ dẫn xác định vai trò, mục tiêu và quy tắc hoạt động của mô hình.
- User input: Yêu cầu hoặc câu hỏi trực tiếp từ người dùng.
- Conversation history: Lịch sử hội thoại cần thiết để duy trì ngữ cảnh.
- External data: Dữ liệu được truy xuất từ tài liệu, cơ sở dữ liệu hoặc hệ thống bên ngoài.
- Tool results: Kết quả trả về từ các công cụ mà mô hình sử dụng.
- Memory: Những thông tin quan trọng được lưu giữ để sử dụng lại khi cần.
- Structured state: Trạng thái hiện tại của nhiệm vụ, các bước đã hoàn thành và những việc còn phải xử lý.
Không phải ứng dụng nào cũng cần tất cả những thành phần trên. Công việc của Context Engineering là xác định thông tin nào thực sự hữu ích, đưa chúng vào đúng thời điểm và tránh làm context trở nên quá dài hoặc chứa nhiều dữ liệu không liên quan.
Có thể hiểu đơn giản: nếu prompt là một phần của thông tin đầu vào, thì Context Engineering là quá trình thiết kế toàn bộ môi trường thông tin mà mô hình sử dụng để tạo ra câu trả lời hoặc thực hiện hành động.
2. Context Engineering khác Prompt Engineering như thế nào?
Prompt Engineering và Context Engineering có liên quan chặt chẽ với nhau nhưng không hoàn toàn giống nhau.
Prompt Engineering tập trung vào việc xây dựng và tối ưu câu lệnh, hướng dẫn hoặc cấu trúc yêu cầu để mô hình phản hồi theo mong muốn.
Context Engineering có phạm vi rộng hơn: ngoài việc viết instructions, nó còn xem xét cách đưa dữ liệu, lịch sử hội thoại, kết quả công cụ và bộ nhớ vào context tại từng bước xử lý.
| Tiêu chí | Prompt Engineering | Context Engineering |
|---|---|---|
| Mục tiêu chính | Tối ưu cách diễn đạt và cấu trúc chỉ dẫn | Tối ưu toàn bộ thông tin cung cấp cho mô hình |
| Thành phần trọng tâm | Prompt, instructions, ví dụ đầu vào và đầu ra | Instructions, dữ liệu, lịch sử, memory, tool results và trạng thái tác vụ |
| Phạm vi | Thường tập trung vào cách yêu cầu mô hình thực hiện nhiệm vụ | Bao gồm cả việc chọn, cập nhật và loại bỏ thông tin trong quá trình vận hành |
| Tình huống điển hình | Viết prompt để phân loại phản hồi khách hàng | Xây dựng agent có thể đọc dữ liệu, tra cứu thông tin và xử lý nhiều bước |
Ví dụ, khi xây dựng chatbot hỗ trợ khách hàng, Prompt Engineering giúp xác định cách chatbot giao tiếp, giọng điệu và nguyên tắc trả lời. Context Engineering còn quyết định chatbot cần biết thông tin nào về khách hàng, sản phẩm, lịch sử yêu cầu và kết quả tra cứu đơn hàng trước khi phản hồi.
Hai phương pháp này bổ trợ cho nhau. Một prompt tốt vẫn quan trọng, nhưng hiệu quả của hệ thống còn phụ thuộc vào chất lượng và tính phù hợp của context được cung cấp.
3. Context Window là gì và vì sao context quan trọng?
Context Window là lượng thông tin mà mô hình có thể tham chiếu trong một lần xử lý, được tính bằng token. Token có thể tương ứng với một từ, một phần của từ, dấu câu hoặc một đơn vị văn bản khác, tùy cách tokenizer hoạt động.
Context Window không chỉ bao gồm câu hỏi mới nhất của người dùng. Tùy kiến trúc và cách triển khai, nó còn có thể chứa instructions, lịch sử hội thoại, dữ liệu được truy xuất, kết quả công cụ và những thành phần khác trong yêu cầu gửi đến mô hình.
Context Window có giới hạn. Khi hệ thống liên tục thêm thông tin mà không kiểm soát, context có thể trở nên quá dài, tăng chi phí xử lý hoặc khiến mô hình khó tập trung vào những dữ kiện quan trọng.
3.1. Nhiều thông tin hơn chưa chắc tốt hơn
Giả sử một AI Agent được giao nhiệm vụ tìm nguyên nhân doanh thu giảm trong tháng gần nhất. Hệ thống có thể cung cấp toàn bộ báo cáo kinh doanh, lịch sử hội thoại, dữ liệu marketing, thông tin sản phẩm và hàng trăm trang tài liệu nội bộ.
Tuy nhiên, nếu nhiệm vụ chỉ yêu cầu phân tích doanh thu theo kênh bán hàng, việc đưa quá nhiều tài liệu không liên quan có thể làm tăng lượng thông tin cần xử lý mà không giúp ích tương xứng cho kết quả.
Một context được thiết kế tốt nên ưu tiên dữ liệu đúng thời kỳ, chỉ số cần phân tích, định nghĩa metric và những thông tin có khả năng ảnh hưởng đến kết luận.
3.2. Context không phải là toàn bộ kiến thức đã học của mô hình
Cần phân biệt context với dữ liệu huấn luyện của LLM. Dữ liệu huấn luyện góp phần hình thành các tham số và khả năng của mô hình, trong khi context là thông tin được cung cấp để mô hình tham chiếu trong quá trình tạo đầu ra.
Vì vậy, đưa một tài liệu vào context không đồng nghĩa với việc huấn luyện lại mô hình. Tương tự, mở rộng Context Window cũng không tự động bảo đảm rằng mô hình sẽ sử dụng mọi thông tin trong đó một cách chính xác.
4. Những thành phần quan trọng của Context Engineering
Khi xây dựng một ứng dụng LLM hoặc AI Agent, có thể xem xét context thông qua các thành phần sau.
4.1. Instructions và quy tắc hoạt động
Instructions xác định nhiệm vụ, phạm vi trách nhiệm, định dạng đầu ra và những giới hạn mà mô hình cần tuân theo.
Ví dụ, một AI Agent phân tích dữ liệu có thể được hướng dẫn chỉ đưa ra kết luận dựa trên kết quả truy vấn, phân biệt rõ dữ kiện và giả định, đồng thời nêu những giới hạn của phân tích khi dữ liệu chưa đầy đủ.
Instructions nên rõ ràng, nhất quán và tránh các yêu cầu mâu thuẫn với nhau.
4.2. Dữ liệu bên ngoài
Đối với những câu hỏi cần thông tin chuyên biệt hoặc dữ liệu mới, hệ thống có thể lấy thông tin từ tài liệu, cơ sở dữ liệu, API hoặc các nguồn được cho phép khác.
Thay vì đưa toàn bộ dữ liệu vào context, hệ thống nên chọn những phần liên quan trực tiếp đến nhiệm vụ hiện tại. Với kho tài liệu lớn, cơ chế retrieval có thể giúp tìm ra các đoạn thông tin phù hợp trước khi gửi chúng đến LLM.
Chất lượng của dữ liệu được truy xuất rất quan trọng. Nếu context chứa thông tin lỗi thời, sai lệch hoặc không liên quan, mô hình vẫn có thể đưa ra câu trả lời thiếu chính xác.
4.3. Conversation History
Lịch sử hội thoại giúp mô hình hiểu những gì đã được trao đổi, các lựa chọn trước đó và ý nghĩa của những câu hỏi phụ thuộc vào ngữ cảnh.
Tuy nhiên, không phải mọi tin nhắn cũ đều cần được giữ lại. Khi cuộc hội thoại kéo dài, hệ thống có thể tóm tắt các nội dung quan trọng, loại bỏ những phần không còn cần thiết hoặc chỉ giữ lại các lượt trao đổi liên quan đến nhiệm vụ hiện tại.
4.4. Memory
Memory là cơ chế lưu trữ và truy xuất những thông tin có ích qua nhiều bước hoặc nhiều phiên làm việc. Ví dụ, một agent xử lý dự án dài hạn có thể lưu trạng thái công việc, các quyết định đã thống nhất và những vấn đề chưa được giải quyết.
Memory không nhất thiết phải chứa toàn bộ lịch sử tương tác. Trên thực tế, lưu những thông tin có giá trị và truy xuất chúng khi cần thường hữu ích hơn việc đưa tất cả dữ liệu cũ vào mọi yêu cầu.
4.5. Tool Results và trạng thái tác vụ
AI Agent có thể sử dụng công cụ để truy vấn cơ sở dữ liệu, thực thi mã, tìm kiếm tài liệu hoặc gọi API. Kết quả từ những công cụ này trở thành thông tin quan trọng cho bước xử lý tiếp theo.
Ví dụ, một agent phân tích doanh thu có thể thực hiện lần lượt:
- Nhận yêu cầu phân tích doanh thu theo tháng.
- Truy vấn dữ liệu từ cơ sở dữ liệu.
- Nhận kết quả truy vấn và kiểm tra các chỉ số.
- Tính toán mức tăng trưởng hoặc so sánh các nhóm sản phẩm.
- Tổng hợp kết quả thành báo cáo.
Ở mỗi bước, hệ thống cần giữ lại những kết quả có giá trị, đồng thời theo dõi tiến độ để tránh lặp lại công việc hoặc đưa ra kết luận dựa trên trạng thái không còn chính xác.
5. Quy trình Context Engineering trong thực tế
Context Engineering không phải là một công thức cố định. Tùy bài toán, hệ thống có thể áp dụng quy trình gồm các bước sau.
Bước 1: Xác định nhiệm vụ và tiêu chí thành công
Trước tiên, cần xác định mô hình phải tạo ra kết quả gì, kết quả đó được đánh giá bằng tiêu chí nào và những thông tin nào có thể ảnh hưởng đến quyết định.
Ví dụ, với một agent hỗ trợ phân tích kinh doanh, mục tiêu có thể là xác định các nhóm sản phẩm có doanh thu giảm mạnh trong tháng gần nhất, so sánh với tháng trước và trình bày các bằng chứng từ dữ liệu.
Bước 2: Xác định nguồn thông tin cần thiết
Liệt kê các nguồn mà mô hình có thể sử dụng, chẳng hạn dữ liệu bán hàng, định nghĩa chỉ số, lịch sử yêu cầu và kết quả từ những công cụ phân tích.
Đồng thời, cần xác định quyền truy cập và mức độ tin cậy của từng nguồn. Không nên mặc định rằng mọi thông tin được tìm thấy đều chính xác hoặc được phép sử dụng.
Bước 3: Chọn thông tin phù hợp
Chỉ đưa vào context những thông tin có liên quan đến câu hỏi hiện tại. Nếu có nhiều tài liệu, có thể dùng retrieval, bộ lọc metadata hoặc truy vấn dữ liệu có cấu trúc để thu hẹp phạm vi.
Đây là bước đặc biệt quan trọng khi làm việc với kho tài liệu lớn hoặc các agent có nhiều công cụ.
Bước 4: Tổ chức và định dạng context
Thông tin cần được trình bày theo cấu trúc dễ phân biệt, chẳng hạn tách instructions, dữ liệu nguồn, kết quả công cụ và trạng thái nhiệm vụ thành các phần riêng biệt.
Nếu thông tin có nguồn gốc hoặc thời điểm cập nhật quan trọng, hãy giữ lại metadata cần thiết. Với các kết quả truy xuất, nên tránh làm mất mối liên hệ giữa nội dung và tài liệu nguồn.
Bước 5: Cập nhật context trong quá trình thực thi
Đối với tác vụ nhiều bước, context nên được cập nhật dựa trên kết quả mới. Thông tin đã lỗi thời có thể được thay thế; kết quả quan trọng được lưu lại; phần lịch sử dài có thể được tóm tắt khi không còn cần giữ nguyên văn.
Việc cập nhật cần có quy tắc rõ ràng để không vô tình loại bỏ dữ kiện quan trọng hoặc giữ lại những kết luận chưa được xác minh.
Bước 6: Đánh giá và cải thiện
Cuối cùng, cần đánh giá chất lượng đầu ra trên những tình huống thực tế. Nếu agent trả lời sai, hãy kiểm tra xem nguyên nhân đến từ dữ liệu nguồn, retrieval, instructions, lịch sử hội thoại hay cách hệ thống cập nhật context.
Thử nghiệm có kiểm soát sẽ giúp xác định thay đổi nào thực sự cải thiện kết quả, thay vì chỉ tăng độ dài prompt một cách cảm tính.
6. Ví dụ thực tế: Thiết kế context cho AI Agent phân tích dữ liệu
Giả sử doanh nghiệp muốn xây dựng một AI Agent có thể trả lời câu hỏi: “Doanh thu tháng này giảm ở nhóm sản phẩm nào và nguyên nhân có thể là gì?”.
Nếu chỉ gửi câu hỏi này cho LLM mà không cung cấp dữ liệu phù hợp, mô hình không có đủ căn cứ để xác định kết quả thực tế của doanh nghiệp.
Một thiết kế context hợp lý có thể gồm:
| Thành phần | Nội dung ví dụ | Vai trò |
|---|---|---|
| Instructions | Phân tích dựa trên dữ liệu được cung cấp, không tự suy diễn số liệu | Định hướng hành vi |
| User request | Xác định nhóm sản phẩm giảm doanh thu trong tháng này | Xác định nhiệm vụ |
| Business context | Định nghĩa doanh thu, khoảng thời gian, quy tắc hoàn trả | Tránh hiểu sai chỉ số |
| Retrieved data | Doanh thu theo sản phẩm và theo tháng | Cung cấp bằng chứng |
| Tool results | Kết quả truy vấn SQL và phép tính mức thay đổi | Hỗ trợ phân tích |
| Output requirements | Bảng xếp hạng, mức thay đổi và giới hạn kết luận | Chuẩn hóa đầu ra |
Với cách thiết kế này, agent có thể so sánh số liệu, chỉ ra nhóm sản phẩm có mức giảm lớn và trình bày những dữ kiện hỗ trợ kết luận.
Tuy nhiên, cần phân biệt giữa phát hiện và giải thích nguyên nhân. Nếu context chỉ có doanh thu, agent có thể xác định nơi doanh thu giảm nhưng chưa đủ cơ sở để khẳng định nguyên nhân là do giá bán, quảng cáo hay nhu cầu khách hàng. Để kiểm tra những giả thuyết này, hệ thống cần thêm dữ liệu phù hợp và quy trình phân tích tương ứng.
Ví dụ trên cho thấy Context Engineering không chỉ là việc đưa thêm thông tin vào prompt. Đó còn là cách bảo đảm mô hình có đúng dữ liệu, đúng trạng thái và đúng tiêu chí để hoàn thành nhiệm vụ.
7. Những sai lầm thường gặp khi thiết kế context
7.1. Đưa quá nhiều thông tin không liên quan
Việc thêm toàn bộ tài liệu hoặc lịch sử hội thoại có thể làm context phình to mà không cải thiện chất lượng đầu ra. Hãy ưu tiên tính liên quan thay vì chỉ tối đa hóa lượng thông tin.
7.2. Dùng dữ liệu cũ mà không kiểm tra
Thông tin lỗi thời có thể khiến agent đưa ra quyết định sai. Với dữ liệu thường xuyên thay đổi, cần xem xét thời điểm cập nhật, nguồn dữ liệu và quy tắc ưu tiên khi các nguồn mâu thuẫn.
7.3. Không phân biệt dữ liệu với chỉ dẫn
Tài liệu được truy xuất có thể chứa nội dung không đáng tin cậy hoặc những câu lệnh không liên quan đến nhiệm vụ. Hệ thống cần phân biệt rõ dữ liệu tham khảo với instructions được ủy quyền, đồng thời áp dụng các biện pháp bảo vệ trước prompt injection.
7.4. Phụ thuộc hoàn toàn vào lịch sử hội thoại
Lịch sử dài không phải lúc nào cũng là dạng bộ nhớ tốt nhất. Các quyết định quan trọng, trạng thái công việc và dữ kiện cần tái sử dụng nên được lưu dưới cấu trúc phù hợp, có thể kiểm tra và cập nhật.
7.5. Chỉ đánh giá prompt mà bỏ qua toàn bộ hệ thống
Khi kết quả không tốt, nguyên nhân có thể nằm ở retrieval, chất lượng dữ liệu, việc chọn công cụ hoặc cách quản lý trạng thái. Vì vậy, cần đánh giá cả pipeline thay vì chỉ thay đổi câu chữ trong prompt.
8. Cách đo lường hiệu quả của Context Engineering
Để biết một thiết kế context có thực sự hiệu quả hay không, có thể theo dõi những nhóm chỉ số sau:
- Task success rate: Tỷ lệ nhiệm vụ được hoàn thành đúng yêu cầu.
- Answer correctness: Mức độ chính xác của câu trả lời so với dữ liệu hoặc đáp án tham chiếu.
- Retrieval relevance: Mức độ liên quan của thông tin được truy xuất với câu hỏi.
- Groundedness: Mức độ mà kết luận được hỗ trợ bởi dữ liệu và bằng chứng có sẵn.
- Token usage: Lượng token được sử dụng cho context và quá trình xử lý.
- Latency and cost: Thời gian phản hồi và chi phí vận hành.
- Tool-use reliability: Mức độ chính xác khi lựa chọn và sử dụng công cụ.
Không có một chỉ số đơn lẻ nào phản ánh đầy đủ chất lượng của context. Chẳng hạn, giảm token usage là hữu ích nếu độ chính xác vẫn được duy trì, nhưng không nên cắt bỏ dữ liệu quan trọng chỉ để giảm chi phí.
Một cách tiếp cận thực tế là xây dựng bộ tình huống kiểm thử đại diện, thay đổi từng thành phần của context và so sánh chất lượng, độ ổn định, chi phí trước và sau khi điều chỉnh.
9. Context Engineering có mối liên hệ gì với RAG và AI Agent?
Context Engineering có thể kết hợp với nhiều kỹ thuật và kiến trúc khác nhau.
- RAG (Retrieval-Augmented Generation): Hỗ trợ tìm kiếm thông tin từ nguồn bên ngoài để bổ sung dữ liệu liên quan vào context của LLM.
- Chunking: Chia tài liệu thành các đơn vị nhỏ hơn để phục vụ lưu trữ, truy xuất và xử lý.
- Reranking: Sắp xếp lại các kết quả truy xuất nhằm ưu tiên những tài liệu phù hợp hơn với truy vấn.
- Memory: Lưu giữ thông tin hữu ích qua nhiều lượt hoặc phiên làm việc và truy xuất khi cần.
- Tool Calling: Cho phép mô hình yêu cầu công cụ thực hiện hành động hoặc lấy thêm dữ liệu.
- Context Management: Kiểm soát lịch sử, kết quả công cụ, trạng thái tác vụ và giới hạn context trong quá trình thực thi.
Các kỹ thuật này không thay thế hoàn toàn cho nhau. RAG giúp lấy thông tin từ nguồn ngoài; Chunking và Reranking hỗ trợ quá trình truy xuất; Memory hỗ trợ lưu giữ thông tin; còn Context Engineering quyết định cách phối hợp những thành phần phù hợp để cung cấp context cho mô hình.
Đối với AI Agent, vấn đề càng quan trọng vì thông tin cần thiết có thể thay đổi qua từng bước. Agent cần biết lúc nào nên truy xuất thêm dữ liệu, khi nào nên sử dụng công cụ, thông tin nào cần giữ lại và phần nào có thể loại bỏ.
10. Kết luận
Context Engineering là một hướng tiếp cận quan trọng khi xây dựng ứng dụng LLM và AI Agent. Thay vì chỉ tập trung vào cách viết prompt, phương pháp này xem xét toàn bộ quá trình lựa chọn, tổ chức và cập nhật thông tin mà mô hình sử dụng để thực hiện nhiệm vụ.
Một hệ thống hiệu quả không nhất thiết phải có context dài nhất. Điều quan trọng là context chứa đúng thông tin, được tổ chức rõ ràng, cập nhật đúng thời điểm và có thể hỗ trợ mô hình đưa ra kết quả đáng tin cậy.
Khi bắt đầu xây dựng ứng dụng AI, hãy xác định mục tiêu trước, lựa chọn nguồn dữ liệu phù hợp, quản lý lịch sử và memory có chủ đích, sau đó đánh giá kết quả bằng những tình huống kiểm thử thực tế. Đây là nền tảng để phát triển các ứng dụng LLM và AI Agent ổn định, dễ kiểm soát và có khả năng mở rộng.
Tài liệu tham khảo
- Anthropic – Effective context engineering for AI agents
- Claude Platform Docs – Context windows
- Claude Platform Docs – Memory tool
- OpenAI Agents SDK – Context Management
Tìm hiểu thêm tại MCNA Technology School
Nếu bạn muốn xây dựng nền tảng về xử lý dữ liệu và phát triển ứng dụng AI, hãy tham khảo các chương trình học tại MCNA Technology School:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Minh Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu