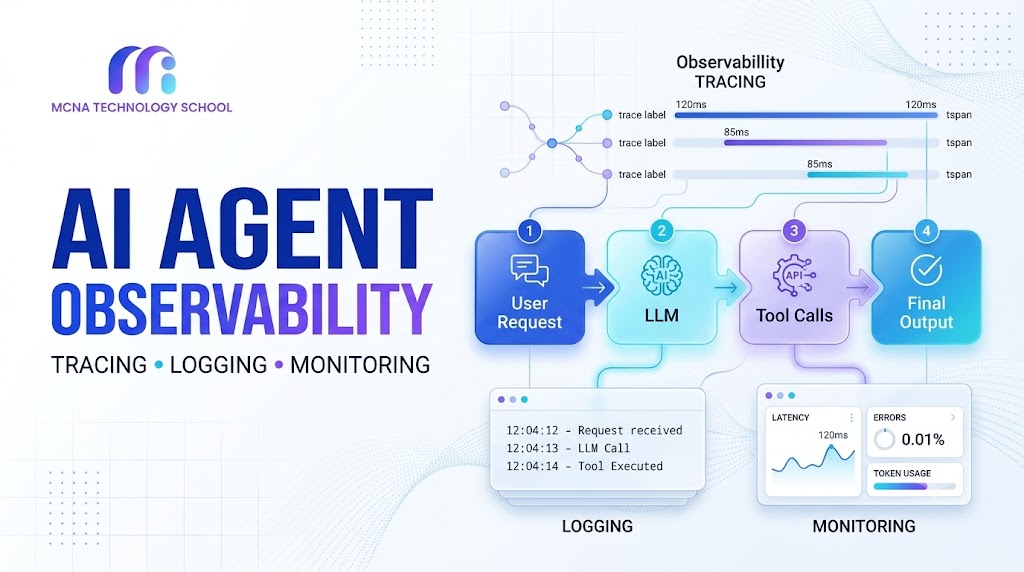
Nếu chỉ đánh giá câu trả lời cuối cùng, nhà phát triển sẽ khó xác định nguyên nhân thực sự. Đó là lý do AI Agent Observability trở thành một phần quan trọng trong quá trình xây dựng, kiểm thử và vận hành các ứng dụng AI.
Trong bài viết này, MCNA Technology School sẽ cùng bạn tìm hiểu Observability, phân biệt Tracing, Logging và Monitoring, sau đó thực hành ghi nhận các bước xử lý của một workflow bằng Python.
1. AI Agent Observability là gì?
AI Agent Observability là khả năng quan sát và phân tích hoạt động bên trong của một hệ thống AI Agent thông qua dữ liệu vận hành như log, trace, thời gian xử lý, trạng thái lỗi và mức sử dụng tài nguyên.
Khác với một chương trình thông thường chỉ thực hiện một chuỗi lệnh cố định, AI Agent có thể tạo ra nhiều bước xử lý khác nhau tùy theo yêu cầu, kết quả từ mô hình và phản hồi của công cụ. Một yêu cầu của người dùng có thể dẫn đến nhiều lần gọi LLM, nhiều tool calls hoặc chuyển giao nhiệm vụ giữa các Agent.
Vì vậy, việc theo dõi không nên chỉ dừng ở đầu vào và đầu ra. Nhà phát triển cần hiểu được những bước trung gian đã diễn ra, thời gian mỗi bước mất bao lâu và bước nào gây ra lỗi.
1.1. Ví dụ thực tế
Giả sử bạn xây dựng một AI Agent có nhiệm vụ đọc dữ liệu bán hàng, tính doanh thu theo tháng và tạo báo cáo. Khi người dùng yêu cầu phân tích dữ liệu, workflow có thể gồm:
- Tiếp nhận yêu cầu của người dùng.
- Gọi mô hình để xác định cách xử lý.
- Gọi công cụ đọc file dữ liệu.
- Thực hiện tính toán và tổng hợp kết quả.
- Gọi mô hình để diễn giải kết quả.
- Trả báo cáo cuối cùng cho người dùng.
Nếu báo cáo không chính xác, có thể có nhiều nguyên nhân: file đầu vào không hợp lệ, công cụ tính toán trả về dữ liệu sai, mô hình hiểu nhầm yêu cầu hoặc bước diễn giải kết quả gặp vấn đề.
Observability giúp nhà phát triển lần theo toàn bộ quy trình để xác định bước cần kiểm tra, thay vì chỉ sửa prompt dựa trên phỏng đoán.
2. Phân biệt Logging, Tracing và Monitoring
Ba khái niệm này có liên quan nhưng phục vụ những mục đích khác nhau. Trong một hệ thống AI Agent, chúng thường được kết hợp để tạo ra bức tranh đầy đủ về quá trình vận hành.
2.1. Logging – Ghi lại sự kiện
Logging là việc ghi nhận các sự kiện xảy ra trong ứng dụng. Một log có thể chứa thời điểm, cấp độ thông báo, tên bước xử lý, trạng thái thành công hoặc thất bại và thông tin lỗi đã được làm sạch.
Ví dụ:
2026-10-24 09:00:01 INFO workflow_started
2026-10-24 09:00:02 INFO data_loaded
2026-10-24 09:00:04 INFO analysis_completed
2026-10-24 09:00:05 INFO workflow_completed
Log giúp trả lời câu hỏi: “Sự kiện nào đã xảy ra?”. Tuy nhiên, nếu nhiều yêu cầu chạy đồng thời, log cần có mã phiên hoặc mã workflow để xác định sự kiện nào thuộc cùng một lần xử lý.
2.2. Tracing – Theo dõi toàn bộ luồng xử lý
Tracing ghi lại mối quan hệ giữa các bước trong một workflow. Một trace thường đại diện cho một thao tác hoặc quy trình tổng thể, trong khi mỗi span đại diện cho một bước cụ thể trong quy trình đó.
Ví dụ, một trace có thể chứa các span sau:
- Tiếp nhận yêu cầu.
- Gọi LLM.
- Gọi công cụ tìm dữ liệu.
- Thực thi phép tính.
- Tạo câu trả lời cuối cùng.
Mỗi span có thể ghi nhận thời gian bắt đầu, thời gian kết thúc, trạng thái và một số thuộc tính phù hợp. Các span có quan hệ cha – con giúp nhà phát triển xác định bước nào thuộc về bước nào.
Tracing đặc biệt hữu ích khi một Agent gọi nhiều công cụ hoặc chuyển giao nhiệm vụ giữa các Agent. Tham khảo: OpenAI Agents SDK – Tracing.
2.3. Monitoring – Theo dõi tình trạng vận hành
Monitoring tập trung theo dõi các chỉ số theo thời gian để nhận biết hệ thống đang hoạt động bình thường hay có dấu hiệu bất thường.
Một số chỉ số có thể theo dõi gồm:
- Latency: thời gian xử lý trung bình và các phân vị như p95.
- Error rate: tỷ lệ yêu cầu thất bại.
- Request volume: số lượng yêu cầu theo thời gian.
- Token usage: lượng token đầu vào và đầu ra nếu nhà cung cấp cung cấp dữ liệu này.
- Cost per task: chi phí ước tính cho một nhiệm vụ.
- Tool failure rate: tỷ lệ lời gọi công cụ không thành công.
Monitoring giúp trả lời câu hỏi: “Hệ thống đang vận hành như thế nào và có vấn đề gì cần xử lý?”. Các ngưỡng cảnh báo cần được lựa chọn theo đặc điểm ứng dụng, không nên áp dụng một con số chung cho mọi hệ thống.
2.4. Bảng so sánh nhanh
| Tiêu chí | Logging | Tracing | Monitoring |
|---|---|---|---|
| Mục tiêu | Ghi lại sự kiện | Hiểu luồng xử lý | Theo dõi tình trạng hệ thống |
| Câu hỏi chính | Điều gì đã xảy ra? | Bước nào dẫn đến kết quả hoặc lỗi? | Hệ thống có đang bất thường? |
| Dữ liệu thường gặp | Thông báo, lỗi, trạng thái | Trace ID, span, thời lượng, quan hệ giữa các bước | Latency, error rate, request volume |
| Thời điểm sử dụng | Kiểm tra sự kiện cụ thể | Điều tra một workflow | Giám sát liên tục |
3. Vì sao AI Agent cần Observability?
3.1. Phát hiện lỗi trong workflow nhiều bước
Một Agent có thể thất bại dù từng thành phần riêng lẻ vẫn hoạt động. Ví dụ, mô hình hiểu đúng yêu cầu nhưng lại truyền tham số sai cho công cụ. Nếu không theo dõi các bước trung gian, lỗi này rất dễ bị nhầm với vấn đề của mô hình.
3.2. Tối ưu độ trễ
Một workflow chậm có thể do nhiều nguyên nhân: API phản hồi lâu, công cụ bên ngoài bị nghẽn, truy vấn dữ liệu không tối ưu hoặc Agent thực hiện quá nhiều lượt gọi LLM. Tracing giúp xác định bước chiếm nhiều thời gian nhất để ưu tiên tối ưu đúng chỗ.
3.3. Kiểm soát chi phí
Một yêu cầu tưởng chừng đơn giản có thể tạo ra nhiều lần gọi mô hình, gọi công cụ và thử lại. Khi có dữ liệu usage phù hợp, nhà phát triển có thể phân tích chi phí theo workflow, loại tác vụ hoặc phiên làm việc.
Không phải hệ thống nào cũng cung cấp đầy đủ dữ liệu chi phí ngay trong trace. Trong trường hợp đó, cần kết hợp dữ liệu usage từ nhà cung cấp với số liệu vận hành của ứng dụng để ước tính chi phí.
3.4. Hỗ trợ đánh giá chất lượng và an toàn
Observability cung cấp dữ liệu để kiểm tra Agent có chọn đúng công cụ, có thực hiện handoff đúng lúc và có tuân thủ các bước kiểm soát hay không. Tuy nhiên, trace chỉ cho biết quá trình đã diễn ra như thế nào; để kết luận câu trả lời có chính xác hay không, hệ thống vẫn cần tiêu chí đánh giá riêng.
Tham khảo: OpenAI – Evaluate agent workflows.
4. Thực hành Logging và đo thời gian xử lý bằng Python
Trước khi sử dụng các nền tảng tracing chuyên dụng, bạn có thể bắt đầu bằng thư viện logging và time có sẵn trong Python.
Ví dụ dưới đây mô phỏng một workflow gồm ba bước: đọc dữ liệu, phân tích và tạo báo cáo. Đây là chương trình minh họa cách ghi log và đo thời gian; chưa thực hiện gọi LLM hoặc kết nối công cụ bên ngoài.
import logging
import time

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s %(levelname)s %(message)s"
)

def run_step(step_name, function):
    start_time = time.perf_counter()
    logging.info("%s started", step_name)

    try:
        result = function()
        elapsed = time.perf_counter() - start_time
        logging.info(
            "%s completed in %.3f seconds",
            step_name,
            elapsed
        )
        return result
    except Exception:
        elapsed = time.perf_counter() - start_time
        logging.exception(
            "%s failed after %.3f seconds",
            step_name,
            elapsed
        )
        raise

def load_data():
    return [100, 150, 200, 250]

def analyze_data(data):
    return sum(data)

def create_report(total):
    return "Total revenue: " + str(total)

def main():
    data = run_step("load_data", load_data)
    total = run_step(
        "analyze_data",
        lambda: analyze_data(data)
    )
    report = run_step(
        "create_report",
        lambda: create_report(total)
    )
    print(report)

if __name__ == "__main__":
    main()
4.1. Giải thích chương trình
logging.basicConfig()thiết lập định dạng log gồm thời điểm, cấp độ và nội dung sự kiện.time.perf_counter()đo khoảng thời gian xử lý với độ phân giải phù hợp cho việc benchmark.run_step()ghi nhận thời điểm bắt đầu, trạng thái hoàn thành và thời lượng của mỗi bước.logging.exception()ghi lại thông tin ngoại lệ khi một bước thất bại. Trong môi trường thực tế, cần bảo đảm log không chứa dữ liệu nhạy cảm.raisechuyển tiếp ngoại lệ để chương trình gọi có thể xử lý lỗi, thay vì âm thầm coi bước thất bại là thành công.
4.2. Chương trình giúp giải quyết vấn đề gì?
Nếu bước phân tích dữ liệu bị lỗi, log có thể chỉ ra tên bước thất bại và thời gian xử lý trước khi xảy ra lỗi. Nếu chương trình chạy thành công nhưng chậm, thời lượng của từng bước cung cấp cơ sở ban đầu để điều tra.
Tuy vậy, cách làm này chưa tạo trace phân tán, chưa liên kết các yêu cầu đồng thời bằng trace ID và cũng chưa tự động thu thập token usage. Đây là nền tảng ban đầu trước khi chuyển sang hệ thống Observability chuyên dụng.
5. Từ Logging đến Tracing cho AI Agent
Khi workflow phát triển, chỉ ghi log từng bước sẽ không còn đủ. Bạn cần theo dõi mối quan hệ giữa các lời gọi LLM, công cụ và các thành phần phụ trợ trong cùng một lần xử lý.
5.1. Những thông tin nên ghi nhận
- Workflow ID hoặc trace ID để liên kết các sự kiện cùng một yêu cầu.
- Tên bước hoặc tên công cụ được gọi.
- Thời gian bắt đầu, thời lượng và trạng thái hoàn thành.
- Loại lỗi và mã lỗi khi một bước thất bại.
- Token usage hoặc chi phí ước tính khi có dữ liệu đáng tin cậy.
- Phiên bản prompt, model hoặc cấu hình có liên quan khi cần điều tra thay đổi hành vi.
5.2. Sử dụng tracing trong OpenAI Agents SDK
Nếu ứng dụng sử dụng OpenAI Agents SDK cho Python, SDK cung cấp cơ chế tracing để ghi nhận các hoạt động như model calls, tool calls, handoffs và guardrails. Nhà phát triển có thể kiểm tra các trace trong dashboard để hiểu workflow đã chạy ra sao.
Ví dụ tối giản:
import asyncio
from agents import Agent, Runner, trace

async def main():
    agent = Agent(
        name="Simple Assistant",
        instructions="Answer the user clearly and concisely."
    )

    with trace("Simple assistant workflow"):
        result = await Runner.run(
            agent,
            "Explain why logging is useful in AI applications."
        )
        print(result.final_output)

if __name__ == "__main__":
    asyncio.run(main())
Để chạy ví dụ, bạn cần cài đặt gói OpenAI Agents SDK phù hợp và thiết lập thông tin xác thực theo tài liệu chính thức. Ví dụ này sử dụng một workflow tối giản; dữ liệu trace thực tế phụ thuộc vào những hoạt động diễn ra trong lần chạy.
Tài liệu: OpenAI Agents SDK – Tracing.
5.3. Có thể sử dụng công cụ khác không?
Có. Tùy kiến trúc, bạn có thể lựa chọn nền tảng theo dõi của framework đang sử dụng hoặc xây dựng hệ thống dựa trên các chuẩn observability phù hợp. Chẳng hạn, LangSmith cung cấp khả năng tracing và quan sát ứng dụng LLM qua nhiều framework.
Tham khảo: LangSmith – Observability.
Khi lựa chọn công cụ, hãy cân nhắc framework, khả năng tích hợp, quyền kiểm soát dữ liệu, chi phí, giới hạn lưu trữ và yêu cầu bảo mật của ứng dụng.
6. Những chỉ số quan trọng khi Monitoring AI Agent
Không nên theo dõi quá nhiều chỉ số mà không gắn chúng với mục tiêu vận hành. Một dashboard hữu ích nên giúp đội ngũ phát hiện vấn đề, hiểu mức độ ảnh hưởng và quyết định hành động tiếp theo.
| Chỉ số | Ý nghĩa | Câu hỏi cần trả lời |
|---|---|---|
| Latency | Thời gian hoàn thành yêu cầu | Người dùng có phải chờ quá lâu? |
| Error rate | Tỷ lệ yêu cầu thất bại | Lỗi có tăng sau một lần cập nhật? |
| Tool failure rate | Tỷ lệ gọi công cụ thất bại | Công cụ nào thường xuyên gặp lỗi? |
| Token usage | Lượng token được sử dụng | Workflow có tiêu thụ nhiều token hơn dự kiến? |
| Task success rate | Tỷ lệ hoàn thành nhiệm vụ theo tiêu chí định nghĩa | Agent có thực sự giải quyết được yêu cầu? |
Trong đó, task success rate cần được xác định bằng tiêu chí đánh giá phù hợp với từng ứng dụng. Một workflow không phát sinh lỗi kỹ thuật chưa chắc đã hoàn thành đúng nhiệm vụ của người dùng.
7. Những sai lầm thường gặp khi triển khai Observability
7.1. Chỉ lưu câu trả lời cuối cùng
Đầu ra cuối cùng không cho thấy đầy đủ các bước trung gian. Hãy ghi nhận metadata cần thiết để điều tra workflow, đồng thời giới hạn dữ liệu đầu vào và đầu ra được lưu.
7.2. Ghi log toàn bộ dữ liệu nhạy cảm
Prompt, kết quả công cụ và lịch sử hội thoại có thể chứa thông tin cá nhân hoặc dữ liệu nội bộ. Không nên mặc định rằng mọi nội dung đều cần được lưu nguyên văn. Hãy áp dụng chính sách tối thiểu hóa dữ liệu, che thông tin nhạy cảm và kiểm soát quyền truy cập.
7.3. Không liên kết các bước của cùng một yêu cầu
Nếu thiếu workflow ID hoặc trace ID, việc tìm các log liên quan sẽ khó khăn, nhất là khi nhiều yêu cầu được xử lý đồng thời. Mỗi yêu cầu nên có định danh phù hợp để liên kết các sự kiện trong phạm vi được phép.
7.4. Chỉ quan tâm đến lỗi kỹ thuật
Agent có thể chạy thành công nhưng chọn sai công cụ, tạo báo cáo thiếu dữ kiện hoặc không đáp ứng mục tiêu. Do đó, cần kết hợp dữ liệu vận hành với bộ tiêu chí đánh giá chất lượng đầu ra.
7.5. Không kiểm tra chi phí và độ trễ theo workflow
Một yêu cầu có thể phát sinh nhiều lượt gọi mô hình hoặc thử lại. Nếu chỉ đo thời gian của từng lời gọi riêng lẻ, bạn có thể bỏ qua thời gian tổng thể mà người dùng thực sự phải chờ. Hãy theo dõi cả từng bước và toàn bộ workflow.
8. Lộ trình triển khai AI Agent Observability
- Bước 1 – Logging cơ bản: Ghi lại sự kiện, trạng thái thành công hoặc thất bại và thời lượng từng bước.
- Bước 2 – Liên kết workflow: Thêm mã định danh để nhóm các sự kiện thuộc cùng một yêu cầu.
- Bước 3 – Tracing: Theo dõi các lời gọi mô hình, tool calls và những bước chuyển giao trong workflow.
- Bước 4 – Monitoring: Xây dựng dashboard cho latency, error rate, usage và các chỉ số vận hành phù hợp.
- Bước 5 – Đánh giá và cải tiến: Kết hợp trace với bộ dữ liệu kiểm thử để xác định lỗi lặp lại và đánh giá tác động của các thay đổi.
- Bước 6 – Bảo mật dữ liệu: Thiết lập chính sách lưu trữ, quyền truy cập, thời hạn lưu và che thông tin nhạy cảm.
Không nhất thiết phải triển khai tất cả ngay từ đầu. Với một dự án cá nhân, logging và đo thời gian xử lý đã là điểm khởi đầu hữu ích. Khi số lượng người dùng, độ phức tạp của workflow và yêu cầu vận hành tăng lên, bạn có thể bổ sung tracing và monitoring chuyên sâu.
9. Kết luận
AI Agent Observability giúp nhà phát triển hiểu rõ hệ thống đã làm gì, vì sao một bước xử lý thất bại và đâu là cơ hội để cải thiện hiệu suất. Logging ghi nhận sự kiện, tracing làm rõ luồng xử lý, còn monitoring giúp theo dõi tình trạng vận hành theo thời gian.
Để xây dựng một AI Agent đáng tin cậy, bạn nên bắt đầu từ việc ghi log có cấu trúc, đo thời gian từng bước và liên kết các sự kiện trong cùng một workflow. Sau đó, kết hợp tracing, monitoring và đánh giá chất lượng để có cái nhìn toàn diện hơn.
Nếu bạn muốn phát triển nền tảng Python, tư duy dữ liệu và khả năng ứng dụng AI vào các bài toán thực tế, hãy tham khảo các chương trình đào tạo tại MCNA Technology School.