AI Agent Memory Management: Memory Consolidation, Deduplication và Forgetting Strategy
Trong các hệ thống AI Agent hiện đại, khả năng ghi nhớ thông tin qua nhiều phiên làm việc là yếu tố quan trọng giúp Agent hiểu người dùng, duy trì ngữ cảnh và cải thiện chất lượng phản hồi. Tuy nhiên, việc lưu trữ càng nhiều dữ liệu không đồng nghĩa với việc Agent trở nên thông minh hơn.
Sau một thời gian hoạt động, hệ thống memory có thể xuất hiện nhiều vấn đề: cùng một thông tin được lưu nhiều lần, dữ liệu cũ mâu thuẫn với dữ liệu mới, những sở thích tạm thời bị hiểu nhầm thành sở thích lâu dài, hoặc bộ nhớ chứa quá nhiều thông tin không còn giá trị.
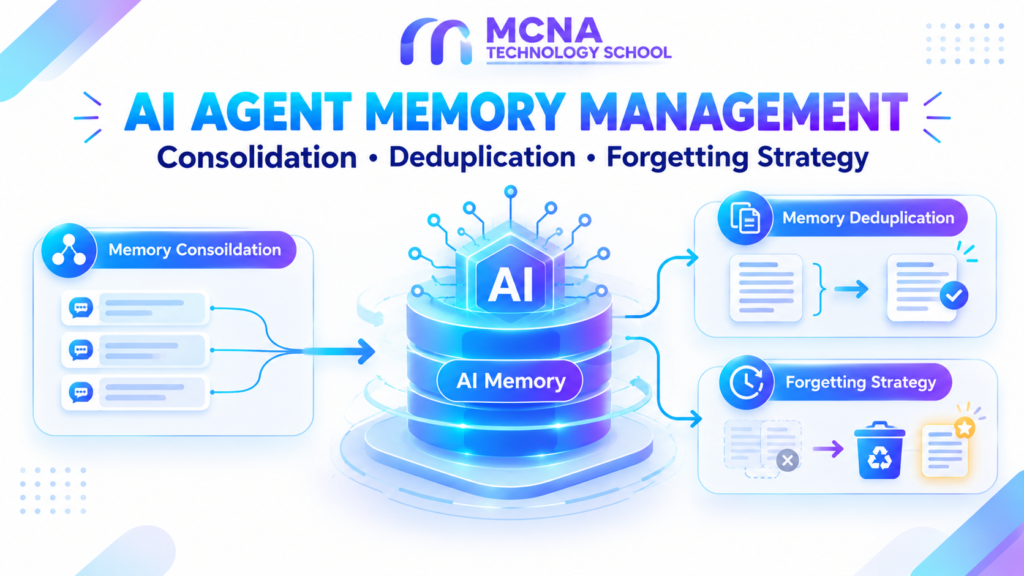
Đây là lý do AI Agent cần một lớp quản trị bộ nhớ – Memory Management. Thay vì chỉ tập trung vào việc lưu và truy xuất, hệ thống cần biết khi nào nên hợp nhất, cập nhật, giữ lại hoặc quên một thông tin.
Trong bài viết này, chúng ta sẽ tìm hiểu ba kỹ thuật quan trọng: Memory Consolidation, Memory Deduplication và Forgetting Strategy, đồng thời xây dựng một quy trình quản lý bộ nhớ bằng Python và PostgreSQL.
1. Vì sao AI Agent cần Memory Management?
Hãy tưởng tượng một AI Assistant được sử dụng trong nhiều tháng. Trong những cuộc trò chuyện khác nhau, người dùng có thể cung cấp các thông tin như:
- Tôi thường sử dụng Python cho các dự án phân tích dữ liệu.
- Tôi đang học Python để làm Data Analyst.
- Tôi muốn sử dụng Python và SQL trong công việc.
- Hiện tại tôi chuyển sang sử dụng R cho một dự án nghiên cứu.
Nếu Agent lưu tất cả các câu trên thành những memory độc lập, hệ thống sẽ dần tích lũy các bản ghi có nội dung gần giống nhau. Khi truy xuất, Agent có thể lấy quá nhiều thông tin không cần thiết hoặc không xác định được đâu là thông tin mới nhất.
Có thể chia các vấn đề thường gặp thành bốn nhóm:
| Vấn đề | Biểu hiện | Hậu quả |
|---|---|---|
| Duplicate Memory | Một thông tin được lưu nhiều lần | Tốn dung lượng, truy xuất dư thừa |
| Conflicting Memory | Các memory chứa thông tin trái ngược | Agent sử dụng thông tin sai |
| Stale Memory | Thông tin cũ không được cập nhật | Phản hồi không còn phù hợp |
| Memory Overload | Quá nhiều thông tin ít giá trị | Giảm chất lượng retrieval, tăng chi phí |
Vì vậy, một hệ thống memory tốt cần thực hiện nhiều thao tác hơn việc INSERT dữ liệu vào database.
2. Ba thành phần cốt lõi của Memory Management
2.1. Memory Consolidation – Hợp nhất bộ nhớ
Memory Consolidation là quá trình tổng hợp nhiều thông tin liên quan thành một memory có ý nghĩa và đầy đủ hơn.
Ví dụ, qua nhiều cuộc trò chuyện, Agent ghi nhận:
- Người dùng đang học Data Analytics.
- Người dùng thường sử dụng Python và SQL.
- Người dùng đang thực hiện các dự án phân tích dữ liệu.
- Người dùng muốn phát triển theo hướng Data Analyst.
Thay vì lưu bốn bản ghi rời rạc, hệ thống có thể hợp nhất thành:
Người dùng đang phát triển theo hướng Data Analyst, thường sử dụng Python và SQL, đồng thời thực hiện các dự án phân tích dữ liệu để nâng cao kỹ năng thực hành.
Memory mới giữ lại những thông tin có giá trị chung, giúp Agent hiểu được bức tranh tổng thể thay vì phải truy xuất nhiều mẩu dữ liệu nhỏ.
Cần lưu ý rằng consolidation không đơn giản là nối nhiều câu thành một đoạn văn. Hệ thống phải xác định thông tin nào bổ sung cho nhau, thông tin nào chỉ mang tính tạm thời và thông tin nào cần được giữ nguyên dưới dạng dữ liệu riêng biệt.
2.2. Memory Deduplication – Khử trùng lặp
Deduplication là quá trình phát hiện và xử lý các memory trùng lặp hoặc gần giống nhau.
Ví dụ:
| Memory ID | Nội dung |
|---|---|
| 101 | Người dùng sử dụng Python để phân tích dữ liệu. |
| 102 | Python là công cụ phân tích dữ liệu thường dùng. |
| 103 | Người dùng thường làm Data Analysis bằng Python. |
Ba câu trên có cách diễn đạt khác nhau nhưng gần như cùng biểu đạt một thông tin. Nếu lưu tất cả mà không kiểm soát, hệ thống có thể lãng phí tài nguyên và làm kết quả tìm kiếm bị nhiễu.
Có thể triển khai deduplication bằng ba phương pháp:
- Exact Matching: So sánh chuỗi sau khi chuẩn hóa. Phù hợp với dữ liệu trùng khớp hoàn toàn.
- Semantic Similarity: Sử dụng embedding và cosine similarity để phát hiện những câu khác cách diễn đạt nhưng cùng ý nghĩa.
- LLM-based Comparison: Sử dụng LLM để đánh giá hai memory có thực sự tương đương, bổ sung hay mâu thuẫn với nhau hay không.
Trong thực tế, có thể kết hợp cả ba phương pháp. Exact matching giúp xử lý nhanh các trường hợp đơn giản, vector search hỗ trợ tìm ứng viên tương tự, còn LLM đảm nhận bước đánh giá ngữ nghĩa phức tạp.
2.3. Forgetting Strategy – Chiến lược quên
Một AI Agent không nên giữ mọi thông tin mãi mãi. Một số dữ liệu chỉ có giá trị trong một khoảng thời gian nhất định.
Ví dụ:
- Người dùng đang chuẩn bị cho một kỳ thi vào tuần tới.
- Người dùng đang làm một dự án kéo dài trong hai tháng.
- Người dùng hiện thích nhận câu trả lời ngắn gọn.
- Người dùng từng sử dụng một công cụ nhưng hiện đã chuyển sang công cụ khác.
Những thông tin này có vòng đời khác nhau. Một kỳ thi đã kết thúc không nên tiếp tục được coi là mục tiêu hiện tại. Trong khi đó, sở thích về cách trình bày có thể duy trì lâu dài hơn.
Forgetting Strategy là tập hợp các quy tắc quyết định memory nào cần được giữ, giảm mức độ ưu tiên hoặc xóa khỏi hệ thống.
Có ba cách tiếp cận phổ biến:
| Chiến lược | Cách hoạt động | Ứng dụng |
|---|---|---|
| TTL-based Expiration | Tự động hết hạn sau một khoảng thời gian | Session, thông tin tạm thời |
| Importance-based Retention | Giữ memory có mức độ quan trọng cao | Sở thích, mục tiêu dài hạn |
| Access-based Decay | Giảm độ ưu tiên khi memory ít được sử dụng | Memory retrieval quy mô lớn |
Đặc biệt, cần phân biệt giữa giảm khả năng được truy xuất và xóa dữ liệu. Một memory ít được sử dụng có thể bị giảm điểm retrieval nhưng vẫn còn trong database. Ngược lại, khi người dùng yêu cầu xóa dữ liệu, hệ thống cần thực hiện thao tác xóa thực sự theo chính sách lưu trữ và quyền riêng tư.
3. Thiết kế cấu trúc dữ liệu cho Memory Management
Trong bài viết trước, chúng ta đã tìm hiểu cách lưu trữ long-term memory bằng PostgreSQL và pgvector. Tiếp tục sử dụng PostgreSQL, ta có thể bổ sung một số trường để hỗ trợ quản trị bộ nhớ.
CREATE TABLE agent_memories (
    id BIGSERIAL PRIMARY KEY,
    user_id VARCHAR(100) NOT NULL,
    memory_text TEXT NOT NULL,
    category VARCHAR(50),
    importance FLOAT DEFAULT 0.5,
    confidence FLOAT DEFAULT 1.0,
    access_count INTEGER DEFAULT 0,
    last_accessed_at TIMESTAMP,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    expires_at TIMESTAMP,
    is_active BOOLEAN DEFAULT TRUE
);
Ý nghĩa của các trường quan trọng:
importance: Mức độ quan trọng của memory.confidence: Mức độ tin cậy của thông tin.access_count: Số lần memory được truy xuất.last_accessed_at: Thời điểm truy cập gần nhất.expires_at: Thời điểm memory hết hạn nếu có.is_active: Trạng thái sử dụng của memory.
Đây là cấu trúc minh họa. Khi triển khai production, nên bổ sung nguồn thông tin, phạm vi áp dụng, lịch sử thay đổi, trạng thái xóa và cơ chế phân quyền theo từng user hoặc organization.
4. Xây dựng Memory Deduplication bằng Python
Trước tiên, hãy triển khai một phiên bản đơn giản sử dụng cosine similarity. Ví dụ dưới đây giả định hệ thống đã có embedding cho từng memory.
Bước 1: Tính cosine similarity
import numpy as np

def cosine_similarity(vector_a, vector_b):
    vector_a = np.array(vector_a)
    vector_b = np.array(vector_b)

    norm_a = np.linalg.norm(vector_a)
    norm_b = np.linalg.norm(vector_b)

    if norm_a == 0 or norm_b == 0:
        return 0

    return np.dot(vector_a, vector_b) / (norm_a * norm_b)


memory_a = [0.2, 0.5, 0.8, 0.1]
memory_b = [0.3, 0.4, 0.7, 0.2]

similarity = cosine_similarity(memory_a, memory_b)

print("Similarity:", similarity)
Cosine similarity đo mức độ tương đồng về hướng giữa hai vector. Giá trị càng gần 1 thì hai vector càng tương đồng về mặt biểu diễn.
Tuy nhiên, không nên mặc định rằng hai memory có similarity cao chắc chắn là bản sao. Hai câu có thể cùng chủ đề nhưng chứa thông tin khác nhau. Ngưỡng similarity cần được kiểm thử trên dữ liệu thực tế.
Bước 2: Phát hiện memory trùng lặp
def find_duplicate_memories(
    new_embedding,
    memories,
    threshold=0.90
):
    duplicates = []

    for memory in memories:
        score = cosine_similarity(
            new_embedding,
            memory["embedding"]
        )

        if score >= threshold:
            duplicates.append({
                "id": memory["id"],
                "text": memory["text"],
                "similarity": score
            })

    return sorted(
        duplicates,
        key=lambda x: x["similarity"],
        reverse=True
    )


memories = [
    {
        "id": 1,
        "text": "Người dùng sử dụng Python để phân tích dữ liệu.",
        "embedding": [0.2, 0.5, 0.8, 0.1]
    },
    {
        "id": 2,
        "text": "Người dùng thích đọc sách kinh tế.",
        "embedding": [0.9, 0.1, 0.2, 0.7]
    }
]

new_embedding = [0.21, 0.49, 0.79, 0.12]

duplicates = find_duplicate_memories(
    new_embedding,
    memories
)

for item in duplicates:
    print(item)
Trong hệ thống thực tế, danh sách memory ứng viên nên được lấy từ vector database theo đúng phạm vi user hoặc organization. Không nên so sánh memory của những người dùng khác nhau nếu không có cơ chế chia sẻ dữ liệu được cho phép.
5. Memory Update: Xử lý thông tin mới và thông tin mâu thuẫn
Phát hiện hai memory tương tự mới chỉ là bước đầu. Hệ thống còn phải quyết định nên làm gì với thông tin mới.
Có thể thiết kế một bộ quyết định gồm bốn hành động:
| Action | Ý nghĩa | Khi nào sử dụng? |
|---|---|---|
| ADD | Tạo memory mới | Thông tin chưa tồn tại |
| UPDATE | Cập nhật memory cũ | Thông tin mới bổ sung hoặc thay thế |
| DELETE | Xóa memory cũ | Thông tin cần được xóa theo yêu cầu hoặc chính sách |
| NOOP | Không thay đổi | Thông tin đã có và không tạo thêm giá trị |
Ví dụ, nếu memory hiện tại là:
Người dùng đang sử dụng Python cho các dự án phân tích dữ liệu.
Và thông tin mới là:
Người dùng hiện chuyển sang sử dụng R cho dự án nghiên cứu mới.
Hai thông tin không nhất thiết mâu thuẫn. Người dùng có thể sử dụng cả Python và R trong những bối cảnh khác nhau. Vì vậy, hệ thống không nên xóa memory cũ chỉ vì memory mới đề cập đến một công cụ khác.
Ngược lại, nếu người dùng nói rõ: “Tôi không còn sử dụng Python trong dự án này nữa, hãy cập nhật công cụ chính thành R”, hệ thống có thể cập nhật thông tin về công cụ chính trong phạm vi dự án đó.
Một quy trình xử lý memory mới có thể được mô tả như sau:
- Trích xuất thông tin có giá trị từ hội thoại.
- Tìm các memory liên quan trong cùng phạm vi dữ liệu.
- So sánh nội dung và xác định quan hệ: trùng lặp, bổ sung hay mâu thuẫn.
- Chọn ADD, UPDATE, DELETE hoặc NOOP.
- Lưu kết quả và ghi lại lịch sử thay đổi.
Với các thông tin quan trọng hoặc có khả năng gây hậu quả nếu cập nhật sai, nên yêu cầu xác nhận từ người dùng hoặc chuyển sang bước kiểm duyệt.
6. Thiết kế Forgetting Strategy bằng Importance và Recency
Để quyết định memory nào nên được ưu tiên giữ lại, ta có thể xây dựng một điểm số quản trị bộ nhớ dựa trên các yếu tố:
- Importance: Mức độ quan trọng của thông tin.
- Recency: Mức độ mới của thông tin.
- Frequency: Tần suất memory được sử dụng.
- Confidence: Độ tin cậy của thông tin.
Một công thức minh họa:
Memory Score = 0.4 × Importance + 0.2 × Recency + 0.2 × Frequency + 0.2 × Confidence
Các thành phần được chuẩn hóa về khoảng từ 0 đến 1. Trọng số trên chỉ là ví dụ thiết kế, không phải công thức tiêu chuẩn cho mọi hệ thống.
Ví dụ triển khai bằng Python
from datetime import datetime, timezone

def calculate_memory_score(memory):
    now = datetime.now(timezone.utc)

    last_accessed = memory["last_accessed_at"]

    if last_accessed is None:
        days_since_access = 365
    else:
        days_since_access = (
            now - last_accessed
        ).days

    recency = 1 / (1 + days_since_access)

    frequency = min(
        memory["access_count"] / 20,
        1
    )

    score = (
        0.4 * memory["importance"]
        + 0.2 * recency
        + 0.2 * frequency
        + 0.2 * memory["confidence"]
    )

    return score
Điểm số này có thể được sử dụng để hỗ trợ quyết định xếp hạng memory, đưa dữ liệu vào hàng chờ rà soát hoặc xác định memory ít được ưu tiên.
Không nên tự động xóa mọi memory có điểm thấp. Một thông tin ít được truy cập vẫn có thể rất quan trọng, chẳng hạn một ràng buộc pháp lý, thông tin bảo mật hoặc yêu cầu đặc biệt của người dùng.
TTL – Tự động hết hạn bộ nhớ
Với dữ liệu tạm thời, TTL (Time To Live) là một phương pháp đơn giản và hiệu quả.
UPDATE agent_memories
SET is_active = FALSE
WHERE expires_at IS NOT NULL
  AND expires_at < CURRENT_TIMESTAMP
  AND is_active = TRUE;
Ví dụ, thông tin về một phiên làm việc có thể hết hạn sau vài giờ, trong khi thông tin về sở thích dài hạn không nên bị xóa chỉ vì người dùng không truy cập trong một thời gian.
7. Memory Consolidation Pipeline trong kiến trúc AI Agent
Đối với hệ thống production, không nhất thiết phải thực hiện toàn bộ quá trình consolidation ngay trong mỗi lượt hội thoại. Có thể tách việc trả lời người dùng và quản trị bộ nhớ thành hai luồng riêng biệt.
                 USER CONVERSATION
                         |
                         v
                  MAIN AI AGENT
                         |
             +-----------+-----------+
             |                       |
             v                       v
       Generate Answer        Extract Candidates
                                     |
                                     v
                              MEMORY QUEUE
                                     |
                                     v
                           CONSOLIDATION AGENT
                                     |
                   +-----------------+-----------------+
                   |                 |                 |
                   v                 v                 v
                Dedup             Update            Forget
                   |                 |                 |
                   +-----------------+-----------------+
                                     |
                                     v
                              MEMORY DATABASE
                                     |
                                     v
                               VECTOR INDEX
                                     |
                                     v
                              FUTURE RETRIEVAL
Luồng này có một số ưu điểm:
- Main Agent tập trung xử lý yêu cầu hiện tại.
- Consolidation Agent có thể phân tích nhiều cuộc hội thoại cùng lúc.
- Việc cập nhật memory không làm tăng đáng kể độ trễ của phản hồi chính.
- Có thể lên lịch chạy định kỳ hoặc kích hoạt khi số lượng memory mới đạt ngưỡng.
Ví dụ, hệ thống có thể chạy consolidation mỗi đêm, hoặc sau mỗi 50 memory mới. Tần suất thực tế cần dựa trên lưu lượng sử dụng, chi phí LLM và yêu cầu cập nhật thông tin.
8. Những nguyên tắc quan trọng khi triển khai thực tế
8.1. Không để LLM tự ý xóa mọi memory
LLM có thể đánh giá sai mối quan hệ giữa hai thông tin. Vì vậy, những thao tác xóa dữ liệu nên có điều kiện rõ ràng, kiểm tra quyền và lưu audit log. Với yêu cầu xóa dữ liệu của người dùng, cần có quy trình xóa thực sự chứ không chỉ đánh dấu memory là ít quan trọng.
8.2. Phân biệt thông tin cũ và thông tin sai
Thông tin cũ chưa chắc đã sai. Một người từng học Python và hiện học R vẫn có thể sử dụng cả hai. Do đó, cần lưu thời điểm, nguồn và phạm vi của memory để Agent hiểu được ngữ cảnh.
8.3. Giữ lại nguồn gốc của memory
Nên lưu thông tin về nguồn tạo ra memory, thời điểm ghi nhận và các bản ghi đã được hợp nhất. Điều này giúp hệ thống giải thích vì sao một thông tin xuất hiện, đồng thời hỗ trợ khôi phục khi quá trình consolidation xảy ra sai sót.
8.4. Tách memory theo phạm vi
Memory cá nhân, memory của một dự án và memory dùng chung trong tổ chức không nên được trộn lẫn. Phạm vi truy xuất và cập nhật phải được kiểm soát rõ ràng.
8.5. Đánh giá chất lượng sau khi consolidation
Không chỉ đo số lượng memory được giảm đi. Cần đánh giá xem Agent có truy xuất đúng thông tin hơn hay không, có giảm mâu thuẫn không và có duy trì được các thông tin quan trọng không.
9. Kết luận
Memory Management là một phần quan trọng trong kiến trúc AI Agent có khả năng hoạt động lâu dài. Một hệ thống tốt không chỉ cần lưu trữ và tìm kiếm thông tin, mà còn phải biết cách duy trì chất lượng của bộ nhớ theo thời gian.
Ba kỹ thuật cần ghi nhớ:
- Memory Consolidation: Hợp nhất các thông tin liên quan thành memory có ý nghĩa hơn.
- Memory Deduplication: Phát hiện và xử lý những bản ghi trùng lặp hoặc gần trùng lặp.
- Forgetting Strategy: Quản lý vòng đời dữ liệu, giảm ưu tiên hoặc xóa những memory không còn cần thiết.
Khi kết hợp với PostgreSQL, Vector Search và một quy trình xử lý nền, những kỹ thuật này giúp AI Agent duy trì bộ nhớ có cấu trúc, giảm nhiễu và cải thiện chất lượng truy xuất trong dài hạn.
10. Tài liệu tham khảo
- LangGraph Documentation – Add Memory
- LangGraph / Deep Agents – Memory Management and Consolidation
- Mem0 – Memory Eviction and Forgetting in AI Agents
- Rethinking Memory in AI: Taxonomy, Operations, Topics, and Future Directions
11. Học thêm về AI và Data tại MCNA Technology School
Nếu bạn muốn xây dựng nền tảng vững chắc về Python, Data Analytics, Power BI và các ứng dụng AI trong công việc, hãy tham khảo các chương trình đào tạo tại MCNA Technology School: