AI Agent Memory Architecture: Hierarchical Memory, Graph Memory & Hybrid Retrieval
Trong những hệ thống AI Agent cơ bản, memory thường được triển khai bằng cách lưu lại các đoạn hội thoại, tạo embedding và sử dụng Vector Search để tìm kiếm thông tin liên quan. Cách tiếp cận này hoạt động khá tốt khi dữ liệu còn nhỏ và các câu hỏi chủ yếu xoay quanh nội dung tương tự với những gì đã lưu.
Tuy nhiên, khi một AI Agent phải làm việc trong thời gian dài, quản lý nhiều dự án, ghi nhớ sở thích của người dùng, theo dõi các sự kiện và hiểu mối quan hệ giữa hàng nghìn thực thể, việc chỉ dựa vào một Vector Database có thể trở nên hạn chế.
Ví dụ, người dùng hỏi:
“Những dự án nào của tôi đang sử dụng công nghệ do công ty A phát triển, và dự án nào có liên quan đến báo cáo tài chính quý trước?”
Để trả lời, Agent không chỉ cần tìm những đoạn văn có ý nghĩa tương tự câu hỏi. Nó còn phải hiểu các mối quan hệ giữa dự án, công nghệ, công ty và báo cáo.
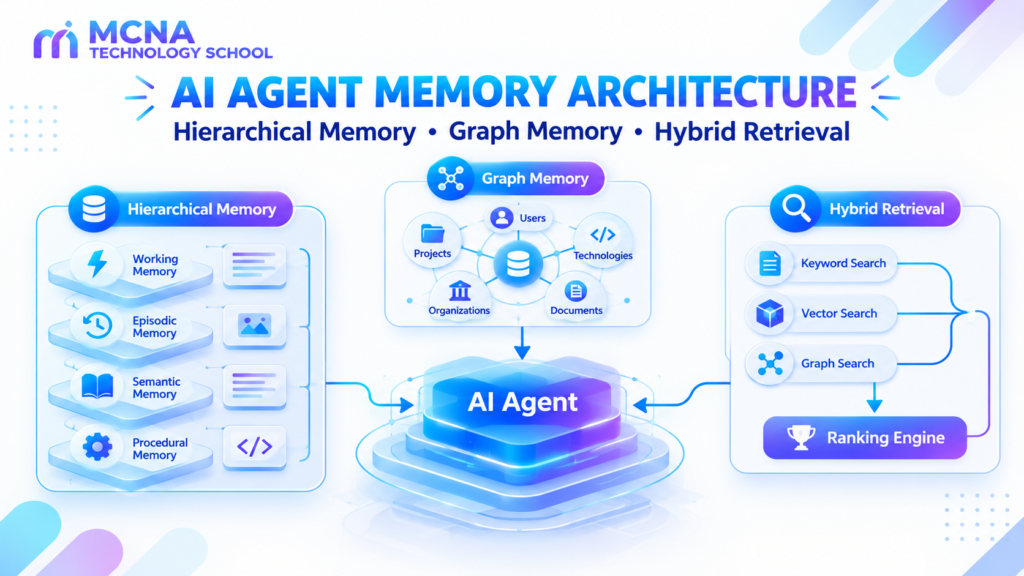
Đây là lúc kiến trúc bộ nhớ nâng cao phát huy tác dụng. Thay vì lưu tất cả thông tin vào một lớp duy nhất, hệ thống có thể tổ chức memory theo nhiều tầng, biểu diễn quan hệ bằng Knowledge Graph và kết hợp nhiều phương pháp truy xuất.
Trong bài viết này, chúng ta sẽ tìm hiểu ba thành phần chính: Hierarchical Memory, Graph Memory và Hybrid Retrieval, đồng thời xây dựng một kiến trúc minh họa sử dụng Python, PostgreSQL, pgvector và Neo4j.
1. Vì sao AI Agent cần một kiến trúc Memory nâng cao?
Hãy tưởng tượng một AI Assistant được sử dụng trong doanh nghiệp. Sau một thời gian, hệ thống cần ghi nhớ:
- Thông tin người dùng và sở thích cá nhân.
- Các cuộc hội thoại và sự kiện đã xảy ra.
- Các dự án đang triển khai và trạng thái hiện tại.
- Các công nghệ, công cụ và hệ thống đang được sử dụng.
- Mối quan hệ giữa nhân viên, phòng ban, dự án và khách hàng.
- Các quy trình làm việc và quy tắc cần tuân thủ.
Nếu tất cả được lưu thành những đoạn văn bản độc lập, hệ thống sẽ gặp khó khăn khi cần tổng hợp thông tin từ nhiều nguồn.
Có thể hình dung ba hạn chế chính:
| Hạn chế | Nguyên nhân | Giải pháp kiến trúc |
|---|---|---|
| Memory quá lớn | Tất cả thông tin được lưu trong một lớp | Hierarchical Memory |
| Thiếu hiểu biết về quan hệ | Vector Search chỉ ưu tiên độ tương đồng ngữ nghĩa | Graph Memory |
| Truy xuất chưa đầy đủ | Một phương pháp tìm kiếm không phù hợp với mọi câu hỏi | Hybrid Retrieval |
Mục tiêu của một kiến trúc memory tốt không phải là lưu trữ càng nhiều càng tốt. Mục tiêu là tổ chức thông tin sao cho Agent có thể tìm được đúng dữ liệu, hiểu được mối quan hệ và sử dụng đúng ngữ cảnh.
2. Hierarchical Memory – Kiến trúc bộ nhớ phân tầng
Hierarchical Memory là cách tổ chức memory thành nhiều lớp theo phạm vi, thời gian hoặc mức độ trừu tượng của thông tin.
Thay vì tìm kiếm toàn bộ dữ liệu mỗi khi người dùng đặt câu hỏi, Agent có thể lựa chọn tầng memory phù hợp với yêu cầu.
2.1. Working Memory – Bộ nhớ làm việc
Working Memory lưu những thông tin cần thiết cho nhiệm vụ hoặc lượt tương tác hiện tại.
Ví dụ:
- Câu hỏi hiện tại của người dùng.
- Các thông tin vừa được cung cấp trong cuộc hội thoại.
- Kết quả từ những công cụ Agent vừa gọi.
- Các bước đang thực hiện trong một workflow.
Working Memory thường có vòng đời ngắn và được cập nhật liên tục trong quá trình thực thi.
Trong một Agent framework, phần này có thể được biểu diễn bằng state của workflow hoặc conversation context.
2.2. Episodic Memory – Bộ nhớ sự kiện
Episodic Memory lưu lại những trải nghiệm hoặc sự kiện cụ thể đã xảy ra.
Ví dụ:
- Ngày 10/10, người dùng bắt đầu dự án Data Warehouse.
- Ngày 12/10, Agent tạo báo cáo doanh thu cho dự án.
- Ngày 15/10, người dùng yêu cầu thay đổi cấu trúc báo cáo.
Điểm quan trọng của Episodic Memory là thông tin có ngữ cảnh và thời gian. Nó giúp Agent trả lời những câu hỏi như:
- Điều gì đã xảy ra trong dự án?
- Người dùng đã yêu cầu thay đổi gì?
- Vì sao hệ thống đưa ra quyết định trước đó?
2.3. Semantic Memory – Bộ nhớ kiến thức
Semantic Memory lưu các sự thật, khái niệm và kiến thức đã được trích xuất từ dữ liệu.
Ví dụ:
- PostgreSQL là hệ quản trị cơ sở dữ liệu quan hệ.
- Dự án Data Warehouse sử dụng PostgreSQL.
- Phòng Data chịu trách nhiệm phát triển hệ thống báo cáo.
Khác với Episodic Memory, Semantic Memory không nhất thiết phải lưu toàn bộ diễn biến của sự kiện. Nó tập trung vào những thông tin có ý nghĩa và có thể tái sử dụng trong nhiều tình huống.
2.4. Procedural Memory – Bộ nhớ quy trình
Procedural Memory lưu những hướng dẫn, quy tắc và cách thức thực hiện một nhiệm vụ.
Ví dụ:
- Quy trình tạo báo cáo doanh thu.
- Cách kết nối tới database.
- Các bước kiểm tra dữ liệu trước khi xuất báo cáo.
- Quy tắc phê duyệt trước khi thực hiện một hành động quan trọng.
Đây là loại memory đặc biệt hữu ích với các Agent có khả năng sử dụng tools và thực hiện workflow nhiều bước.
2.5. Tổng hợp kiến trúc Hierarchical Memory
| Memory Layer | Thông tin lưu trữ | Ví dụ |
|---|---|---|
| Working | Ngữ cảnh hiện tại | Câu hỏi đang xử lý |
| Episodic | Sự kiện và trải nghiệm | Lịch sử thay đổi dự án |
| Semantic | Sự thật và kiến thức | Thông tin về công nghệ |
| Procedural | Quy trình và hướng dẫn | Các bước tạo báo cáo |
Lưu ý: Đây là cách phân loại theo bản chất thông tin, không phải một thứ tự bắt buộc từ tầng thấp đến tầng cao. Working Memory có thể chứa thông tin được lấy từ nhiều loại memory dài hạn khác nhau.
LangGraph cũng phân biệt Short-term Memory và Long-term Memory theo phạm vi lưu trữ, đồng thời đề cập đến Semantic, Episodic và Procedural Memory như những cách phân loại theo loại thông tin được ghi nhớ.
3. Graph Memory – Biểu diễn bộ nhớ bằng Knowledge Graph
Vector Database rất hiệu quả khi cần tìm kiếm những nội dung có ý nghĩa tương tự. Tuy nhiên, nó không trực tiếp biểu diễn các mối quan hệ có cấu trúc giữa những thực thể.
Graph Memory giải quyết vấn đề này bằng cách biểu diễn dữ liệu dưới dạng các node và relationship.
3.1. Node và Relationship là gì?
Trong Knowledge Graph, dữ liệu thường được biểu diễn bằng hai thành phần:
- Node: Đại diện cho một thực thể như người dùng, công ty, dự án, công nghệ hoặc tài liệu.
- Relationship: Đại diện cho mối quan hệ giữa hai thực thể.
Ví dụ, với một hệ thống quản lý dự án, ta có thể tạo các node:
- Person: Nguyễn Văn A.
- Project: Sales Dashboard.
- Technology: PostgreSQL.
- Company: MCNA Technology School.
Các relationship có thể bao gồm:
- Nguyễn Văn A – WORKS_ON – Sales Dashboard.
- Sales Dashboard – USES – PostgreSQL.
- Sales Dashboard – BELONGS_TO – MCNA Technology School.
Nhờ cấu trúc này, Agent có thể lần theo các mối quan hệ để tìm thông tin liên quan.
3.2. Ví dụ Knowledge Graph
          (Person)
       Nguyen Van A
              |
          WORKS_ON
              |
              v
          (Project)
       Sales Dashboard
          /       \
       USES      BELONGS_TO
        /              \
       v                v
 (Technology)       (Company)
  PostgreSQL          MCNA
Giả sử người dùng hỏi:
“Những công nghệ nào đang được sử dụng trong dự án Sales Dashboard?”
Agent có thể tìm node Sales Dashboard, sau đó đi theo relationship USES để lấy các node công nghệ liên quan.
Đây là một truy vấn theo cấu trúc quan hệ, không chỉ là tìm kiếm các đoạn văn có nội dung tương tự.
3.3. Khi nào nên sử dụng Graph Memory?
| Tình huống | Lợi ích của Graph Memory |
|---|---|
| Quản lý dự án | Liên kết dự án, nhân sự, công nghệ và nhiệm vụ |
| Customer Intelligence | Liên kết khách hàng, sản phẩm và giao dịch |
| Enterprise AI | Biểu diễn phòng ban, nhân sự và quy trình |
| Research Assistant | Liên kết nghiên cứu, tác giả và chủ đề |
| Personal Assistant | Liên kết người dùng, sở thích và sự kiện |
Graph Memory đặc biệt hữu ích khi câu hỏi yêu cầu tìm hiểu mối quan hệ trực tiếp hoặc gián tiếp giữa nhiều thực thể.
4. Triển khai Graph Memory với Neo4j và Cypher
Neo4j là một graph database phổ biến, sử dụng mô hình Property Graph để lưu node, relationship và các thuộc tính đi kèm.
Ngôn ngữ truy vấn của Neo4j là Cypher.
4.1. Cài đặt thư viện
pip install neo4j4.2. Kết nối Neo4j bằng Python
from neo4j import GraphDatabase

URI = "bolt://localhost:7687"
USERNAME = "neo4j"
PASSWORD = "your_password"

driver = GraphDatabase.driver(
    URI,
    auth=(USERNAME, PASSWORD)
)

driver.verify_connectivity()

print("Connected to Neo4j")
Trong môi trường production, thông tin kết nối cần được lấy từ environment variables hoặc secret manager, không hard-code mật khẩu trong source code.
4.3. Tạo các node và relationship
def create_project_graph(tx):
    query = """
    MERGE (person:Person {
        name: $person_name
    })

    MERGE (project:Project {
        name: $project_name
    })

    MERGE (technology:Technology {
        name: $technology_name
    })

    MERGE (person)-[:WORKS_ON]->(project)

    MERGE (project)-[:USES]->(technology)
    """

    tx.run(
        query,
        person_name="Nguyen Van A",
        project_name="Sales Dashboard",
        technology_name="PostgreSQL"
    )


with driver.session() as session:
    session.execute_write(create_project_graph)

driver.close()
Ở đây, MERGE giúp tìm node hoặc relationship đã tồn tại trước khi tạo mới, hạn chế việc tạo bản ghi trùng lặp khi chạy lại cùng một thao tác. Tuy nhiên, trong hệ thống thực tế vẫn cần xác định khóa định danh và ràng buộc uniqueness phù hợp.
4.4. Truy vấn các công nghệ của dự án
MATCH (p:Project {name: "Sales Dashboard"})
      -[:USES]->(t:Technology)

RETURN p.name AS project,
       collect(t.name) AS technologies
Kết quả minh họa:
project: Sales Dashboard
technologies: ["PostgreSQL"]
Chỉ với một truy vấn, hệ thống có thể lấy danh sách công nghệ thông qua mối quan hệ đã được lưu trong graph.
5. Hybrid Retrieval – Kết hợp nhiều phương pháp truy xuất
Trong thực tế, không có một phương pháp tìm kiếm nào phù hợp với mọi loại câu hỏi.
Ba phương pháp thường được kết hợp trong Hybrid Retrieval là:
5.1. Keyword Search
Keyword Search tìm kiếm dựa trên từ khóa hoặc nội dung khớp với truy vấn.
Ví dụ, khi người dùng tìm “PostgreSQL”, hệ thống cần tìm được chính xác các bản ghi chứa tên công nghệ này.
Phương pháp này đặc biệt hữu ích với:
- Tên người và tên công ty.
- Mã sản phẩm và mã dự án.
- Tên công nghệ và thuật ngữ chuyên ngành.
- Các từ khóa có tính định danh cao.
5.2. Vector Search
Vector Search sử dụng embedding để tìm kiếm nội dung có ý nghĩa ngữ nghĩa gần với câu hỏi.
Ví dụ, câu hỏi “Công cụ nào được dùng để lưu trữ dữ liệu quan hệ?” có thể tìm thấy nội dung về PostgreSQL dù câu hỏi không chứa chính xác từ khóa PostgreSQL.
Phương pháp này phù hợp với câu hỏi tự nhiên, cách diễn đạt đa dạng và truy vấn có ý nghĩa tương đương.
5.3. Graph Retrieval
Graph Retrieval tìm kiếm bằng cách truy xuất các node và relationship liên quan.
Ví dụ, nếu người dùng hỏi “Ai đang làm việc trong dự án sử dụng PostgreSQL?”, hệ thống có thể:
- Tìm node Technology có tên PostgreSQL.
- Lần theo relationship USES để tìm các dự án.
- Lần tiếp relationship WORKS_ON để tìm những người tham gia.
Đây là kiểu truy vấn nhiều bước, thường được gọi là multi-hop retrieval.
5.4. Kết hợp ba phương pháp
Một hệ thống Hybrid Retrieval có thể thực hiện theo quy trình:
- Keyword Search tìm các kết quả khớp chính xác.
- Vector Search tìm những đoạn nội dung tương đồng về ngữ nghĩa.
- Graph Retrieval mở rộng các thực thể và mối quan hệ liên quan.
- Hệ thống hợp nhất và xếp hạng kết quả.
- LLM sử dụng context cuối cùng để tạo câu trả lời.
Không phải truy vấn nào cũng cần chạy cả ba phương pháp. Một query planner có thể lựa chọn phương pháp phù hợp dựa trên loại câu hỏi.
6. Reranking và Reciprocal Rank Fusion trong Hybrid Retrieval
Khi kết hợp nhiều bộ truy xuất, hệ thống có thể nhận được nhiều kết quả khác nhau. Một vấn đề xuất hiện là mỗi phương pháp có cách tính điểm riêng.
Ví dụ:
| Document | Keyword Rank | Vector Rank |
|---|---|---|
| Document A | 1 | 4 |
| Document B | 3 | 1 |
| Document C | 2 | 2 |
Không nên cộng trực tiếp điểm số từ hai bộ truy xuất nếu chúng không cùng thang đo.
Một phương pháp phổ biến là Reciprocal Rank Fusion (RRF).
Công thức:
RRF(d) = Σ 1 / (k + rank(d))
Trong đó:
dlà tài liệu đang được đánh giá.rank(d)là vị trí của tài liệu trong từng danh sách kết quả.klà hằng số làm giảm ảnh hưởng của thứ hạng.
Ví dụ Python:
def reciprocal_rank_fusion(
    result_lists,
    k=60
):
    scores = {}

    for result_list in result_lists:

        for rank, document_id in enumerate(
            result_list,
            start=1
        ):
            if document_id not in scores:
                scores[document_id] = 0

            scores[document_id] += (
                1 / (k + rank)
            )

    ranked_results = sorted(
        scores.items(),
        key=lambda x: x[1],
        reverse=True
    )

    return ranked_results


keyword_results = ["A", "C", "B"]
vector_results = ["B", "C", "A"]

results = reciprocal_rank_fusion([
    keyword_results,
    vector_results
])

for document_id, score in results:
    print(document_id, round(score, 4))
RRF giúp kết hợp các danh sách kết quả theo thứ hạng mà không cần chuẩn hóa trực tiếp các điểm số gốc.
6.1. Reranking – Xếp hạng lại kết quả
Sau bước hợp nhất, hệ thống có thể sử dụng một reranker để đánh giá mức độ liên quan giữa câu hỏi và từng kết quả.
Khác với bước retrieval ưu tiên tốc độ và khả năng tìm ứng viên, reranking thường tập trung vào chất lượng xếp hạng của một tập kết quả nhỏ hơn.
Ví dụ:
- Retrieval lấy 30 kết quả từ nhiều nguồn.
- RRF hợp nhất các kết quả trùng lặp.
- Reranker đánh giá 15 ứng viên còn lại.
- Hệ thống chỉ đưa 5 kết quả tốt nhất vào context.
Các con số trên chỉ là ví dụ minh họa. Số lượng ứng viên cần được điều chỉnh theo độ trễ, chi phí và chất lượng dữ liệu thực tế.
7. Kiến trúc kết hợp PostgreSQL, pgvector và Neo4j
Một kiến trúc thực tế có thể sử dụng nhiều hệ thống lưu trữ, mỗi hệ thống đảm nhiệm một loại dữ liệu phù hợp với thế mạnh của nó.
7.1. Vai trò của từng thành phần
| Thành phần | Vai trò |
|---|---|
| Redis hoặc Agent State | Working Memory và dữ liệu phiên làm việc |
| PostgreSQL | Dữ liệu có cấu trúc, sự kiện và metadata |
| pgvector | Vector Search trên memory và document chunks |
| Neo4j | Knowledge Graph và relationship traversal |
| LLM | Trích xuất thông tin, lập kế hoạch truy xuất và tạo câu trả lời |
Không bắt buộc phải sử dụng tất cả các công nghệ trên. Với ứng dụng nhỏ, PostgreSQL kết hợp pgvector có thể đã đáp ứng đủ nhu cầu. Graph Database chỉ nên được bổ sung khi quan hệ giữa các thực thể mang lại giá trị thực sự.
7.2. Kiến trúc tổng thể
                   USER QUERY
                       |
                       v
                  AI AGENT
                       |
                       v
                  QUERY PLANNER
                       |
          +------------+------------+
          |            |            |
          v            v            v
      KEYWORD       VECTOR        GRAPH
      SEARCH        SEARCH        SEARCH
          |            |            |
          v            v            v
     PostgreSQL     pgvector      Neo4j
          |            |            |
          +------------+------------+
                       |
                       v
                RESULT FUSION
                       |
                       v
                   RERANKER
                       |
                       v
                CONTEXT BUILDER
                       |
                       v
                     LLM
                       |
                       v
                 FINAL ANSWER
Ở chiều ghi dữ liệu, hệ thống có thể triển khai một pipeline riêng:
              CONVERSATION / DOCUMENT
                         |
                         v
                  MEMORY EXTRACTION
                         |
                         v
                  ENTITY EXTRACTION
                         |
              +----------+----------+
              |                     |
              v                     v
         STRUCTURED FACTS       TEXT CHUNKS
              |                     |
              v                     v
          PostgreSQL              EMBEDDING
              |                     |
              v                     v
           Neo4j                pgvector
              |                     |
              +----------+----------+
                         |
                         v
                  MEMORY MANAGEMENT
Kiến trúc này tách biệt quá trình ghi nhận thông tin và quá trình truy xuất, giúp hệ thống dễ mở rộng và tối ưu từng thành phần.
8. Xây dựng Hybrid Retrieval Pipeline bằng Python
Để minh họa, chúng ta sẽ xây dựng một pipeline kết hợp ba nguồn kết quả: keyword search, vector search và graph search.
Trong ví dụ này, ba hàm retrieval được mô phỏng bằng dữ liệu mẫu. Khi triển khai thật, có thể thay thế chúng bằng PostgreSQL Full-text Search, pgvector và Neo4j.
Bước 1: Chuẩn bị dữ liệu
documents = {
    "doc_1": "Sales Dashboard sử dụng PostgreSQL.",
    "doc_2": "Dự án Sales Dashboard thuộc MCNA.",
    "doc_3": "Nguyễn Văn A đang làm việc trong Sales Dashboard.",
    "doc_4": "PostgreSQL là hệ quản trị cơ sở dữ liệu.",
    "doc_5": "Dự án Marketing sử dụng MySQL."
}

keyword_results = [
    "doc_1",
    "doc_4"
]

vector_results = [
    "doc_1",
    "doc_2",
    "doc_5"
]

graph_results = [
    "doc_1",
    "doc_2",
    "doc_3"
]
Bước 2: Hợp nhất kết quả
def reciprocal_rank_fusion(
    result_lists,
    k=60
):
    scores = {}

    for result_list in result_lists:

        for rank, doc_id in enumerate(
            result_list,
            start=1
        ):
            scores[doc_id] = (
                scores.get(doc_id, 0)
                + 1 / (k + rank)
            )

    return sorted(
        scores.items(),
        key=lambda x: x[1],
        reverse=True
    )


retrieval_results = reciprocal_rank_fusion([
    keyword_results,
    vector_results,
    graph_results
])

print(retrieval_results)
Bước 3: Lấy Top K documents
def get_top_documents(
    ranked_results,
    documents,
    top_k=3
):
    selected_documents = []

    for doc_id, score in ranked_results[:top_k]:

        selected_documents.append({
            "id": doc_id,
            "content": documents[doc_id],
            "score": score
        })

    return selected_documents


top_documents = get_top_documents(
    retrieval_results,
    documents,
    top_k=3
)

for item in top_documents:
    print(item["id"], item["content"])
Bước 4: Xây dựng context cho LLM
def build_context(documents):
    context = ""

    for item in documents:
        context += (
            f"\n[{item['id']}] "
            f"{item['content']}"
        )

    return context


context = build_context(top_documents)

print(context)
Context này có thể được truyền vào prompt của LLM để tạo câu trả lời. Trong hệ thống production, cần giữ lại nguồn gốc của từng đoạn thông tin, kiểm tra quyền truy cập và loại bỏ các dữ liệu không được phép đưa vào context.
9. GraphRAG – Kết hợp Knowledge Graph và RAG
GraphRAG là một kiến trúc Retrieval-Augmented Generation sử dụng cấu trúc graph để cải thiện khả năng truy xuất và kết nối thông tin.
Trong RAG truyền thống, hệ thống thường chia tài liệu thành các chunks, tạo embedding và tìm kiếm những chunks gần nhất với câu hỏi.
Trong GraphRAG, quá trình này được mở rộng bằng việc trích xuất thực thể và quan hệ từ nội dung, xây dựng Knowledge Graph rồi sử dụng graph cùng với vector retrieval.
9.1. Quy trình xây dựng GraphRAG
- Document Processing: Đọc và chia tài liệu thành các chunks.
- Entity Extraction: Trích xuất người, tổ chức, địa điểm, công nghệ và các thực thể khác.
- Relationship Extraction: Xác định mối quan hệ giữa những thực thể.
- Graph Construction: Xây dựng Knowledge Graph.
- Embedding: Tạo vector cho chunks hoặc các đối tượng cần tìm kiếm.
- Graph Retrieval: Tìm các thực thể, chunks và quan hệ liên quan.
- Answer Generation: Kết hợp context và yêu cầu LLM tạo câu trả lời.
9.2. Hai hướng truy xuất phổ biến
Local Retrieval: Tìm một thực thể cụ thể rồi mở rộng sang các thực thể và quan hệ lân cận.
Ví dụ: Tìm thông tin về công ty A, sau đó truy xuất các dự án, sản phẩm và nhân sự có liên quan đến công ty này.
Global Retrieval: Tìm kiếm ở cấp độ tổng quan, thường sử dụng các cụm chủ đề hoặc community summaries trong Knowledge Graph.
Ví dụ: “Những chủ đề chính xuất hiện trong toàn bộ tập tài liệu nghiên cứu là gì?”
Microsoft GraphRAG là một dự án tham khảo đáng chú ý cho hướng tiếp cận này. Hệ thống sử dụng Knowledge Graph, phân cụm và tóm tắt các community để hỗ trợ truy xuất thông tin ở nhiều cấp độ.
Tài liệu: Microsoft GraphRAG Documentation.
10. Những thách thức khi triển khai Memory Architecture
10.1. Đồng bộ dữ liệu giữa nhiều database
Khi PostgreSQL, pgvector và Neo4j cùng lưu các phần dữ liệu liên quan, việc cập nhật ở một hệ thống nhưng thất bại ở hệ thống khác có thể khiến memory không nhất quán.
Có thể sử dụng event-driven architecture, background workers và cơ chế retry để quản lý quá trình đồng bộ. Mỗi sự kiện nên có ID duy nhất để hạn chế xử lý trùng lặp.
10.2. Entity Resolution
Một thực thể có thể xuất hiện dưới nhiều tên gọi khác nhau.
Ví dụ:
- MCNA Technology School.
- MCNA.
- MCNA Technology.
Nếu không có cơ chế entity resolution, hệ thống có thể tạo ra nhiều node đại diện cho cùng một thực thể.
Giải pháp có thể kết hợp canonical ID, chuẩn hóa tên, metadata và kiểm tra ngữ nghĩa.
10.3. Graph Growth
Knowledge Graph có thể phát triển rất nhanh khi liên tục tiếp nhận dữ liệu mới. Các relationship không cần thiết hoặc được trích xuất sai có thể làm graph phức tạp và giảm chất lượng truy xuất.
Do đó, cần có quy trình kiểm tra, hợp nhất thực thể, quản lý thời gian hiệu lực và xác minh nguồn gốc của relationship.
10.4. Retrieval Latency và Chi phí
Việc chạy đồng thời nhiều bộ truy xuất có thể làm tăng thời gian phản hồi.
Không phải câu hỏi nào cũng cần Vector Search và Graph Traversal. Một query planner nên phân loại câu hỏi và lựa chọn chiến lược phù hợp.
10.5. Data Security và Access Control
Graph có thể kết nối nhiều nguồn dữ liệu khác nhau. Nếu không kiểm soát quyền truy cập ở cấp node, relationship và tài liệu nguồn, Agent có thể vô tình tiết lộ thông tin mà người dùng không có quyền xem.
Cần áp dụng tenant isolation, authorization tại tầng truy xuất và kiểm tra quyền trước khi đưa dữ liệu vào LLM context.
11. Khi nào nên sử dụng từng kiến trúc?
| Kiến trúc | Phù hợp khi | Ví dụ |
|---|---|---|
| Hierarchical Memory | Thông tin có nhiều loại và vòng đời khác nhau | Personal AI Assistant |
| Graph Memory | Các thực thể có nhiều mối quan hệ | Enterprise Knowledge Assistant |
| Vector Retrieval | Cần tìm kiếm theo ý nghĩa | Document Q&A |
| Keyword Retrieval | Cần khớp chính xác tên hoặc mã | Product Search |
| Hybrid Retrieval | Cần kết hợp nhiều dạng tìm kiếm | Enterprise RAG |
| GraphRAG | Câu hỏi cần kết nối thông tin từ nhiều nguồn | Research Assistant |
Một nguyên tắc quan trọng là không nên xây dựng kiến trúc phức tạp chỉ vì công nghệ mới có nhiều tính năng. Hãy bắt đầu từ yêu cầu truy xuất, cấu trúc dữ liệu và những vấn đề mà hệ thống hiện tại chưa giải quyết được.
12. Kết luận
Kiến trúc bộ nhớ là một yếu tố quyết định khả năng mở rộng và chất lượng hoạt động của AI Agent.
Ba hướng tiếp cận quan trọng trong bài viết gồm:
- Hierarchical Memory: Tổ chức thông tin theo loại và phạm vi sử dụng, giúp Agent quản lý nhiều dạng memory khác nhau.
- Graph Memory: Biểu diễn thực thể và mối quan hệ, hỗ trợ suy luận trên những thông tin có liên kết.
- Hybrid Retrieval: Kết hợp Keyword Search, Vector Search và Graph Retrieval để tìm kiếm thông tin toàn diện hơn.
Khi kết hợp đúng cách, những thành phần này tạo nên một hệ thống memory có khả năng lưu trữ, kết nối và truy xuất thông tin linh hoạt hơn. Tuy nhiên, kiến trúc phù hợp vẫn phụ thuộc vào quy mô dữ liệu, loại câu hỏi, yêu cầu bảo mật và ngân sách vận hành.
Đối với các dự án AI Agent thực tế, có thể bắt đầu với PostgreSQL và pgvector, sau đó bổ sung Graph Database khi nhu cầu khai thác mối quan hệ giữa các thực thể trở nên rõ ràng.
13. Tài liệu tham khảo
- LangGraph Documentation – Memory
- Neo4j – GraphRAG Documentation
- Neo4j – LangGraph Integration
- Microsoft – GraphRAG
- pgvector – PostgreSQL Vector Similarity Search
- Neo4j – Cypher Manual
14. Học thêm về AI và Data tại MCNA Technology School
Nếu bạn muốn phát triển nền tảng về Python, Data Analytics, Power BI và ứng dụng AI vào các dự án thực tế, hãy tham khảo các chương trình đào tạo tại MCNA Technology School: