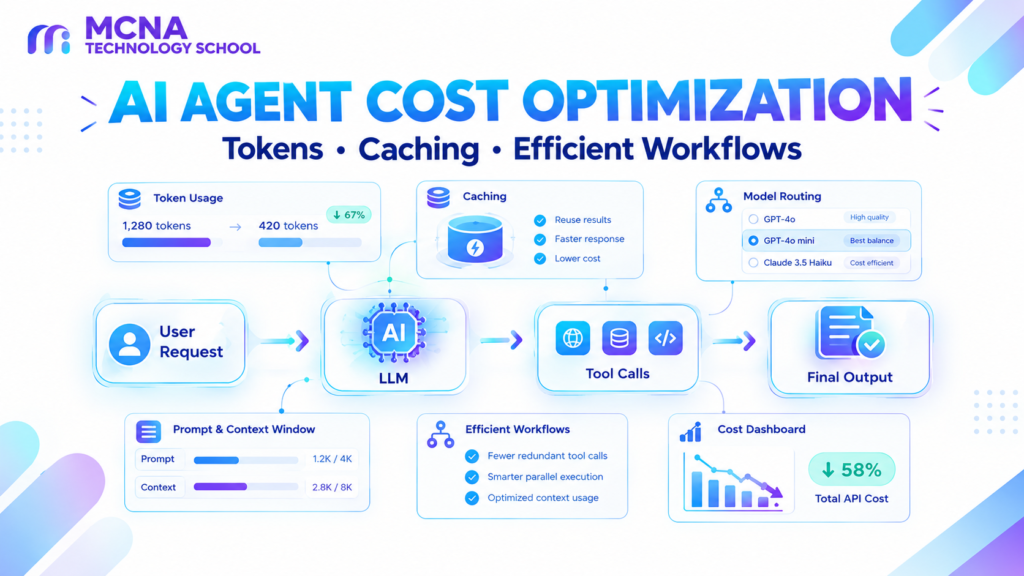
Khi triển khai ở quy mô lớn, những khoản chi phí nhỏ trong từng yêu cầu có thể tích lũy thành chi phí vận hành đáng kể. Vì vậy, AI Agent Cost Optimization không chỉ là lựa chọn một mô hình rẻ hơn, mà còn là thiết kế workflow sao cho mỗi lần gọi mô hình và công cụ đều tạo ra giá trị thực sự.
Trong bài viết này, MCNA Technology School sẽ hướng dẫn các nguyên tắc tối ưu chi phí LLM, cách kiểm soát token, sử dụng caching, giới hạn vòng lặp Agent và xây dựng công cụ ước tính chi phí bằng Python.
1. AI Agent Cost Optimization là gì?
AI Agent Cost Optimization là quá trình giảm chi phí vận hành AI Agent trong khi vẫn duy trì chất lượng đầu ra, độ tin cậy và thời gian phản hồi phù hợp với yêu cầu của ứng dụng.
Chi phí của một AI Agent không chỉ đến từ câu trả lời cuối cùng. Một workflow có thể thực hiện nhiều lượt gọi LLM, sử dụng các công cụ bên ngoài, truy xuất dữ liệu và thử lại khi gặp lỗi. Mỗi thành phần đều có thể tạo ra chi phí hoặc tiêu thụ tài nguyên.
Ví dụ, một Agent phân tích dữ liệu bán hàng có thể thực hiện các bước:
- Phân tích yêu cầu người dùng.
- Gọi mô hình để lựa chọn công cụ.
- Đọc dữ liệu từ file hoặc cơ sở dữ liệu.
- Gọi mô hình để diễn giải kết quả.
- Kiểm tra và hoàn thiện báo cáo.
Nếu hệ thống gọi LLM nhiều lần không cần thiết hoặc gửi một lượng lớn dữ liệu lặp lại ở mỗi bước, chi phí có thể tăng nhanh dù bài toán ban đầu khá đơn giản.
1.1. Những yếu tố ảnh hưởng đến chi phí
- Input tokens: token trong system prompt, hướng dẫn, lịch sử hội thoại, tài liệu và dữ liệu đầu vào.
- Output tokens: token được sinh ra trong câu trả lời hoặc kết quả trung gian.
- Số lượt gọi LLM: một tác vụ có thể yêu cầu nhiều lần gọi mô hình.
- Model được sử dụng: các model có mức giá và năng lực khác nhau.
- Tool calls: lời gọi công cụ có thể phát sinh chi phí API, truy vấn hoặc hạ tầng riêng.
- Retry và vòng lặp: những lần thử lại hoặc lặp không cần thiết làm tăng mức tiêu thụ tài nguyên.
- Context management: việc gửi lại lịch sử dài hoặc tài liệu trùng lặp làm tăng lượng đầu vào cần xử lý.
2. Cách tính chi phí của một AI Agent
Để tối ưu hiệu quả, trước hết cần xác định chi phí đến từ đâu. Với API tính phí theo token, có thể ước tính chi phí cho một lượt gọi mô hình bằng công thức:
Chi phí LLM = Chi phí input tokens + Chi phí output tokens.
Nếu nhà cung cấp áp dụng mức giá khác nhau cho token đầu vào thông thường, token đầu vào được cache và token đầu ra, cần tính từng nhóm riêng biệt.
Với trường hợp đơn giản không có caching:
input_cost = input_tokens * input_price / 1000000
output_cost = output_tokens * output_price / 1000000

total_cost = input_cost + output_cost
Trong đó, input_price và output_price là giá cho một triệu token theo đơn vị tiền tệ được công bố trong bảng giá của nhà cung cấp.
2.1. Ví dụ minh họa
Giả sử một model có mức giá giả định:
- Input: 1 USD cho mỗi một triệu token.
- Output: 5 USD cho mỗi một triệu token.
Một lần gọi sử dụng 10.000 input tokens và 2.000 output tokens sẽ có chi phí minh họa:
- Input: 10.000 × 1 / 1.000.000 = 0,01 USD.
- Output: 2.000 × 5 / 1.000.000 = 0,01 USD.
- Tổng: 0,02 USD cho một lần gọi.
Đây là mức giá giả định để minh họa công thức, không phải báo giá của một model cụ thể. Giá thực tế cần được kiểm tra theo model, loại token, phương thức xử lý và bảng giá hiện hành.
2.2. Chi phí của cả workflow
Đối với AI Agent, cần cộng chi phí của tất cả các lần gọi mô hình trong một nhiệm vụ, thay vì chỉ tính lần gọi cuối cùng.
Chi phí workflow = Tổng chi phí các lượt gọi LLM + Chi phí công cụ và hạ tầng liên quan.
Phần công cụ và hạ tầng có thể bao gồm API bên ngoài, truy vấn dữ liệu, dịch vụ lưu trữ hoặc tài nguyên máy chủ. Các khoản này cần được tính riêng theo cách tính phí của từng dịch vụ.
3. Kỹ thuật 1 – Giảm số lượng token đầu vào
Input tokens thường đến từ system prompt, lịch sử hội thoại, định nghĩa công cụ, ví dụ minh họa và dữ liệu được cung cấp cho mô hình. Nếu những nội dung này quá dài hoặc bị lặp lại, ứng dụng có thể tiêu tốn nhiều token hơn mức cần thiết.
3.1. Rút gọn system prompt
System prompt nên chứa vai trò, mục tiêu, quy tắc quan trọng và những giới hạn cần thiết. Các hướng dẫn trùng lặp hoặc những đoạn giải thích dài nhưng không ảnh hưởng đến kết quả có thể được loại bỏ sau khi kiểm thử.
Ví dụ, thay vì cung cấp nhiều đoạn hướng dẫn diễn đạt cùng một ý, có thể sử dụng các quy tắc rõ ràng:
instructions = """
Bạn là trợ lý phân tích dữ liệu.
Sử dụng dữ liệu được cung cấp để trả lời.
Không tự tạo số liệu không có trong nguồn.
Trình bày kết luận ngắn gọn và nêu rõ giới hạn dữ liệu.
"""
Rút gọn prompt không có nghĩa là xóa các quy tắc quan trọng. Sau mỗi thay đổi, nên kiểm tra chất lượng câu trả lời trên một bộ câu hỏi đại diện để bảo đảm hệ thống vẫn đáp ứng yêu cầu.
3.2. Không gửi toàn bộ lịch sử hội thoại khi không cần thiết
Trong một cuộc hội thoại dài, lịch sử trước đó có thể tăng lên đáng kể. Thay vì gửi tất cả tin nhắn ở mỗi lượt, ứng dụng có thể giữ lại một phần lịch sử gần nhất và một bản tóm tắt những thông tin quan trọng.
Ví dụ, khi người dùng đã xác định file dữ liệu, khoảng thời gian và các chỉ số cần phân tích, Agent không nhất thiết phải gửi lại toàn bộ các trao đổi trước đó nếu những thông tin này đã được tổng hợp thành trạng thái nhiệm vụ.
Cần bảo đảm bản tóm tắt vẫn giữ được các điều kiện quan trọng, số liệu chính xác và những quyết định đã thống nhất. Với các tác vụ yêu cầu độ chính xác cao, hãy giữ tham chiếu đến dữ liệu gốc để có thể kiểm tra lại.
3.3. Chỉ đưa dữ liệu liên quan vào context
Nếu người dùng yêu cầu phân tích doanh thu theo tháng, việc đưa toàn bộ dữ liệu không liên quan vào prompt sẽ làm tăng lượng đầu vào. Có thể xử lý dữ liệu bằng Python hoặc SQL trước, sau đó chỉ cung cấp bảng tổng hợp cần thiết cho LLM.
Đây là cách kết hợp hiệu quả giữa lập trình truyền thống và AI: để Python hoặc SQL thực hiện phép tính xác định, còn LLM tập trung vào diễn giải, giải thích và hỗ trợ ra quyết định.
4. Kỹ thuật 2 – Giới hạn output tokens
Output tokens cũng ảnh hưởng trực tiếp đến chi phí. Nếu ứng dụng chỉ cần một nhãn phân loại hoặc một kết quả ngắn, việc yêu cầu mô hình viết một bài giải thích dài sẽ gây lãng phí.
4.1. Xác định độ dài đầu ra theo tác vụ
- Phân loại: chỉ trả về nhãn và có thể kèm điểm tin cậy nếu hệ thống hỗ trợ.
- Trích xuất dữ liệu: trả về những trường cần thiết theo schema.
- Tóm tắt: giới hạn số ý hoặc độ dài mục tiêu.
- Báo cáo: xác định trước các mục cần có thay vì yêu cầu giải thích không giới hạn.
Với API hỗ trợ giới hạn số token đầu ra, nên đặt giới hạn phù hợp với nhiệm vụ. Cần lưu ý rằng giới hạn quá thấp có thể khiến câu trả lời bị cắt hoặc thiếu dữ kiện cần thiết.
4.2. Ưu tiên cấu trúc đầu ra rõ ràng
Đối với tác vụ máy cần xử lý kết quả tiếp theo, một cấu trúc JSON ngắn gọn có thể phù hợp hơn một đoạn văn dài. Tuy nhiên, định dạng có cấu trúc chỉ thực sự hữu ích khi schema được thiết kế đủ rõ và dữ liệu trả về được kiểm tra hợp lệ.
5. Kỹ thuật 3 – Lựa chọn model phù hợp
Không phải mọi tác vụ trong một hệ thống AI Agent đều cần model mạnh nhất. Một tác vụ phân loại đơn giản có thể không cần cùng loại model với tác vụ phân tích phức tạp hoặc lập kế hoạch nhiều bước.
5.1. Phân loại tác vụ theo độ phức tạp
| Loại tác vụ | Hướng lựa chọn |
|---|---|
| Phân loại, trích xuất đơn giản | Thử nghiệm model chi phí thấp, đầu ra ngắn. |
| Tóm tắt tài liệu thông thường | Chọn model cân bằng giữa chất lượng, chi phí và độ trễ. |
| Lập kế hoạch nhiều bước | Đánh giá model có khả năng suy luận phù hợp với bài toán. |
| Tác vụ rủi ro cao hoặc phức tạp | Ưu tiên chất lượng, độ tin cậy và quy trình kiểm soát phù hợp. |
Đây là hướng phân loại để thử nghiệm, không phải quy tắc cố định cho mọi ứng dụng. Model rẻ hơn chưa chắc tiết kiệm hơn nếu nó thường xuyên trả lời sai, cần nhiều lần thử lại hoặc làm phát sinh chi phí kiểm tra bổ sung.
5.2. Sử dụng mô hình theo nhiều cấp độ
Một kiến trúc có thể sử dụng model nhỏ hơn cho bước phân loại ban đầu và chỉ chuyển sang model mạnh hơn khi nhiệm vụ thực sự cần. Ví dụ, một yêu cầu phân loại đơn giản có thể được xử lý ở cấp độ đầu tiên, trong khi một yêu cầu phân tích nhiều bước sẽ được chuyển sang workflow chuyên sâu hơn.
Điều quan trọng là phải xác định tiêu chí chuyển cấp rõ ràng và kiểm thử độ chính xác. Không nên chỉ dựa vào độ dài câu hỏi để quyết định một tác vụ có phức tạp hay không.
6. Kỹ thuật 4 – Prompt Caching và tái sử dụng kết quả
Trong nhiều ứng dụng, một phần prompt được sử dụng lặp lại giữa các yêu cầu. Ví dụ, system prompt, hướng dẫn nghiệp vụ, ví dụ mẫu và định nghĩa công cụ có thể không thay đổi trong nhiều lượt gọi.
Prompt caching cho phép một số API tái sử dụng phần đầu vào phù hợp đã được xử lý trước đó. Với các model và API được hỗ trợ, cơ chế này có thể giảm chi phí cho phần input được cache và giảm thời gian xử lý. Điều kiện cache, thời gian lưu và mức giá phụ thuộc nhà cung cấp cũng như model.
Tham khảo: OpenAI – Prompt Caching.
6.1. Giữ phần prompt ổn định
Để tăng khả năng tái sử dụng cache, hãy giữ phần hướng dẫn và nội dung ổn định ở đầu prompt, sau đó mới đưa nội dung riêng của từng yêu cầu vào phần sau. Những thay đổi không cần thiết ở phần đầu có thể khiến một đoạn prompt không còn khớp với cache hiện có.
Không nên mặc định rằng chỉ cần gửi lại cùng một cuộc hội thoại là chắc chắn có cache hit. Hãy kiểm tra số token được cache và chi phí thực tế từ dữ liệu usage của API.
6.2. Phân biệt Prompt Caching và Application Cache
Prompt caching và application cache giải quyết những vấn đề khác nhau:
- Prompt caching: tái sử dụng phần xử lý đầu vào được hỗ trợ bởi API của nhà cung cấp.
- Application cache: lưu kết quả của một tác vụ để ứng dụng có thể sử dụng lại khi gặp yêu cầu tương đương.
Ví dụ, nếu hệ thống đã tính tổng doanh thu của một file dữ liệu không thay đổi, ứng dụng có thể lưu kết quả phép tính và không thực hiện lại thao tác đó. Nếu kết quả được dùng để trả lời người dùng, hệ thống vẫn cần kiểm tra ngữ cảnh và điều kiện để bảo đảm kết quả còn phù hợp.
6.3. Xây dựng application cache đơn giản bằng Python
cache = {}

def get_or_compute(key, function):
    if key in cache:
        return cache[key], True

    result = function()
    cache[key] = result
    return result, False

def calculate_revenue():
    return sum([100, 200, 300])

result, cache_hit = get_or_compute(
    "revenue_report_v1",
    calculate_revenue
)

print("Result:", result)
print("Cache hit:", cache_hit)

result, cache_hit = get_or_compute(
    "revenue_report_v1",
    calculate_revenue
)

print("Result:", result)
print("Cache hit:", cache_hit)
Lần gọi đầu tiên thực hiện phép tính và lưu kết quả. Lần gọi thứ hai sử dụng giá trị đã lưu nên không thực hiện lại hàm tính toán.
Đây là ví dụ tối giản với dictionary trong RAM. Dữ liệu sẽ mất khi chương trình kết thúc và chương trình chưa tự kiểm tra dữ liệu nguồn có thay đổi hay không.
Khi triển khai thực tế, cache key nên phản ánh các yếu tố ảnh hưởng đến kết quả, chẳng hạn phiên bản dữ liệu, tham số truy vấn hoặc phiên bản thuật toán. Nếu bỏ qua những yếu tố này, ứng dụng có thể trả về kết quả cũ không còn chính xác.
7. Kỹ thuật 5 – Giảm số lần gọi LLM và tool calls
Một Agent có thể gọi mô hình nhiều lần để lập kế hoạch, lựa chọn công cụ, đọc kết quả và tạo câu trả lời cuối cùng. Không phải bước nào cũng có thể loại bỏ, nhưng cần kiểm tra xem từng lần gọi có đóng góp thực sự vào kết quả hay không.
7.1. Không sử dụng LLM cho mọi thao tác
Các phép toán xác định như cộng số, lọc dữ liệu theo điều kiện, đếm bản ghi hoặc chuyển đổi định dạng thường có thể được thực hiện trực tiếp bằng Python hoặc SQL.
Thay vì yêu cầu LLM đọc hàng nghìn dòng dữ liệu rồi tự tính tổng, ứng dụng có thể dùng Python để tính toán và chỉ gửi bảng tổng hợp cho mô hình diễn giải.
7.2. Tránh lặp lại những bước đã hoàn thành
Agent nên lưu trạng thái của nhiệm vụ, kết quả công cụ và những bước đã thực hiện. Khi một bước không thay đổi đầu vào và có thể tái sử dụng kết quả, hệ thống có thể tránh thực hiện lại thao tác đó.
Với các thao tác có tác động bên ngoài như gửi email hoặc cập nhật dữ liệu, cần thiết kế cơ chế chống thực hiện trùng lặp. Không nên tự động thử lại một thao tác không an toàn nếu chưa xác định được lần thực hiện trước đã thành công hay chưa.
7.3. Giới hạn vòng lặp Agent
Một Agent có thể tiếp tục gọi công cụ nếu không tìm được kết quả mong muốn. Hệ thống cần có giới hạn số bước, điều kiện dừng và cách xử lý khi vượt giới hạn.
max_steps = 5
step = 0
task_completed = False

while step < max_steps and not task_completed:
    step += 1

    print("Executing step:", step)

    # Thực hiện một bước xử lý của Agent.
    # Cập nhật task_completed khi nhiệm vụ hoàn tất.

if not task_completed:
    print("Task stopped: maximum steps reached")
Đoạn code trên chỉ minh họa điều kiện dừng. Trong ứng dụng thực tế, cần bổ sung logic thực hiện nhiệm vụ, xử lý lỗi và đánh giá điều kiện hoàn thành. Giới hạn số bước giúp kiểm soát mức tiêu thụ tài nguyên nhưng không thay thế việc thiết kế workflow hợp lý.
8. Xây dựng công cụ ước tính chi phí LLM bằng Python
Để theo dõi hiệu quả tối ưu, bạn có thể xây dựng một hàm tính chi phí dựa trên số token đầu vào, số token đầu ra và bảng giá của model.
def calculate_cost(input_tokens, output_tokens,
                   input_price, output_price):
    input_cost = input_tokens * input_price / 1000000
    output_cost = output_tokens * output_price / 1000000

    return input_cost + output_cost

input_tokens = 10000
output_tokens = 2000

input_price = 1.0
output_price = 5.0

total_cost = calculate_cost(
    input_tokens,
    output_tokens,
    input_price,
    output_price
)

print("Estimated cost:", round(total_cost, 6), "USD")
Trong ví dụ này, giá đầu vào là 1 USD và giá đầu ra là 5 USD cho mỗi một triệu token. Đây chỉ là dữ liệu giả định để minh họa cách tính toán.
8.1. Tính chi phí cho nhiều lần gọi
Với workflow nhiều bước, có thể cộng chi phí của từng lần gọi để ước tính chi phí toàn bộ nhiệm vụ.
calls = [
    {"input": 2000, "output": 300},
    {"input": 3000, "output": 500},
    {"input": 1000, "output": 700}
]

input_price = 1.0
output_price = 5.0

total_cost = 0

for call in calls:
    cost = calculate_cost(
        call["input"],
        call["output"],
        input_price,
        output_price
    )
    total_cost += cost

print("Workflow cost:", round(total_cost, 6), "USD")
Trong ứng dụng thực tế, dữ liệu token nên được lấy từ trường usage do API trả về khi có sẵn. Cần phân biệt token đầu vào thông thường, token đầu vào được cache và token đầu ra nếu nhà cung cấp áp dụng mức giá riêng.
Tham khảo bảng giá hiện hành: OpenAI API Pricing.
9. Đo lường hiệu quả tối ưu chi phí
Giảm chi phí chỉ có ý nghĩa khi vẫn duy trì được chất lượng đầu ra. Vì vậy, mỗi thay đổi nên được đánh giá bằng dữ liệu trước và sau tối ưu.
| Chỉ số | Mục đích |
|---|---|
| Cost per task | Chi phí trung bình để hoàn thành một nhiệm vụ. |
| Input tokens per task | Đánh giá hiệu quả quản lý context và prompt. |
| LLM calls per task | Phát hiện workflow có quá nhiều lượt gọi. |
| Task success rate | Kiểm tra tỷ lệ nhiệm vụ hoàn thành theo tiêu chí xác định. |
| Latency | Đánh giá ảnh hưởng đến thời gian phản hồi. |
| Cache hit rate | Đánh giá mức độ tái sử dụng cache khi có hỗ trợ. |
Một kỹ thuật tối ưu có thể làm giảm token nhưng đồng thời khiến Agent trả lời thiếu thông tin hoặc phải thử lại nhiều lần. Vì vậy, cần theo dõi cả chi phí, độ chính xác và độ trễ thay vì chỉ tập trung vào một chỉ số.
10. Lộ trình tối ưu chi phí AI Agent
- Bước 1 – Đo lường hiện trạng: Ghi nhận số lượt gọi LLM, token usage, thời gian xử lý và chi phí mỗi nhiệm vụ.
- Bước 2 – Loại bỏ lãng phí: Rút gọn prompt, giảm dữ liệu trùng lặp và giới hạn độ dài đầu ra.
- Bước 3 – Tối ưu workflow: Dùng Python hoặc SQL cho các thao tác xác định, hạn chế gọi LLM không cần thiết.
- Bước 4 – Tái sử dụng kết quả: Áp dụng caching phù hợp cho prompt hoặc kết quả có thể tái sử dụng an toàn.
- Bước 5 – Chọn model theo tác vụ: Thử nghiệm các lựa chọn khác nhau và đo cả chi phí lẫn chất lượng.
- Bước 6 – Thiết lập giới hạn: Kiểm soát số bước, retry và ngân sách sử dụng theo yêu cầu ứng dụng.
- Bước 7 – Đánh giá định kỳ: So sánh hiệu quả trước và sau tối ưu, đồng thời kiểm tra chất lượng đầu ra.
11. Kết luận
AI Agent Cost Optimization là sự kết hợp giữa quản lý token, thiết kế workflow, lựa chọn model và kiểm soát cách sử dụng công cụ. Thay vì chỉ chuyển sang một model rẻ hơn, nhà phát triển nên xác định những bước thực sự cần LLM, hạn chế dữ liệu dư thừa và tái sử dụng kết quả khi phù hợp.
Bắt đầu bằng việc đo chi phí trên từng tác vụ, sau đó áp dụng từng kỹ thuật và kiểm tra lại chất lượng. Cách tiếp cận dựa trên dữ liệu giúp bạn xác định giải pháp nào thực sự hiệu quả, thay vì tối ưu theo cảm tính.
Nếu bạn muốn phát triển nền tảng Python, tư duy dữ liệu và khả năng ứng dụng AI vào các bài toán thực tế, hãy tham khảo các chương trình đào tạo tại MCNA Technology School.


