Trong kỷ nguyên số, vận hành tự động hóa đòi hỏi độ chính xác cao. Dù vậy, các hệ thống AI Automation thường gặp khó khăn với các sự cố hy hữu.
Nếu thiếu chuẩn bị, doanh nghiệp dễ rủi ro khi triển khai thực tế. Lúc này, dữ liệu giả lập trong AI automation là giải pháp tối ưu giúp kiểm thử hệ thống an toàn.
1. Dữ liệu giả lập trong AI Automation là gì?
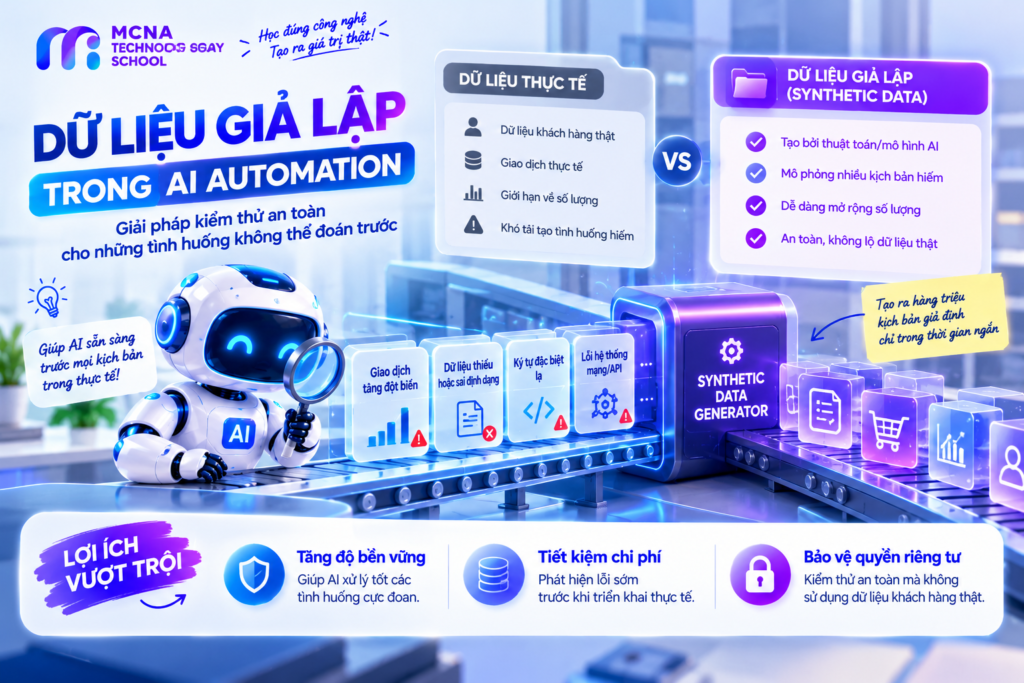
Dữ liệu giả lập (Synthetic Data) là tập dữ liệu tạo ra bởi thuật toán hoặc mô hình máy học. Thay vì lấy từ thực tế, loại dữ liệu này mô phỏng các biến số hay giao dịch.
Trong nền tảng tự động hóa, kỹ sư dùng dữ liệu này để kiểm tra phản ứng của AI. Nhờ đó, hệ thống làm quen với hàng triệu kịch bản giả định trong thời gian ngắn.
2. Thách thức từ các tình huống hiếm trong thực tế
Khi vận hành, hệ thống AI có thể gặp những tình huống rất hy hữu nhưng gây hậu quả lớn. Các ví dụ tiêu biểu gồm:
-
Lỗi dồn ứ hàng nghìn giao dịch thanh toán cùng một thời điểm.
-
Dữ liệu đầu vào thiếu sót hoặc chứa ký tự đặc biệt lạ.
-
Lưu lượng truy cập mạng lưới API sụt giảm hoặc tăng vọt đột ngột.
Nếu chỉ dựa vào dữ liệu cũ, AI sẽ không bao giờ nhận diện được các trường hợp này. Hệ thống sẽ dễ lúng túng khi gặp sự cố thật ngoài đời.
3. Lợi ích vượt trội khi kiểm thử bằng dữ liệu giả lập
Việc tạo ra các tình huống giả định mang lại nhiều giá trị cho doanh nghiệp và đội ngũ phát triển:
-
Tăng độ bền vững: Giúp mô hình AI xử lý mượt mà các tập dữ liệu cực đoan.
-
Tiết kiệm chi phí: Phát hiện lỗi sớm từ giai đoạn thiết kế hệ thống.
-
Bảo vệ quyền riêng tư: Tránh rò rỉ dữ liệu nhạy cảm của khách hàng thật.
4. Kết luận
Tóm lại, dữ liệu giả lập trong AI automation là công cụ cốt lõi giúp nâng cao độ tin cậy công nghệ. Việc thử nghiệm trước các tình huống hiếm giúp doanh nghiệp loại bỏ rủi ro.
Bạn muốn làm chủ các kỹ thuật tự động hóa tiên tiến này? Hãy tham gia ngay các khóa học chuyên sâu tại MCNA Technology School hôm nay!
Tác giả: Đàm Thị Thu Hiền – Marketer tại MCNA Technology School