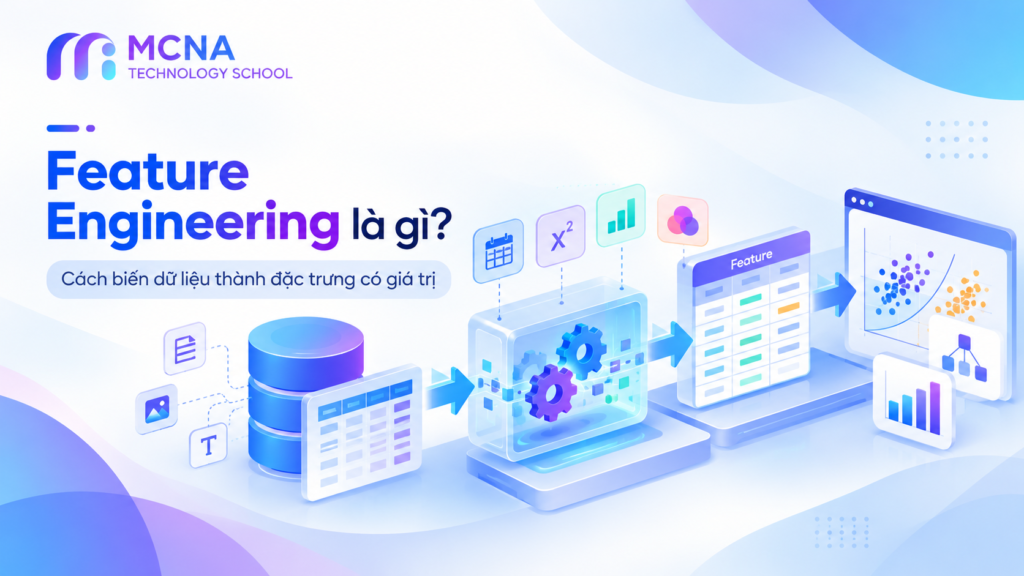
Trong Machine Learning, dữ liệu thô không phải lúc nào cũng thể hiện trực tiếp những quy luật mà mô hình cần học. Một bảng dữ liệu có thể chứa ngày giao dịch, số lần mua hàng, doanh thu hoặc thông tin khách hàng, nhưng các cột ban đầu chưa chắc đã biểu diễn tốt mối quan hệ cần dự đoán. Feature Engineering là quá trình xây dựng, biến đổi và tổ chức các đặc trưng để dữ liệu thể hiện thông tin hữu ích hơn cho mô hình.
Ví dụ, thay vì chỉ sử dụng tổng số tiền khách hàng đã chi tiêu, ta có thể tạo thêm đặc trưng chi tiêu trung bình mỗi đơn hàng, số ngày kể từ lần mua gần nhất hoặc tỷ lệ đơn hàng bị hủy. Những đặc trưng này có thể giúp mô hình nhận diện hành vi khách hàng rõ hơn, tùy thuộc vào mục tiêu và chất lượng dữ liệu.
Bài viết này trình bày bản chất của Feature Engineering, các kỹ thuật phổ biến và cách triển khai bằng Python. Để hiểu rõ hơn mối liên hệ giữa dữ liệu đầu vào và đặc trưng, bạn có thể đọc thêm bài Dữ liệu trong Machine Learning: Dataset, Feature, Label và Train/Test và bài Tiền xử lý dữ liệu cho Machine Learning.
1. Feature Engineering là gì?
Feature Engineering (kỹ thuật đặc trưng) là quá trình sử dụng kiến thức về dữ liệu, lĩnh vực nghiệp vụ và bài toán để tạo mới, biến đổi hoặc lựa chọn các Feature phù hợp cho mô hình Machine Learning.
Để hiểu bản chất, hãy phân biệt hai thành phần:
- Raw Data: dữ liệu được thu thập từ hệ thống, bảng tính, cảm biến, giao dịch hoặc nguồn khác.
- Feature: cách biểu diễn thông tin từ dữ liệu để mô hình có thể sử dụng trong quá trình học và dự đoán.
Feature Engineering không đơn thuần là thêm cột vào Dataset. Một đặc trưng có giá trị cần biểu diễn thông tin liên quan đến mục tiêu, được tính toán đúng và có thể tạo ra từ dữ liệu thực sự sẵn có tại thời điểm dự đoán.
Ví dụ: Dự đoán khách hàng có rời bỏ dịch vụ hay không
Giả sử doanh nghiệp có dữ liệu khách hàng với các cột sau:
| Khách hàng | Số đơn hàng | Tổng chi tiêu | Ngày mua gần nhất |
|---|---|---|---|
| A | 10 | 5.000.000 | 5 ngày trước |
| B | 2 | 4.000.000 | 90 ngày trước |
Nếu chỉ nhìn vào tổng chi tiêu, khách hàng B có vẻ có giá trị cao hơn trên mỗi đơn hàng. Nhưng B đã lâu không mua hàng, trong khi A vẫn giao dịch gần đây. Tùy cách định nghĩa mục tiêu rời bỏ dịch vụ, thông tin về mức độ gần đây của giao dịch có thể rất hữu ích.
Ta có thể tạo thêm các Feature:
| Feature mới | Cách tính | Ý nghĩa |
|---|---|---|
| Average Order Value | Tổng chi tiêu / Số đơn hàng | Giá trị trung bình mỗi đơn |
| Recency | Ngày dự đoán − Ngày mua gần nhất | Khoảng thời gian từ lần mua gần nhất |
| Purchase Frequency | Số đơn hàng / Khoảng thời gian quan sát | Tần suất mua hàng |
Các đặc trưng mới không bảo đảm mô hình sẽ dự đoán chính xác hơn. Chúng tạo ra những cách biểu diễn thông tin có thể phù hợp hơn với bài toán; hiệu quả cần được kiểm chứng bằng thực nghiệm.
2. Feature Engineering khác gì Data Preprocessing?
Feature Engineering và Data Preprocessing có liên quan chặt chẽ nhưng không hoàn toàn giống nhau. Data Preprocessing tập trung vào việc làm cho dữ liệu đủ sạch, nhất quán và phù hợp với thuật toán. Feature Engineering tập trung vào việc biểu diễn dữ liệu sao cho làm nổi bật thông tin có ích cho nhiệm vụ học.
| Tiêu chí | Data Preprocessing | Feature Engineering |
|---|---|---|
| Mục tiêu | Xử lý vấn đề chất lượng và định dạng dữ liệu | Tạo hoặc cải thiện cách biểu diễn thông tin |
| Ví dụ | Xử lý Missing Values, sửa kiểu dữ liệu, Encoding | Tạo tỷ lệ chi tiêu, trích xuất ngày trong tuần, tạo tương tác giữa các biến |
| Câu hỏi chính | Dữ liệu đã phù hợp để sử dụng chưa? | Thông tin nào giúp mô hình học quy luật tốt hơn? |
Ranh giới giữa hai nhóm không tuyệt đối. Encoding và Scaling có thể được xem là các phép biến đổi thuộc cả quy trình preprocessing lẫn Feature Engineering theo cách phân loại của từng dự án. Điều quan trọng là hiểu mục tiêu của từng bước thay vì quá chú trọng tên gọi.
Nếu muốn tìm hiểu sâu hơn về làm sạch, mã hóa và chuẩn hóa dữ liệu, hãy xem bài Tiền xử lý dữ liệu cho Machine Learning: Làm sạch, mã hóa và chuẩn hóa.
3. Các nhóm kỹ thuật Feature Engineering phổ biến
3.1. Tạo đặc trưng mới từ các cột hiện có
Đây là cách kết hợp hoặc tính toán lại những thông tin đã có để tạo ra đặc trưng có ý nghĩa hơn.
Ví dụ trong dữ liệu bán hàng:
- Average Order Value: doanh thu chia cho số đơn hàng hợp lệ.
- Profit Margin: lợi nhuận chia cho doanh thu, khi các giá trị có định nghĩa nhất quán.
- Return Rate: số đơn hoàn trả chia cho số đơn phù hợp trong cùng kỳ.
- Debt-to-Income Ratio: nghĩa vụ nợ chia cho thu nhập, nếu dữ liệu và định nghĩa nghiệp vụ cho phép.
Đặc trưng tỷ lệ có thể giúp so sánh các đối tượng có quy mô khác nhau. Chẳng hạn, tổng doanh thu thường có xu hướng lớn hơn ở doanh nghiệp có nhiều giao dịch; doanh thu trung bình trên mỗi đơn hàng cung cấp một góc nhìn khác về hành vi mua sắm.
Cần kiểm tra trường hợp mẫu số bằng 0 hoặc không có dữ liệu. Không nên tự động thay các trường hợp này bằng một giá trị tùy ý nếu chưa xác định được ý nghĩa nghiệp vụ.
3.2. Trích xuất đặc trưng từ ngày và thời gian
Ngày tháng thường chứa nhiều thông tin mà một giá trị ngày đơn lẻ không thể thể hiện trực tiếp. Từ cột thời gian, có thể tạo các Feature như năm, tháng, ngày trong tuần, giờ giao dịch, cuối tuần hoặc số ngày kể từ sự kiện gần nhất.
| Dữ liệu gốc | Feature có thể tạo | Ứng dụng |
|---|---|---|
| Ngày đặt hàng | Tháng, quý, thứ trong tuần | Phân tích mùa vụ và nhu cầu |
| Thời điểm truy cập | Giờ, khung giờ, ngày cuối tuần | Dự đoán lưu lượng truy cập |
| Ngày mua gần nhất | Recency | Phân nhóm và phân tích hành vi khách hàng |
| Thời điểm bắt đầu và kết thúc | Duration | Phân tích thời gian xử lý hoặc sử dụng dịch vụ |
import pandas as pd

df = pd.DataFrame({
    "order_date": [
        "2026-01-05",
        "2026-02-14",
        "2026-03-22"
    ]
})

df["order_date"] = pd.to_datetime(df["order_date"])

df["order_year"] = df["order_date"].dt.year
df["order_month"] = df["order_date"].dt.month
df["order_dayofweek"] = df["order_date"].dt.dayofweek
df["is_weekend"] = (
    df["order_dayofweek"] >= 5
).astype(int)

print(df)
Trong pandas, dayofweek thường biểu diễn thứ Hai bằng 0 và Chủ nhật bằng 6. Nếu dùng dữ liệu theo thời gian, cần kiểm tra múi giờ, thời điểm ghi nhận và thời điểm dự đoán. Những thông tin chỉ xuất hiện sau sự kiện cần dự đoán không được đưa vào Feature.
3.3. Biến đổi đặc trưng số
Đặc trưng số có thể có phân phối lệch, phạm vi giá trị lớn hoặc mối quan hệ phi tuyến với mục tiêu. Trong các trường hợp phù hợp, ta có thể biến đổi dữ liệu để mô hình biểu diễn mối quan hệ dễ hơn.
- Log Transformation: có thể giảm độ lệch phải của dữ liệu dương và làm giảm ảnh hưởng của những giá trị rất lớn.
- Binning: chia dữ liệu liên tục thành các khoảng, chẳng hạn nhóm tuổi hoặc nhóm chi tiêu.
- Polynomial Features: tạo các lũy thừa như \(x^2\), \(x^3\) để mô hình tuyến tính có thể biểu diễn quan hệ phi tuyến.
- Clipping: giới hạn giá trị theo ngưỡng đã xác định khi có cơ sở nghiệp vụ hoặc thống kê.
Ví dụ, với doanh thu có nhiều giá trị lớn, phép biến đổi log1p(x) tính logarit của \(1+x\) có thể hữu ích nếu doanh thu không âm. Phép biến đổi này thay đổi cách biểu diễn chênh lệch giữa các giá trị; vì vậy, cần đánh giá xem nó có phù hợp với bài toán hay không.
import numpy as np
from sklearn.preprocessing import PolynomialFeatures

# Log transformation cho dữ liệu không âm
df["log_revenue"] = np.log1p(df["revenue"])

# Tạo đặc trưng bậc hai và tương tác từ các biến số
poly = PolynomialFeatures(
    degree=2,
    include_bias=False
)

X_poly = poly.fit_transform(
    df[["advertising_cost", "price"]]
)
Polynomial Features có thể làm số lượng cột tăng nhanh khi số đặc trưng đầu vào hoặc bậc đa thức tăng. Nếu tạo quá nhiều đặc trưng, mô hình có thể phức tạp hơn, tốn tài nguyên và dễ Overfitting.
3.4. Tạo đặc trưng tương tác (Interaction Features)
Đôi khi tác động của một biến phụ thuộc vào giá trị của biến khác. Interaction Feature biểu diễn mối quan hệ kết hợp đó.
Ví dụ, hiệu quả quảng cáo có thể phụ thuộc vào cả ngân sách và kênh quảng cáo. Một mô hình chỉ nhìn vào ngân sách có thể bỏ qua sự khác biệt giữa các kênh. Ta có thể tạo đặc trưng kết hợp giữa ngân sách và từng kênh để mô hình thể hiện những khác biệt này.
Trong hồi quy, tích của hai biến số như advertising_cost * price là một ví dụ về tương tác. Với biến phân loại, có thể kết hợp các danh mục như khu vực và nhóm sản phẩm. Tuy nhiên, các tương tác chỉ nên được tạo khi có cơ sở hợp lý và đủ dữ liệu để ước lượng.
3.5. Feature Engineering cho dữ liệu phân loại
Với dữ liệu phân loại, ngoài các cách Encoding cơ bản, có thể tạo nhóm danh mục hoặc kết hợp các biến để biểu diễn thông tin nghiệp vụ.
Ví dụ, từ product_category và customer_segment, có thể tạo đặc trưng kết hợp để phân biệt các nhóm khách hàng mua từng loại sản phẩm. Tuy nhiên, nếu hai cột có nhiều giá trị, số lượng tổ hợp có thể rất lớn và nhiều tổ hợp có ít quan sát.
Target Encoding là một kỹ thuật thay mỗi danh mục bằng thống kê liên quan đến biến mục tiêu. Phương pháp này có thể hữu ích khi số lượng danh mục lớn, nhưng cần thực hiện đúng trong Cross-Validation hoặc bằng phương pháp out-of-fold để tránh Data Leakage. Không nên tính thống kê mục tiêu trên toàn bộ dữ liệu rồi dùng trực tiếp cho chính các mẫu đó trong quá trình huấn luyện.
3.6. Feature Engineering cho văn bản
Văn bản thường không thể đưa trực tiếp vào nhiều mô hình Machine Learning truyền thống dưới dạng chuỗi ký tự. Ta cần chuyển nội dung thành biểu diễn có thể xử lý.
- Bag of Words: biểu diễn văn bản bằng tần suất xuất hiện của từ hoặc token.
- TF-IDF: điều chỉnh trọng số từ dựa trên tần suất trong văn bản và mức độ phổ biến trong tập tài liệu.
- N-grams: biểu diễn các chuỗi gồm nhiều token liên tiếp để giữ một phần ngữ cảnh cục bộ.
- Embeddings: biểu diễn văn bản bằng vector số nhằm nắm bắt các quan hệ ngữ nghĩa theo cách học được từ dữ liệu.
Ví dụ, khi phân loại đánh giá sản phẩm thành tích cực hoặc tiêu cực, các từ và cụm từ trong nội dung đánh giá có thể cung cấp thông tin dự đoán. Cách biểu diễn phù hợp phụ thuộc vào kích thước dữ liệu, ngôn ngữ, mô hình và yêu cầu triển khai.
3.7. Feature Engineering cho dữ liệu chuỗi thời gian
Với Time Series, giá trị quá khứ và cấu trúc thời gian thường chứa thông tin quan trọng. Một số đặc trưng thường dùng gồm:
- Lag Features: giá trị tại các thời điểm trước đó, ví dụ doanh thu tuần trước.
- Rolling Statistics: trung bình, tổng hoặc độ lệch chuẩn trong cửa sổ thời gian trước đó.
- Calendar Features: tháng, quý, ngày trong tuần và ngày lễ nếu có dữ liệu phù hợp.
- Change Features: mức thay đổi hoặc tỷ lệ thay đổi so với kỳ trước.
# Ví dụ với dữ liệu doanh thu theo ngày
df = df.sort_values("date").copy()

df["revenue_lag_1"] = df["revenue"].shift(1)

df["revenue_rolling_mean_7"] = (
    df["revenue"]
      .shift(1)
      .rolling(window=7)
      .mean()
)
Ở ví dụ này, shift(1) giúp cửa sổ trung bình không sử dụng doanh thu của chính ngày đang được dự đoán. Với bài toán dự báo nhiều bước hoặc dự báo theo thời điểm cụ thể, cần xác định rõ thời điểm chốt dữ liệu và xây dựng đặc trưng chỉ từ thông tin có sẵn tại thời điểm đó.
4. Feature Selection và Feature Extraction khác gì Feature Engineering?
Ba khái niệm này có liên quan nhưng nhấn mạnh các mục tiêu khác nhau.
| Khái niệm | Mục tiêu | Ví dụ |
|---|---|---|
| Feature Engineering | Tạo, biến đổi hoặc thiết kế đặc trưng | Tạo chi tiêu trung bình mỗi đơn hàng |
| Feature Selection | Chọn một tập con các đặc trưng hiện có | Loại bỏ cột dư thừa hoặc ít hữu ích |
| Feature Extraction | Biến đổi dữ liệu thành một biểu diễn đặc trưng mới | PCA chuyển các biến số thành các thành phần chính |
4.1. Feature Selection
Không phải mọi Feature đều có ích. Một cột có thể chứa thông tin trùng lặp, ít biến thiên, nhiễu hoặc không liên quan đến mục tiêu. Feature Selection giúp chọn các đặc trưng phù hợp hơn, giảm độ phức tạp và đôi khi cải thiện khả năng tổng quát hóa.
Một số phương pháp gồm:
- Filter Methods: dùng các tiêu chí thống kê để đánh giá đặc trưng, chẳng hạn tương quan hoặc kiểm định phù hợp với loại dữ liệu.
- Wrapper Methods: đánh giá các tập đặc trưng bằng cách huấn luyện và so sánh mô hình.
- Embedded Methods: lựa chọn đặc trưng trong quá trình huấn luyện, ví dụ một số mô hình có regularization hoặc cơ chế đánh giá mức độ quan trọng.
Việc chọn đặc trưng cần thực hiện bên trong quy trình huấn luyện hoặc Cross-Validation, không được sử dụng kết quả từ tập Test để quyết định đặc trưng rồi tiếp tục báo cáo hiệu quả trên chính tập Test đó.
4.2. Feature Extraction
Feature Extraction chuyển dữ liệu từ dạng ban đầu sang một không gian biểu diễn khác. Ví dụ, Principal Component Analysis (PCA) tạo ra các thành phần chính từ những tổ hợp tuyến tính của các đặc trưng số ban đầu.
Khác với Feature Selection, PCA không chỉ chọn một số cột ban đầu mà tạo ra các biến mới. Việc giảm chiều có thể giúp giảm số lượng biến và biểu diễn phần biến thiên của dữ liệu theo cách cô đọng hơn, nhưng các thành phần mới thường khó diễn giải trực tiếp theo ý nghĩa nghiệp vụ.
5. Feature Engineering ảnh hưởng đến mô hình như thế nào?
Mô hình học từ cách dữ liệu được biểu diễn. Nếu Feature không thể hiện rõ mối quan hệ liên quan đến mục tiêu, mô hình có thể cần cấu trúc phức tạp hơn để tìm ra quy luật. Đặc trưng được thiết kế hợp lý đôi khi giúp mô hình đơn giản học hiệu quả hơn.
Ví dụ, một mô hình hồi quy tuyến tính chỉ sử dụng tuổi để dự đoán chi tiêu sẽ học mối quan hệ tuyến tính theo tuổi. Nếu hành vi chi tiêu thay đổi theo một dạng cong, việc bổ sung đặc trưng tuổi bình phương có thể giúp mô hình biểu diễn quan hệ đó.
Tuy nhiên, thêm nhiều Feature không đồng nghĩa với kết quả tốt hơn. Đặc trưng không phù hợp có thể làm tăng nhiễu, tạo tương quan giả hoặc khiến mô hình Overfitting. Vì vậy, mỗi thay đổi cần được kiểm tra bằng một quy trình đánh giá đáng tin cậy.
6. Quy trình Feature Engineering trong một dự án Machine Learning
Dữ liệu thô
    |
    v
Hiểu bài toán và xác định thời điểm dự đoán
    |
    v
Khám phá dữ liệu và hiểu ý nghĩa các cột
    |
    v
Đề xuất Feature dựa trên dữ liệu và kiến thức nghiệp vụ
    |
    v
Chia Train / Validation / Test phù hợp
    |
    v
Tạo và biến đổi Feature trong quy trình huấn luyện
    |
    v
Đánh giá bằng Cross-Validation hoặc Validation
    |
    v
Chọn phương án phù hợp
    |
    v
Đánh giá cuối cùng trên Test
    |
    v
Triển khai cùng một quy trình tạo Feature
Thứ tự cụ thể có thể thay đổi tùy bài toán. Điểm cần giữ vững là các bước học tham số từ dữ liệu, lựa chọn Feature và điều chỉnh mô hình phải tránh sử dụng thông tin của tập Test. Với dữ liệu thời gian, cần chia dữ liệu theo trình tự thời gian thay vì mặc định xáo trộn ngẫu nhiên.
7. Ví dụ thực hành Feature Engineering bằng Python
Giả sử bạn muốn dự đoán khách hàng có mua lại sản phẩm hay không. Dữ liệu gồm số đơn hàng, tổng chi tiêu và ngày mua gần nhất. Ta tạo các đặc trưng tổng hợp từ những cột này.
import pandas as pd

df = pd.DataFrame({
    "customer_id": ["A", "B", "C"],
    "order_count": [10, 2, 5],
    "total_spend": [5_000_000, 4_000_000, 2_500_000],
    "days_since_last_order": [5, 90, 30]
})

# Giá trị trung bình mỗi đơn hàng
df["average_order_value"] = (
    df["total_spend"] / df["order_count"].replace(0, float("nan"))
)

# Nhóm khoảng thời gian từ lần mua gần nhất
df["recency_group"] = pd.cut(
    df["days_since_last_order"],
    bins=[-1, 7, 30, 90, float("inf")],
    labels=["0-7 ngày", "8-30 ngày", "31-90 ngày", "Trên 90 ngày"]
)

print(df)
Trong ví dụ này, average_order_value biểu diễn mức chi tiêu trung bình trên mỗi đơn, còn recency_group chuyển khoảng thời gian liên tục thành các nhóm dễ diễn giải. Cần lưu ý rằng nhóm hóa làm mất một phần thông tin chi tiết: hai khách hàng có số ngày khác nhau nhưng cùng nhóm sẽ có giá trị danh mục giống nhau.
Đây mới là bước tạo Feature, chưa phải toàn bộ mô hình dự đoán. Trong dự án thực tế, cần xác định rõ thời điểm dự đoán, kỳ quan sát, cách xây dựng nhãn mua lại và đảm bảo mọi đặc trưng đều được tạo từ dữ liệu sẵn có trước thời điểm đó.
8. Data Leakage: lỗi cần tránh khi tạo đặc trưng
Data Leakage xảy ra khi quy trình huấn luyện sử dụng thông tin không nên có tại thời điểm dự đoán hoặc thông tin từ tập đánh giá. Đây là rủi ro đặc biệt quan trọng trong Feature Engineering vì những đặc trưng được tạo ra có thể vô tình chứa thông tin về tương lai hoặc kết quả cần dự đoán.
Ví dụ về Leakage
Giả sử mục tiêu là dự đoán khách hàng có rời bỏ dịch vụ trong tháng tới hay không. Nếu tạo Feature từ trạng thái tài khoản được cập nhật sau khi khách hàng đã rời bỏ, mô hình có thể dựa vào thông tin tương lai để dự đoán một sự kiện lẽ ra chưa xảy ra tại thời điểm dự báo.
Một số nguyên tắc phòng tránh:
- Xác định thời điểm dự đoán trước khi thiết kế Feature.
- Chỉ sử dụng thông tin có thể biết tại thời điểm dự đoán.
- Học các tham số biến đổi từ tập huấn luyện và áp dụng lên dữ liệu khác.
- Thực hiện Feature Selection và Target Encoding bên trong Cross-Validation khi cần.
- Với Time Series, tạo Lag và Rolling Features sao cho không sử dụng giá trị tương lai.
- Kiểm tra khả năng tái tạo cùng một Feature giữa môi trường huấn luyện và triển khai.
9. Những sai lầm phổ biến khi làm Feature Engineering
- Tạo Feature không có mục tiêu rõ ràng: thêm nhiều cột nhưng không giải thích được ý nghĩa hoặc lý do chúng liên quan đến bài toán.
- Nhầm tương quan với quan hệ nhân quả: một đặc trưng có liên hệ với mục tiêu không có nghĩa nó gây ra mục tiêu đó.
- Quên kiểm tra thời điểm dữ liệu: đặc trưng có thể vô tình sử dụng thông tin tương lai.
- Tạo quá nhiều đặc trưng: làm tăng chi phí tính toán và nguy cơ Overfitting.
- Không xử lý trường hợp đặc biệt: phép chia có thể gặp mẫu số bằng 0; ngày tháng có thể sai định dạng; danh mục mới có thể xuất hiện khi triển khai.
- Không lưu quy tắc tạo Feature: dữ liệu huấn luyện và dữ liệu thực tế có thể được xử lý không nhất quán.
- Đánh giá chỉ trên một lần chia dữ liệu: kết quả có thể phụ thuộc vào cách chia; cần phương pháp đánh giá phù hợp với quy mô và cấu trúc dữ liệu.
10. Checklist đánh giá một Feature có giá trị
- Feature có ý nghĩa rõ ràng và gắn với bài toán không?
- Có thể giải thích cách tính và đơn vị đo của Feature không?
- Feature có sẵn tại thời điểm dự đoán không?
- Có xử lý các trường hợp thiếu, ngoại lệ và giá trị không hợp lệ không?
- Feature có trùng lặp thông tin hoặc gây tăng độ phức tạp không cần thiết không?
- Feature có cải thiện kết quả trên Validation hoặc Cross-Validation không?
- Quy trình tạo Feature có thể tái sử dụng nhất quán khi triển khai không?
11. Kết luận
Feature Engineering là cầu nối giữa dữ liệu thô và cách mô hình Machine Learning tiếp nhận thông tin. Thông qua việc tạo đặc trưng mới, trích xuất thông tin từ thời gian và văn bản, biến đổi dữ liệu số hoặc kết hợp các biến, người làm dữ liệu có thể giúp mô hình biểu diễn những quy luật phù hợp hơn với bài toán.
Điều cốt lõi không phải là tạo càng nhiều Feature càng tốt, mà là xây dựng những đặc trưng có ý nghĩa, đúng thời điểm, có thể tái tạo và chứng minh được giá trị qua đánh giá mô hình. Khi kết hợp kiến thức nghiệp vụ với thực nghiệm có kiểm soát, Feature Engineering trở thành một phần quan trọng của quy trình phát triển Machine Learning đáng tin cậy.
12. Tài liệu tham khảo
- Google for Developers: Numerical data and feature vectors – cách biểu diễn dữ liệu thành Feature Vector và các phép biến đổi đặc trưng.
- Google for Developers: Binning – kỹ thuật chia dữ liệu số thành các nhóm.
- Google for Developers: Polynomial transforms – tạo đặc trưng đa thức và biểu diễn quan hệ phi tuyến.
- Scikit-learn: PolynomialFeatures – tài liệu kỹ thuật về đặc trưng đa thức và tương tác.
- Scikit-learn: Feature Selection examples – các ví dụ về lựa chọn đặc trưng.
- Scikit-learn: Feature Extraction – các công cụ trích xuất đặc trưng từ dữ liệu.
13. Học Data, AI và Python cùng MCNA
Nếu bạn muốn xây dựng nền tảng về phân tích dữ liệu, lập trình Python và ứng dụng AI vào công việc, hãy tham khảo các chương trình học tại MCNA Technology School.
- Combo 5 khóa AI & Power BI – tìm hiểu kỹ năng dữ liệu, trực quan hóa và ứng dụng AI.
- Combo Python – củng cố nền tảng lập trình phục vụ phân tích dữ liệu và Machine Learning.
Tác giả
Nguyễn Quốc Hải – Data Analyst tại MCNA Technology School
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp lớn như Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
🌐 Website: mcna.vn
📘 Facebook: facebook.com/mcnatechnologyschool
▶️ YouTube: youtube.com/@mcna.technology.school
💼 LinkedIn: linkedin.com/company/mcna-vn
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B, TT2, Văn Quán, Hà Đông
📍 TP.HCM: The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu