Chunking là gì? Cách chia nhỏ dữ liệu để tối ưu RAG
Đó là lý do Chunking trở thành một bước quan trọng trong nhiều hệ thống Retrieval-Augmented Generation (RAG).
Chunking không đơn giản chỉ là cắt văn bản thành những đoạn có độ dài bằng nhau. Cách chia tài liệu có thể ảnh hưởng đến ý nghĩa của từng đoạn, chất lượng Embedding, kết quả tìm kiếm và lượng thông tin mà LLM nhận được.
1. Chunking là gì?
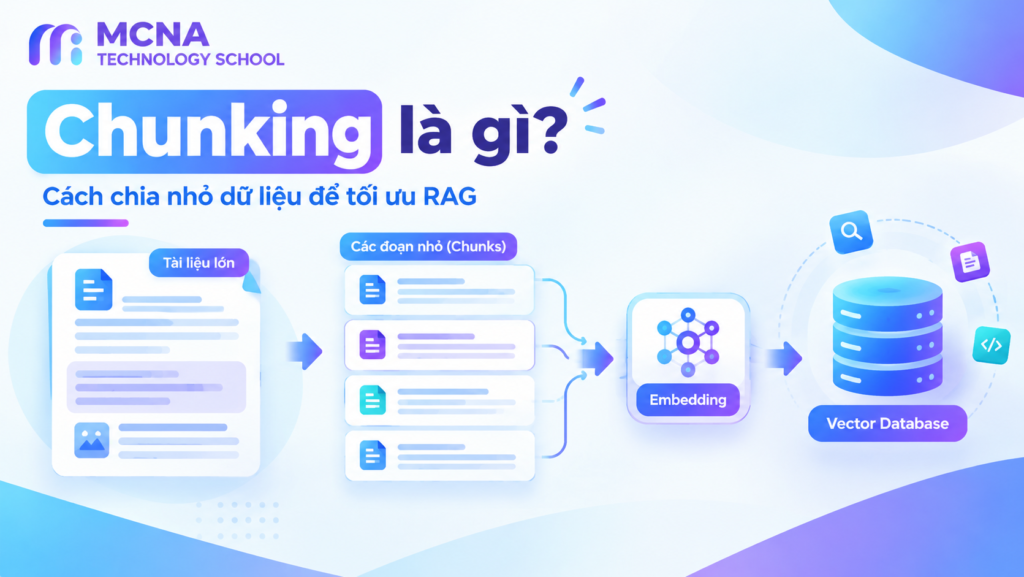
Chunking là quá trình chia một tài liệu lớn thành những đoạn nhỏ hơn, thường được gọi là chunks, để thuận tiện cho việc lưu trữ, xử lý, tìm kiếm và truy xuất thông tin.
Ví dụ, một tài liệu hướng dẫn dài 100 trang có thể được chia thành nhiều đoạn nhỏ. Mỗi đoạn chứa một phần nội dung của tài liệu gốc và có thể được chuyển thành Embedding để phục vụ Semantic Search.
Quy trình cơ bản có thể hình dung như sau:
Document
   |
   v
Document Processing
   |
   v
Chunking
   |
   +------ Chunk 1
   |
   +------ Chunk 2
   |
   +------ Chunk 3
   |
   v
Embedding
   |
   v
Vector Database
Mục tiêu của Chunking là tạo ra những đơn vị thông tin phù hợp với cách hệ thống tìm kiếm và sử dụng dữ liệu.
2. Vì sao Chunking quan trọng trong RAG?
2.1. Tìm kiếm chính xác hơn
Giả sử một tài liệu dài đề cập đến nhiều chủ đề: cài đặt phần mềm, xử lý lỗi, cấu hình hệ thống và bảo mật.
Nếu toàn bộ tài liệu được biểu diễn bằng một Embedding duy nhất, vector đó có thể không thể hiện rõ nội dung cụ thể mà người dùng đang cần tìm.
Ngược lại, nếu tài liệu được chia thành các đoạn hợp lý, hệ thống có thể tìm đúng phần giải thích vấn đề mà người dùng hỏi.
2.2. Giảm lượng context không cần thiết
Trong RAG, những đoạn tài liệu được truy xuất thường được đưa vào context của LLM.
Nếu mỗi đoạn quá dài, hệ thống có thể đưa nhiều thông tin không liên quan vào context. Nếu đoạn quá ngắn, thông tin cần thiết có thể bị tách rời khỏi phần giải thích hoặc điều kiện đi kèm.
Chunking hợp lý giúp cân bằng giữa việc giữ đủ ngữ cảnh và hạn chế thông tin dư thừa.
2.3. Hỗ trợ xử lý tài liệu lớn
Chunking giúp hệ thống tổ chức tài liệu thành những đơn vị nhỏ để xử lý độc lập. Các đoạn này có thể được lập chỉ mục, tạo Embedding và truy xuất theo nhu cầu.
Điều này đặc biệt hữu ích khi xây dựng hệ thống tìm kiếm trên kho tài liệu doanh nghiệp, tài liệu kỹ thuật hoặc cơ sở kiến thức nội bộ.
3. Chunk Size là gì?
Chunk Size là kích thước của một chunk. Tùy hệ thống, kích thước này có thể được đo bằng số ký tự, số từ hoặc số token.
Trong các ứng dụng LLM, token thường là đơn vị đáng quan tâm vì mô hình xử lý đầu vào và đầu ra theo token.
Ví dụ minh họa, một đoạn văn bản có thể được chia theo các cấu hình khác nhau:
| Cấu hình | Đặc điểm | Rủi ro có thể gặp |
|---|---|---|
| Chunk nhỏ | Nội dung tập trung, chi tiết | Dễ mất ngữ cảnh khi chia tách |
| Chunk vừa | Cân bằng giữa chi tiết và ngữ cảnh | Cần thử nghiệm để tìm cấu hình phù hợp |
| Chunk lớn | Giữ được nhiều nội dung liên quan | Có thể chứa nhiều thông tin không cần thiết |
Không tồn tại một Chunk Size tối ưu cho mọi bài toán. Kích thước phù hợp phụ thuộc vào cấu trúc tài liệu, loại câu hỏi, Embedding Model và giới hạn context của LLM.
4. Chunk Overlap là gì?
Chunk Overlap là phần nội dung được lặp lại giữa hai chunk liên tiếp.
Overlap giúp hạn chế việc thông tin quan trọng bị chia cắt ngay tại ranh giới giữa hai đoạn.
Ví dụ, một tài liệu được chia thành các đoạn có 100 token và hai đoạn liên tiếp có 20 token trùng nhau:
Chunk 1:
Token 1 ---------------- Token 100

Chunk 2:
                    Token 81 ---------------- Token 180

Phần overlap:
                    Token 81 ---- Token 100
Trong ví dụ này, 20 token cuối của Chunk 1 xuất hiện lại ở đầu Chunk 2.
Overlap có thể giúp duy trì tính liên tục của nội dung, nhưng không phải lúc nào cũng cần thiết ở mức lớn.
Nếu overlap quá cao, nhiều chunk sẽ chứa nội dung trùng lặp. Điều này có thể làm tăng chi phí embedding, dung lượng lưu trữ và số lượng kết quả gần giống nhau trong quá trình truy xuất.
5. Các phương pháp Chunking phổ biến
5.1. Fixed-Size Chunking
Fixed-Size Chunking chia văn bản thành các đoạn theo một kích thước cố định.
Ví dụ, hệ thống chia văn bản thành các đoạn khoảng 500 token, với một phần overlap giữa những đoạn liên tiếp.
Ưu điểm:
- Dễ triển khai.
- Cấu hình đơn giản.
- Dễ kiểm soát kích thước dữ liệu.
Hạn chế:
- Có thể cắt giữa câu hoặc giữa một ý đang được giải thích.
- Không tận dụng đầy đủ cấu trúc tự nhiên của tài liệu.
Phương pháp này phù hợp để làm baseline ban đầu khi thử nghiệm một hệ thống RAG.
5.2. Recursive Chunking
Recursive Chunking chia văn bản theo nhiều cấp độ phân tách. Hệ thống có thể ưu tiên chia theo các ranh giới lớn như đoạn văn, sau đó tiếp tục chia nhỏ hơn nếu nội dung vẫn vượt quá kích thước mục tiêu.
Ví dụ:
Document
   |
   v
Split by Sections
   |
   v
Split by Paragraphs
   |
   v
Split by Sentences
   |
   v
Chunks
Thứ tự và quy tắc phân tách cụ thể phụ thuộc vào công cụ được sử dụng.
Ưu điểm: thường giữ được cấu trúc nội dung tốt hơn so với việc cắt hoàn toàn theo số ký tự cố định.
Hạn chế: cần thiết kế quy tắc phân tách phù hợp với từng loại dữ liệu.
5.3. Semantic Chunking
Semantic Chunking cố gắng chia văn bản dựa trên sự thay đổi về chủ đề hoặc ý nghĩa, thay vì chỉ dựa vào kích thước cố định.
Ví dụ, một đoạn giải thích về Embedding có thể được giữ cùng nhau, trong khi phần chuyển sang Vector Database có thể được xem là một đơn vị nội dung khác.
Ưu điểm: có thể tạo ra các đoạn giữ được tính thống nhất về chủ đề.
Hạn chế: cách triển khai thường phức tạp hơn và có thể cần thêm bước tính toán để xác định ranh giới.
Semantic Chunking không bảo đảm kết quả luôn tốt hơn. Hiệu quả cần được kiểm tra trên dữ liệu và truy vấn thực tế.
5.4. Structure-Based Chunking
Structure-Based Chunking tận dụng cấu trúc sẵn có của tài liệu.
Ví dụ:
- Tài liệu Markdown: chia theo Heading và Section.
- Tài liệu HTML: chia theo các phần tử nội dung phù hợp.
- Tài liệu pháp lý: chia theo điều, khoản và mục.
- Tài liệu kỹ thuật: chia theo chương, mục và hướng dẫn.
Phương pháp này hữu ích khi cấu trúc tài liệu mang ý nghĩa quan trọng và có thể được trích xuất một cách đáng tin cậy.
6. So sánh các phương pháp Chunking
| Phương pháp | Cơ sở chia | Ưu điểm chính | Lưu ý |
|---|---|---|---|
| Fixed-Size | Kích thước cố định | Đơn giản, dễ kiểm soát | Có thể cắt ngang ý nghĩa |
| Recursive | Nhiều cấp độ phân tách | Tận dụng ranh giới văn bản | Cần chọn quy tắc phù hợp |
| Semantic | Độ liên quan về ngữ nghĩa | Có thể giữ nội dung cùng chủ đề | Phức tạp và tốn thêm tính toán |
| Structure-Based | Cấu trúc tài liệu | Giữ được cấu trúc tự nhiên | Phụ thuộc chất lượng dữ liệu đầu vào |
Trong thực tế, các phương pháp này có thể được kết hợp. Chẳng hạn, hệ thống chia tài liệu theo Heading trước, sau đó tiếp tục dùng Recursive Chunking để kiểm soát kích thước từng đoạn.
7. Chunking ảnh hưởng đến Embedding như thế nào?
Embedding Model chuyển văn bản thành vector để hệ thống có thể thực hiện tìm kiếm ngữ nghĩa.
Chất lượng biểu diễn phụ thuộc một phần vào nội dung được đưa vào mô hình. Vì vậy, cách chia chunk có thể ảnh hưởng đến kết quả Embedding.
Hãy xem xét hai trường hợp:
Trường hợp A: Chunk quá rộng
Một chunk chứa nhiều chủ đề khác nhau, chẳng hạn định nghĩa, hướng dẫn cài đặt, lỗi thường gặp và ví dụ lập trình.
Vector được tạo từ đoạn này có thể không phản ánh rõ một ý cụ thể mà người dùng đang tìm kiếm.
Trường hợp B: Chunk quá hẹp
Một chunk chỉ chứa một câu như “Điều này giúp cải thiện hiệu quả.” Nếu không có câu trước đó, người đọc có thể không biết “điều này” đang nói đến phương pháp nào.
Chunk nhỏ không tự động tạo ra Embedding tốt hơn, bởi ngữ cảnh có thể bị mất khi chia văn bản quá chi tiết.
Do đó, mục tiêu là tạo ra những đoạn đủ tập trung nhưng vẫn giữ được thông tin cần thiết để hiểu nội dung.
8. Chunking trong pipeline RAG
Chunking thường diễn ra trong giai đoạn chuẩn bị dữ liệu, trước khi người dùng gửi câu hỏi.
                Documents
                    |
                    v
             Text Extraction
                    |
                    v
                Chunking
                    |
                    v
                Embedding
                    |
                    v
              Vector Database
                    |
              User Question
                    |
                    v
                Retrieval
                    |
                    v
             Relevant Chunks
                    |
                    v
                   LLM
                    |
                    v
                  Answer
Trong một hệ thống thực tế, Retrieval có thể sử dụng Vector Search, Keyword Search hoặc Hybrid Search. Reranking cũng có thể được bổ sung để sắp xếp lại những chunk được truy xuất trước khi đưa vào context.
Điều quan trọng là Chunking không hoạt động độc lập. Chất lượng của nó cần được đánh giá cùng với cách tạo Embedding, phương pháp Retrieval và chiến lược xây dựng context.
9. Những lỗi thường gặp khi thiết kế Chunking
9.1. Chọn kích thước chunk theo cảm tính
Một cấu hình được sử dụng thành công trong dự án này chưa chắc phù hợp với một dự án khác. Cần thử nghiệm nhiều kích thước trên tập truy vấn đại diện.
9.2. Chia tách các phần phụ thuộc vào nhau
Nếu tiêu đề, điều kiện hoặc phần giải thích bị tách khỏi nội dung chính, chunk có thể trở nên khó hiểu khi được truy xuất độc lập.
9.3. Sử dụng overlap quá lớn
Overlap quá lớn có thể tạo nhiều chunk gần như giống nhau, làm tăng chi phí xử lý và khiến kết quả truy xuất chứa thông tin trùng lặp.
9.4. Bỏ qua metadata
Ngoài nội dung văn bản, hệ thống nên cân nhắc lưu những metadata hữu ích như tên tài liệu, tiêu đề mục, trang hoặc loại tài liệu.
Metadata giúp hệ thống truy xuất và xác định nguồn thông tin thuận tiện hơn.
9.5. Chỉ đánh giá chunk riêng lẻ
Một chunk có vẻ hợp lý khi đọc riêng chưa chắc là lựa chọn tốt nhất cho mọi truy vấn. Cần kiểm tra xem hệ thống có tìm đúng đoạn tài liệu và cung cấp đủ context để trả lời câu hỏi hay không.
10. Cách đánh giá chiến lược Chunking
Để lựa chọn chiến lược phù hợp, có thể xây dựng một quy trình thử nghiệm có kiểm soát.
- Chuẩn bị một tập câu hỏi đại diện cho người dùng.
- Xác định những đoạn tài liệu được xem là phù hợp với từng câu hỏi.
- Thử nghiệm các phương pháp Chunking và kích thước khác nhau.
- Giữ nhất quán các thành phần khác khi so sánh.
- Đánh giá chất lượng Retrieval bằng Precision@K, Recall@K hoặc nDCG@K.
- Đánh giá thêm chất lượng câu trả lời, độ trễ và chi phí của hệ thống RAG.
Không nên chỉ dựa vào một chỉ số duy nhất. Ví dụ, tăng Recall@K có thể giúp hệ thống tìm được nhiều tài liệu liên quan hơn, nhưng cũng có thể làm tăng số lượng đoạn cần xử lý.
Chiến lược phù hợp là chiến lược đáp ứng tốt yêu cầu thực tế của hệ thống, không nhất thiết là chiến lược phức tạp nhất.
11. Tổng kết
Chunking là bước chia tài liệu thành những đoạn nhỏ để phục vụ xử lý, tạo Embedding và truy xuất thông tin trong nhiều hệ thống AI.
Các khái niệm quan trọng cần ghi nhớ:
- Chunk Size: kích thước của mỗi đoạn.
- Chunk Overlap: phần nội dung lặp lại giữa các đoạn liền kề.
- Fixed-Size Chunking: chia theo kích thước cố định.
- Recursive Chunking: chia theo nhiều cấp độ phân tách.
- Semantic Chunking: chia dựa trên sự thay đổi về ngữ nghĩa.
- Structure-Based Chunking: tận dụng cấu trúc tự nhiên của tài liệu.
Không có một chiến lược Chunking tối ưu cho mọi hệ thống. Cách lựa chọn cần dựa trên đặc điểm dữ liệu, câu hỏi của người dùng và kết quả đánh giá thực tế.
Khi được thiết kế hợp lý, Chunking tạo nền tảng tốt hơn cho Embedding, Semantic Search, Hybrid Search, Reranking và toàn bộ pipeline RAG.
Tài liệu tham khảo
- LangChain – Text Splitters
- LlamaIndex – Documentation
- Pinecone – Chunking Strategies
- Lewis et al. – Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Khám phá thêm tại MCNA Technology School
Nếu bạn muốn tìm hiểu thêm về Data, AI và các ứng dụng trí tuệ nhân tạo, hãy tham khảo các chương trình học tại MCNA Technology School:
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp.
Đối tác đào tạo: Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
- 🌐 mcna.vn
- 📘 facebook.com/mcnatechnologyschool
- ▶️ youtube.com/@mcna.technology.school
- 💼 linkedin.com/company/mcna-vn
- 📞 0939.866.825 (Mr. Minh Khang)
- 📍 30 Trung Liệt, Đống Đa, Hà Nội
- 📍 Liền kề 44B, TT2, Văn Quán, Hà Đông, Hà Nội
- 📍 The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu, TPHCM