RAG là gì? Cách AI sử dụng dữ liệu bên ngoài để trả lời
Ở bài trước, chúng ta đã tìm hiểu Fine-tuning – cách tiếp tục huấn luyện một mô hình đã được pre-trained để phù hợp hơn với một nhiệm vụ hoặc domain cụ thể.
Nhưng nếu doanh nghiệp có một kho tài liệu riêng và thường xuyên cập nhật dữ liệu thì có nhất thiết phải fine-tune lại mô hình mỗi lần dữ liệu thay đổi không?
Câu trả lời trong nhiều trường hợp là không.
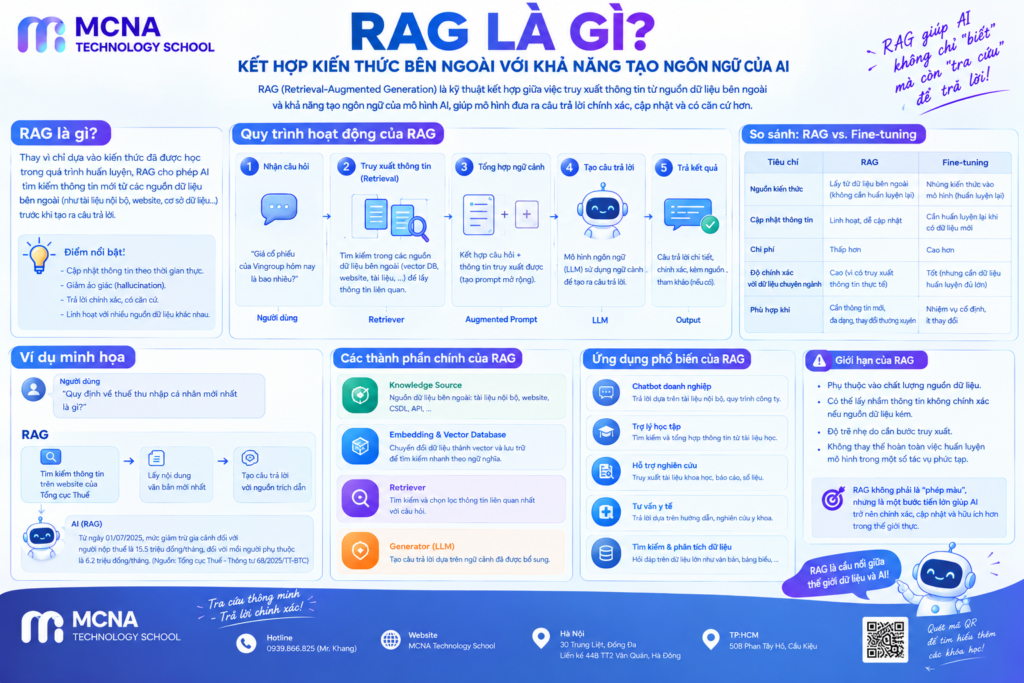
Một phương pháp quan trọng được sử dụng trong các hệ thống AI hiện đại là RAG – Retrieval-Augmented Generation.
Thay vì yêu cầu LLM ghi nhớ toàn bộ thông tin, RAG cho phép hệ thống tìm kiếm thông tin liên quan từ nguồn dữ liệu bên ngoài rồi đưa thông tin đó vào context của model.
1. RAG là gì?
RAG là viết tắt của Retrieval-Augmented Generation.
Đây là một kiến trúc kết hợp giữa hai quá trình:
- Retrieval: tìm kiếm thông tin liên quan.
- Generation: sử dụng LLM để tạo câu trả lời dựa trên thông tin được tìm thấy.
Workflow cơ bản:
User Question
      ↓
Retrieve Relevant Documents
      ↓
Retrieved Context
      ↓
LLM
      ↓
Generated Answer
Điểm quan trọng là LLM không cần phải được retrain mỗi khi nguồn dữ liệu thay đổi.
2. Tại sao LLM cần RAG?
Một LLM được pre-trained trên lượng dữ liệu lớn nhưng không có nghĩa là nó biết chính xác mọi thông tin mà doanh nghiệp hoặc người dùng cần.
Ví dụ một công ty có:
- Quy trình nội bộ.
- Tài liệu nhân sự.
- Catalogue sản phẩm.
- Tài liệu kỹ thuật.
- Chính sách mới nhất.
- Database nội bộ.
Những dữ liệu này có thể không nằm trong training data của LLM.
RAG giải quyết vấn đề bằng cách đưa dữ liệu cần thiết vào context tại thời điểm truy vấn.
Company Documents
       ↓
Document Store
       ↓
Retriever
       ↓
Relevant Information
       ↓
LLM
       ↓
Answer
3. RAG khác Fine-tuning như thế nào?
Đây là một trong những khác biệt quan trọng nhất cần hiểu khi xây dựng ứng dụng LLM.
| Đặc điểm | Fine-tuning | RAG |
|---|---|---|
| Cách hoạt động | Training lại model trên dataset mới | Truy xuất dữ liệu khi inference |
| Thay đổi parameters | Có thể | Không nhất thiết |
| Cập nhật dữ liệu | Cần training lại | Có thể cập nhật document store |
| Phù hợp | Behavior, style, task adaptation | Knowledge retrieval |
| Chi phí cập nhật knowledge | Cao hơn | Thường thấp hơn |
Có thể ghi nhớ:
Fine-tuning
→ Thay đổi cách model học / phản hồi

RAG
→ Cung cấp thêm thông tin cho model khi trả lời
4. Một hệ thống RAG gồm những thành phần nào?
Một pipeline RAG cơ bản thường gồm:
Documents
    ↓
Document Processing
    ↓
Chunking
    ↓
Embedding
    ↓
Vector Database
    ↓
Retriever
    ↓
Context
    ↓
LLM
    ↓
Answer
Mỗi thành phần giải quyết một phần khác nhau của bài toán.
5. Document Processing
Trước khi tìm kiếm, dữ liệu cần được đưa về dạng mà hệ thống có thể xử lý.
Nguồn dữ liệu có thể là:
- PDF.
- Word.
- Website.
- TXT.
- CSV.
- Database.
- API.
Ví dụ:
PDF
 ↓
Extract Text
 ↓
Clean Text
 ↓
Split Documents
Đây là bước rất quan trọng vì dữ liệu đầu vào không sạch có thể ảnh hưởng trực tiếp đến chất lượng retrieval.
6. Chunking là gì?
LLM hoặc embedding model thường không xử lý toàn bộ một tài liệu dài như một khối duy nhất.
Do đó, tài liệu thường được chia thành những đoạn nhỏ hơn gọi là chunks.
Large Document
       ↓
 ┌───────────────┐
 │ Chunk 1       │
 ├───────────────┤
 │ Chunk 2       │
 ├───────────────┤
 │ Chunk 3       │
 ├───────────────┤
 │ Chunk 4       │
 └───────────────┘
Ví dụ một tài liệu 100 trang có thể được chia thành nhiều đoạn văn nhỏ.
Mục tiêu là tạo ra những chunk đủ nhỏ để retrieval chính xác nhưng vẫn giữ đủ context để LLM hiểu được nội dung.
7. Vì sao Chunking quan trọng?
Nếu chunk quá lớn:
Too Large
   ↓
Nhiều thông tin không liên quan
   ↓
Retrieval kém chính xác
Nếu chunk quá nhỏ:
Too Small
   ↓
Mất context
   ↓
Thông tin bị chia nhỏ
Vì vậy, chunk size và overlap thường cần được điều chỉnh dựa trên loại dữ liệu và bài toán.
8. Embedding là gì?
Sau khi chia tài liệu thành các chunk, hệ thống cần biến mỗi chunk thành một vector số.
Quá trình này được thực hiện bởi Embedding Model.
Text Chunk
    ↓
Embedding Model
    ↓
Vector
Ví dụ minh họa:
"Machine Learning là..."

        ↓

[0.21, -0.14, 0.82, 0.37, ...]
Vector này đại diện cho đặc trưng ngữ nghĩa của đoạn text trong một không gian vector.
9. Vector Database là gì?
Các vector được lưu trong một hệ thống có khả năng tìm kiếm vector hiệu quả.
Đó có thể là một Vector Database hoặc một hệ thống hỗ trợ vector search.
Document
   ↓
Chunk
   ↓
Embedding
   ↓
Vector Database
Mỗi record thường chứa:
- Vector.
- Nội dung chunk.
- Metadata.
Metadata có thể bao gồm:
{
  "source": "employee_handbook.pdf",
  "page": 15,
  "department": "HR"
}
Metadata có thể được sử dụng để lọc hoặc truy xuất dữ liệu chính xác hơn.
10. Retrieval hoạt động như thế nào?
Khi người dùng đặt câu hỏi, câu hỏi cũng được chuyển thành vector.
User Question
      ↓
Embedding Model
      ↓
Query Vector
Hệ thống sau đó tìm những vector gần với query vector trong vector database.
Query Vector
     ↓
Similarity Search
     ↓
Top-K Relevant Chunks
Những chunk này sẽ được đưa vào context của LLM.
11. Similarity Search là gì?
Retrieval thường dựa trên một phép đo độ tương đồng giữa vector của query và vector của document.
Một phương pháp phổ biến là Cosine Similarity.
Query Vector
      ↕
Document Vector

        ↓

Cosine Similarity
        ↓
Similarity Score
Hai vector càng có hướng tương đồng thì similarity score càng cao.
Nhờ đó, hệ thống có thể tìm những đoạn văn có ý nghĩa gần với câu hỏi.
12. Top-K Retrieval
Thay vì đưa toàn bộ database vào LLM, hệ thống thường chỉ lấy một số chunk có độ liên quan cao nhất.
100,000 Documents
        ↓
Retriever
        ↓
Top 5 Chunks
        ↓
LLM
Giá trị K phụ thuộc vào bài toán.
K quá nhỏ có thể khiến hệ thống bỏ sót thông tin cần thiết.
K quá lớn có thể đưa quá nhiều thông tin không liên quan vào context.
13. Reranking là gì?
Trong những hệ thống RAG phức tạp hơn, retrieval có thể gồm nhiều bước.
Query
 ↓
Initial Retrieval
 ↓
Candidate Documents
 ↓
Reranker
 ↓
Best Documents
 ↓
LLM
Reranker đánh giá lại các kết quả ban đầu để xác định những tài liệu thực sự liên quan nhất với câu hỏi.
Điều này có thể giúp cải thiện chất lượng context trước khi đưa vào LLM.
14. Generation trong RAG
Sau khi retrieval hoàn thành, hệ thống tạo một prompt chứa câu hỏi và context được tìm thấy.
System Instruction
       +
User Question
       +
Retrieved Context
       ↓
LLM
       ↓
Generated Answer
Ví dụ:
Question:
"Chính sách nghỉ phép của công ty là gì?"

Retrieved Context:
"Nhân viên được nghỉ..."

        ↓

LLM

        ↓

Answer dựa trên context
Đây chính là phần Generation trong Retrieval-Augmented Generation.
15. RAG có loại bỏ Hallucination không?
Không.
RAG có thể giúp cung cấp thông tin liên quan cho model, nhưng không đảm bảo câu trả lời luôn chính xác.
Hallucination vẫn có thể xảy ra nếu:
- Retriever tìm sai tài liệu.
- Chunk không chứa đủ context.
- Document có thông tin sai.
- LLM diễn giải sai context.
- Prompt không kiểm soát tốt cách sử dụng context.
Vì vậy:
Good Retrieval
       ≠
Guaranteed Correct Answer
16. RAG giúp giảm vấn đề Knowledge Cutoff
Một LLM pretrained được huấn luyện trên dữ liệu đến một thời điểm nhất định.
Nếu một tài liệu mới xuất hiện sau quá trình training, model không nhất thiết biết thông tin đó.
RAG có thể đưa tài liệu mới vào hệ thống retrieval.
New Document
     ↓
Embedding
     ↓
Vector Database
     ↓
Retrieve
     ↓
LLM
     ↓
Answer using new information
Do đó, hệ thống có thể cập nhật knowledge source mà không nhất thiết phải retrain toàn bộ LLM.
17. RAG trong doanh nghiệp
RAG đặc biệt phù hợp với những hệ thống có lượng tài liệu nội bộ lớn.
Ví dụ:
- Chatbot hỏi đáp tài liệu doanh nghiệp.
- Trợ lý nhân sự.
- Trợ lý pháp lý.
- Technical documentation assistant.
- Product knowledge assistant.
- Customer support.
- Knowledge management.
Một hệ thống đơn giản:
Company Documents
       ↓
RAG Pipeline
       ↓
Internal AI Assistant
       ↓
Employee Question
       ↓
Answer from Company Knowledge
18. RAG và Data Engineering
RAG không chỉ là bài toán LLM.
Để xây dựng một hệ thống RAG tốt, cần xử lý nhiều vấn đề quen thuộc của Data Engineering:
- Data ingestion.
- Data cleaning.
- Data transformation.
- Metadata management.
- Indexing.
- Data update.
- Monitoring.
Có thể xem RAG như một pipeline dữ liệu kết hợp với LLM:
Raw Data
   ↓
ETL / Processing
   ↓
Chunking
   ↓
Embedding
   ↓
Vector Store
   ↓
Retrieval
   ↓
LLM
Đây là lý do RAG có sự giao thoa mạnh giữa Data Engineering, Information Retrieval và Generative AI.
19. Những yếu tố quyết định chất lượng RAG
Một hệ thống RAG tốt không chỉ phụ thuộc vào LLM.
Có thể chia thành nhiều thành phần:
Data Quality
     +
Chunking
     +
Embedding
     +
Retrieval
     +
Reranking
     +
Prompt
     +
LLM
     ↓
RAG Quality
Nếu retrieval kém, một LLM rất mạnh cũng có thể nhận context không phù hợp.
Ngược lại, một pipeline dữ liệu tốt có thể cải thiện đáng kể chất lượng câu trả lời của cùng một model.
20. RAG Evaluation
Đánh giá RAG cần xem xét ít nhất hai phần:
Retrieval
Hệ thống có tìm đúng tài liệu cần thiết hay không?
Generation
LLM có sử dụng context đúng và tạo ra câu trả lời phù hợp hay không?
Có thể hình dung:
Question
   ↓
Retrieval Evaluation
   ↓
Relevant Context?
   ↓
Generation Evaluation
   ↓
Correct Answer?
Do đó, không nên chỉ đánh giá RAG bằng việc nhìn vào câu trả lời cuối cùng.
21. RAG có thay thế Fine-tuning không?
Không.
Hai phương pháp giải quyết những vấn đề khác nhau.
Need external knowledge?
        ↓
       RAG

Need specific behavior / style / task adaptation?
        ↓
   Fine-tuning
Trong một hệ thống thực tế, cả hai có thể được sử dụng cùng nhau.
Fine-tuned LLM
      +
RAG Knowledge Base
      ↓
Specialized AI System
22. Tổng kết
RAG – Retrieval-Augmented Generation là kiến trúc kết hợp retrieval với generative AI, cho phép LLM sử dụng thông tin từ nguồn dữ liệu bên ngoài khi tạo câu trả lời.
Những khái niệm quan trọng cần nhớ:
- Chunking: chia tài liệu thành các đoạn nhỏ.
- Embedding: chuyển text thành vector.
- Vector Database: lưu trữ và tìm kiếm vector.
- Retrieval: tìm context liên quan.
- Reranking: đánh giá lại các kết quả retrieval.
- Generation: LLM tạo câu trả lời dựa trên context.
- RAG: kết hợp retrieval và generation.
Có thể ghi nhớ bằng một câu:
RAG không bắt LLM học lại dữ liệu; nó tìm thông tin cần thiết từ nguồn bên ngoài rồi đưa thông tin đó vào context để LLM tạo câu trả lời.
Ở bài tiếp theo, chúng ta sẽ đi thêm một bước: AI Agent là gì? và vì sao một Agent không chỉ đơn giản là một chatbot sử dụng LLM.
Tài liệu tham khảo
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Attention Is All You Need
- Pinecone – Retrieval-Augmented Generation
- Hugging Face – RAG Resources
🚀 Học Data Science & AI cùng MCNA Technology School
Nếu bạn muốn xây dựng nền tảng từ Python, Data Analysis đến AI và Machine Learning, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Minh Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu


