LLM là gì? Vì sao mô hình ngôn ngữ càng lớn càng mạnh?
Ở bài trước, chúng ta đã tìm hiểu GPT và cách mô hình dự đoán từng token tiếp theo để tạo ra văn bản.
Nhưng tại sao những mô hình như GPT lại có thể thực hiện nhiều nhiệm vụ khác nhau chỉ từ một câu lệnh? Và “Large Language Model” thực sự có nghĩa là gì?
Để trả lời câu hỏi này, cần hiểu ba yếu tố quan trọng: model size, data và compute.
1. LLM là gì?
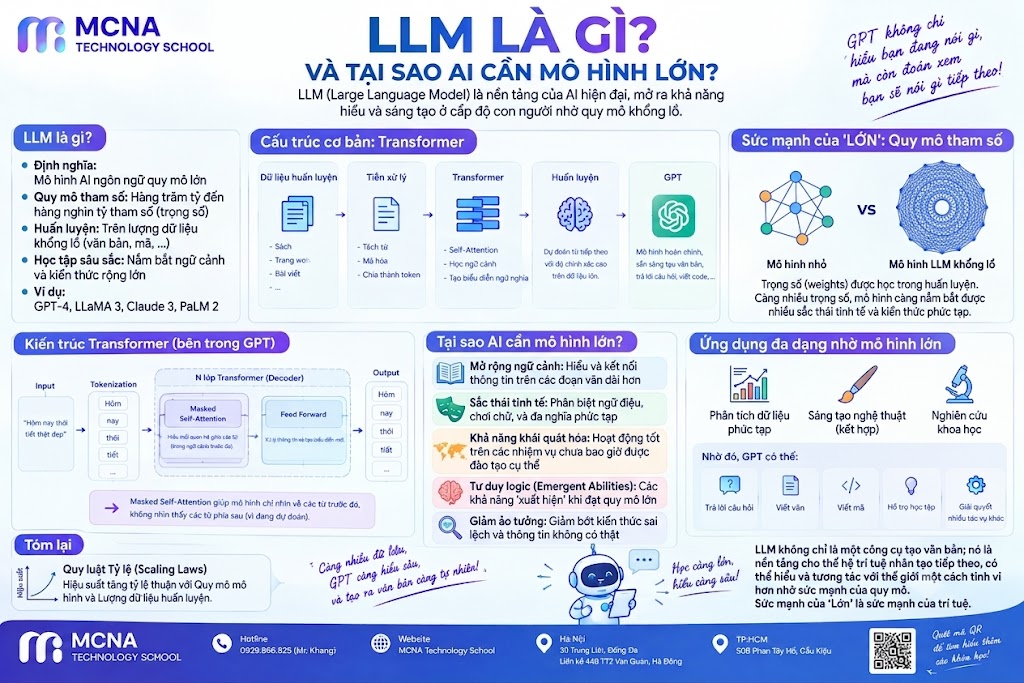
LLM là viết tắt của Large Language Model – mô hình ngôn ngữ lớn.
LLM là một loại mô hình Machine Learning được huấn luyện trên lượng lớn dữ liệu văn bản để học cách biểu diễn và tạo ra ngôn ngữ.
Có thể hình dung quá trình đơn giản:
Large Dataset
      ↓
Pre-training
      ↓
Large Language Model
      ↓
Prompt
      ↓
Generated Output
GPT là một ví dụ tiêu biểu của kiến trúc được sử dụng để xây dựng LLM.
2. Vì sao gọi là “Large”?
“Large” không chỉ đơn giản có nghĩa là mô hình có nhiều parameter.
Quy mô của một LLM thường liên quan đến nhiều yếu tố:
- Số lượng parameters.
- Lượng dữ liệu training.
- Lượng computation sử dụng trong training.
- Độ dài context mà mô hình có thể xử lý.
Ví dụ:
Model nhỏ
   ↓
Ít parameters
Ít dữ liệu
Ít compute

Model lớn
   ↓
Nhiều parameters
Nhiều dữ liệu
Nhiều compute
Do đó, không nên hiểu “LLM lớn hơn” chỉ đơn giản là “nhiều parameters hơn”.
3. Parameter là gì?
Parameter là các giá trị được mô hình học trong quá trình training.
Trong mạng neural, parameter chủ yếu nằm trong các weight và bias của các layer.
Input
  ↓
Neural Network
  ↓
Weights + Biases
  ↓
Output
Trong quá trình training:
Prediction
    ↓
Loss
    ↓
Backpropagation
    ↓
Gradient
    ↓
Update Parameters
Quá trình này được lặp lại rất nhiều lần để mô hình điều chỉnh các parameter nhằm giảm loss.
4. Parameter nhiều hơn có phải luôn tốt hơn?
Không.
Một mô hình lớn hơn có thể có khả năng biểu diễn những pattern phức tạp hơn, nhưng hiệu quả còn phụ thuộc vào:
- Chất lượng dữ liệu.
- Độ đa dạng của dữ liệu.
- Phương pháp training.
- Kiến trúc mô hình.
- Compute.
- Cách đánh giá.
Có thể hình dung:
Model Size
     +
Data Quality
     +
Training Compute
     +
Architecture
     ↓
Model Capability
Vì vậy, việc chỉ tăng số parameter không đảm bảo mọi khả năng của mô hình đều tăng tương ứng.
5. Scaling là gì?
Scaling là quá trình nghiên cứu xem khả năng của mô hình thay đổi như thế nào khi quy mô mô hình, dữ liệu và compute tăng lên.
Đây là một chủ đề quan trọng trong quá trình phát triển LLM.
Một cách đơn giản:
More Data
    +
More Parameters
    +
More Compute
    ↓
Larger Training Process
    ↓
Potentially Better Model
Tuy nhiên, mối quan hệ này không phải lúc nào cũng tuyến tính.
6. Scaling Laws
Các nghiên cứu về Scaling Laws cho thấy loss của language model có thể thay đổi theo quy mô model, dataset và compute theo những quy luật có thể đo lường được trong một số điều kiện.
Điều này có ý nghĩa rất lớn.
Thay vì chỉ thử nghiệm ngẫu nhiên, các nhà nghiên cứu có thể sử dụng những mối quan hệ quan sát được để ước lượng cách đầu tư compute và dữ liệu.
Model Size
     │
     ├──────────────┐
     │              │
Data Size       Compute
     │              │
     └──────┬───────┘
            ↓
       Training Loss
Một trong những tài liệu nền tảng về chủ đề này là nghiên cứu Scaling Laws for Neural Language Models.
7. Compute là gì?
Compute là tài nguyên tính toán được sử dụng để huấn luyện hoặc chạy mô hình.
Training một LLM lớn có thể yêu cầu lượng computation rất lớn.
Quá trình có thể hình dung:
Dataset
   ↓
GPU / TPU Cluster
   ↓
Forward Pass
   ↓
Loss
   ↓
Backward Pass
   ↓
Parameter Update
   ↓
Repeat
Khi quy mô mô hình và dataset tăng, nhu cầu về compute cũng tăng đáng kể.
8. Pre-training LLM diễn ra như thế nào?
Trong giai đoạn pre-training, mô hình được tiếp xúc với lượng lớn dữ liệu và học cách dự đoán token.
Ví dụ:
"The weather today is"

              ↓

Possible next tokens:

sunny      0.45
beautiful  0.12
cold       0.10
...
Mô hình so sánh prediction với target token và tính loss.
Sau đó:
Loss
 ↓
Backpropagation
 ↓
Gradient
 ↓
Update Parameters
Quá trình được lặp lại trên lượng dữ liệu rất lớn.
9. Tại sao LLM có thể làm nhiều nhiệm vụ?
Một đặc điểm thú vị của LLM là một mô hình pretrained có thể được sử dụng cho nhiều nhiệm vụ khác nhau.
Ví dụ cùng một mô hình có thể nhận:
"Translate this sentence..."

"Summarize this paragraph..."

"Write Python code..."

"Explain linear regression..."

"Classify this review..."
Điều này liên quan đến việc mô hình đã học được những biểu diễn và pattern tổng quát từ dữ liệu training.
Khi người dùng cung cấp instruction, mô hình sử dụng context đó để xác định kiểu output cần tạo.
10. Emergent Abilities là gì?
Emergent abilities là thuật ngữ được sử dụng để mô tả một số khả năng được quan sát khi mô hình tăng quy mô.
Ví dụ, một khả năng có thể rất yếu ở những model nhỏ nhưng thể hiện rõ hơn ở những model lớn.
Có thể minh họa:
Model Size
   │
   │
   │             █
   │             █
   │         █   █
   │     █   █   █
   └──────────────────
          Scale
Tuy nhiên, đây là một chủ đề vẫn được nghiên cứu và cách đo lường “emergence” có thể ảnh hưởng đến kết luận.
Vì vậy, không nên hiểu rằng mọi khả năng của LLM đều đột nhiên xuất hiện tại một kích thước cố định.
11. Instruction Tuning là gì?
Pre-training giúp mô hình học ngôn ngữ, nhưng một mô hình pretrained không nhất thiết trả lời theo cách người dùng mong muốn.
Vì vậy, mô hình có thể được tiếp tục training trên những dữ liệu dạng instruction.
Pretrained LLM
      ↓
Instruction Tuning
      ↓
Instruction-following Model
Ví dụ:
Instruction:
"Giải thích Linear Regression cho người mới học."

Expected behavior:
→ Giải thích rõ ràng
→ Có ví dụ
→ Phù hợp với yêu cầu
Instruction tuning giúp mô hình thích nghi tốt hơn với dạng tương tác thông qua prompt.
12. Fine-tuning và Instruction Tuning
Hai khái niệm này có liên quan nhưng không hoàn toàn giống nhau.
| Khái niệm | Mục đích |
|---|---|
| Pre-training | Học biểu diễn và pattern ngôn ngữ tổng quát |
| Fine-tuning | Điều chỉnh model cho một nhiệm vụ hoặc miền cụ thể |
| Instruction Tuning | Huấn luyện model thực hiện và phản hồi theo instruction |
Trong các hệ thống hiện đại, quy trình training có thể phức tạp hơn và bao gồm nhiều giai đoạn khác nhau.
13. LLM có “hiểu” như con người không?
Đây là một câu hỏi khó và cần phân biệt giữa khả năng xử lý ngôn ngữ và hiểu biết theo nghĩa của con người.
LLM có thể:
- Xác định pattern trong văn bản.
- Liên kết các khái niệm.
- Tạo câu trả lời phù hợp với context.
- Thực hiện nhiều nhiệm vụ thông qua instruction.
Nhưng output của mô hình vẫn được tạo ra thông qua quá trình tính toán trên learned parameters và context.
Do đó, không nên mặc định rằng một câu trả lời trôi chảy đồng nghĩa với việc mô hình có cùng kiểu hiểu biết và trải nghiệm như con người.
14. Hallucination trong LLM
Một trong những vấn đề quan trọng của LLM là hallucination.
Mô hình có thể tạo ra một câu trả lời rất tự nhiên nhưng thông tin bên trong lại không chính xác.
Prompt
  ↓
LLM
  ↓
Fluent Output
  ↓
Có thể đúng
hoặc
Có thể sai
Điều này xảy ra bởi mục tiêu sinh token không đồng nghĩa với việc mô hình luôn kiểm chứng tính đúng sai của từng thông tin.
Vì vậy, với những thông tin quan trọng, cần kiểm tra output bằng nguồn đáng tin cậy.
15. LLM và AI Agent có giống nhau không?
Không.
LLM là mô hình ngôn ngữ.
AI Agent thường là một hệ thống sử dụng LLM kết hợp với các thành phần khác.
AI Agent
   │
   ├── LLM
   ├── Tools
   ├── Memory
   ├── Planning
   └── External Systems
Ví dụ một agent có thể sử dụng LLM để quyết định cần gọi API nào, sau đó nhận kết quả và tiếp tục xử lý.
Do đó:
LLM ≠ AI Agent
LLM có thể là một thành phần quan trọng bên trong agent.
16. Từ LLM đến Generative AI
LLM là một trong những nền tảng quan trọng của Generative AI cho văn bản.
Nhưng Generative AI không chỉ có text.
Generative AI
     │
     ├── Text
     │
     ├── Image
     │
     ├── Audio
     │
     ├── Video
     │
     └── Code
LLM tập trung chủ yếu vào việc xử lý và sinh dữ liệu ngôn ngữ, trong khi các mô hình generative khác có thể được thiết kế cho những loại dữ liệu khác.
17. Vì sao LLM quan trọng với Data Science?
LLM đang tạo ra nhiều ứng dụng mới trong Data Science và Analytics.
Ví dụ:
- Natural Language Query cho dữ liệu.
- SQL generation.
- Code assistance.
- Document analysis.
- Data summarization.
- Automated reporting.
- Text classification.
Một workflow có thể được xây dựng như sau:
User Question
      ↓
LLM
      ↓
SQL Generation
      ↓
Database
      ↓
Query Result
      ↓
LLM
      ↓
Natural Language Answer
Điều này tạo ra sự kết hợp giữa Data Engineering, Data Analytics và Generative AI.
18. Tổng kết
Large Language Model là mô hình ngôn ngữ được huấn luyện trên quy mô lớn, có khả năng học các pattern phức tạp trong dữ liệu và thực hiện nhiều nhiệm vụ thông qua context hoặc instruction.
Những khái niệm quan trọng cần nhớ:
- Parameter: các giá trị được mô hình học trong training.
- Pre-training: giai đoạn học từ lượng dữ liệu lớn.
- Scaling: nghiên cứu tác động của việc tăng model, data và compute.
- Scaling Laws: các mối quan hệ định lượng giữa quy mô và hiệu năng/loss trong những điều kiện nhất định.
- Instruction Tuning: giúp mô hình thực hiện instruction tốt hơn.
- In-context Learning: sử dụng thông tin và ví dụ ngay trong context.
- Hallucination: output có thể trôi chảy nhưng không chính xác.
Có thể ghi nhớ bằng một câu:
LLM là mô hình ngôn ngữ được huấn luyện ở quy mô lớn, kết hợp dữ liệu, model và compute để học những pattern phức tạp của ngôn ngữ.
Ở bài tiếp theo, chúng ta sẽ đi sâu hơn vào một thành phần rất quan trọng của LLM hiện đại: Fine-tuning là gì? và tại sao một mô hình pretrained có thể được điều chỉnh để phục vụ những mục đích cụ thể.
Tài liệu tham khảo
- Scaling Laws for Neural Language Models
- Language Models are Few-Shot Learners
- Training language models to follow instructions with human feedback
- Hugging Face – LLM Course
🚀 Học Data Science & AI cùng MCNA Technology School
Nếu bạn muốn xây dựng nền tảng từ Python, Data Analysis đến AI và Machine Learning, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu