Attention Mechanism là gì? Cách AI tập trung vào thông tin quan trọng
Ở các bài trước, chúng ta đã lần lượt tìm hiểu RNN, LSTM và GRU – những kiến trúc được sử dụng để xử lý dữ liệu tuần tự như văn bản, âm thanh và time series.
Tuy nhiên, các mô hình recurrent vẫn có một hạn chế: khi sequence trở nên dài, việc ghi nhớ và sử dụng thông tin ở những vị trí xa nhau có thể trở nên khó khăn.
Để giải quyết vấn đề này, một ý tưởng rất quan trọng đã xuất hiện: Attention Mechanism.
Attention cho phép mô hình không cần xem mọi thông tin với mức độ quan trọng như nhau, mà có thể tập trung nhiều hơn vào những phần liên quan đến nhiệm vụ đang thực hiện.
Đây cũng chính là một trong những nền tảng quan trọng dẫn tới sự ra đời của Transformer.
1. Attention là gì?
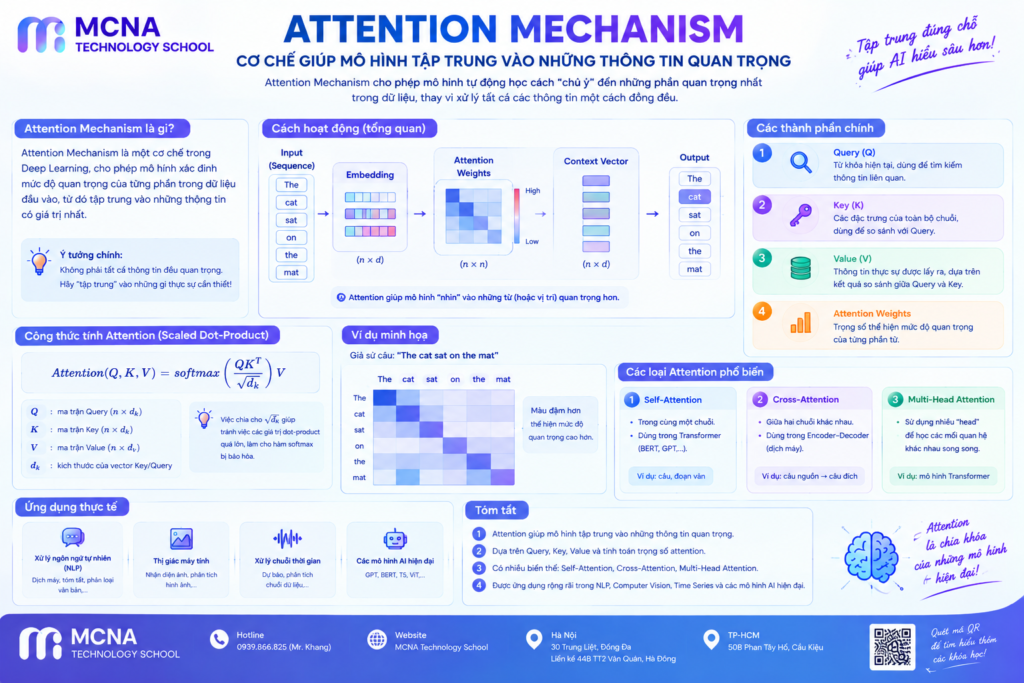
Attention Mechanism là một cơ chế cho phép mô hình học cách xác định mức độ quan trọng của những phần khác nhau trong input khi tạo ra một output.
Hiểu đơn giản, thay vì cố gắng ghi nhớ toàn bộ thông tin theo cùng một mức độ, mô hình sẽ đặt nhiều “sự chú ý” hơn vào những thông tin có liên quan.
Ví dụ, xét câu:
“The cat sat on the mat because it was tired.”
Khi mô hình cần hiểu từ “it” đang đề cập đến đối tượng nào, thông tin gần đó có thể không phải là yếu tố duy nhất quan trọng. Mô hình cần xem xét những từ khác trong câu để xác định mối quan hệ phù hợp.
Attention giúp mô hình thực hiện điều này bằng cách tính toán mức độ liên quan giữa các phần tử trong sequence.
2. Tại sao cần Attention?
Hãy tưởng tượng một mô hình dịch câu:
"I studied Data Science at university because I wanted
to work with artificial intelligence."
Nếu sử dụng một mô hình recurrent truyền thống, thông tin thường được xử lý tuần tự:
Word 1 → Word 2 → Word 3 → Word 4 → ... → Word N
Thông tin từ những từ đầu tiên phải được truyền qua nhiều timestep trước khi có thể ảnh hưởng đến những từ ở cuối câu.
Sequence càng dài, việc duy trì thông tin từ quá khứ càng khó khăn.
Attention đưa ra một cách tiếp cận khác:
                Toàn bộ sequence
                       │
        ┌──────────────┼──────────────┐
        ▼              ▼              ▼
      Word 1         Word 2         Word N
        │              │              │
        └──────────────┼──────────────┘
                       ▼
              Attention Scores
                       │
                       ▼
             Thông tin quan trọng
Mô hình có thể trực tiếp đánh giá mức độ liên quan giữa các phần tử thay vì chỉ phụ thuộc vào việc truyền hidden state qua từng timestep.
3. Attention hoạt động như thế nào?
Ở mức khái niệm, Attention có thể được chia thành ba bước:
- Tính mức độ liên quan giữa các phần tử.
- Chuyển các mức độ liên quan thành trọng số.
- Kết hợp thông tin dựa trên những trọng số đó.
Có thể hình dung:
Input
  │
  ▼
Tính độ liên quan
  │
  ▼
Attention Scores
  │
  ▼
Attention Weights
  │
  ▼
Weighted Information
  │
  ▼
Output
Như vậy, Attention không đơn giản chỉ là “nhìn vào thông tin”, mà là một quá trình tính toán trọng số để xác định thông tin nào có ảnh hưởng nhiều hơn đến output.
4. Query, Key và Value
Một trong những khái niệm quan trọng nhất khi học Attention là:
- Query (Q)
- Key (K)
- Value (V)
Có thể hình dung một cách đơn giản:
- Query: Tôi đang tìm thông tin gì?
- Key: Tôi có thông tin gì và nó liên quan đến query đến mức nào?
- Value: Thông tin thực tế sẽ được lấy ra.
Ví dụ khi mô hình đang xử lý một từ:
Query
  │
  ├──── so sánh với ────► Key 1
  ├──── so sánh với ────► Key 2
  ├──── so sánh với ────► Key 3
  └──── so sánh với ────► Key N
                            │
                            ▼
                     Attention Weights
                            │
                            ▼
                      Weighted Values
Đây là nền tảng của Scaled Dot-Product Attention, cơ chế Attention nổi tiếng được sử dụng trong Transformer.
5. Attention Score là gì?
Để biết Query liên quan đến Key nào nhiều hơn, mô hình cần tính một attention score.
Một cách phổ biến là sử dụng tích vô hướng giữa Query và Key:
score = Q · K
Hai vector càng tương đồng về hướng, score có thể càng lớn.
Trong Scaled Dot-Product Attention, score được chia cho căn bậc hai của kích thước vector Key:
Attention(Q, K, V)
=
softmax(QKᵀ / √dₖ)V
Trong đó:
Q: Query.K: Key.V: Value.dₖ: kích thước của Key.softmax: chuyển score thành các trọng số Attention.
6. Softmax và Attention Weights
Sau khi tính attention score, chúng ta cần chuyển các score thành trọng số có thể sử dụng để kết hợp thông tin.
Đây là lúc Softmax được sử dụng.
Ví dụ:
Attention Scores:

Word A → 1.2
Word B → 0.5
Word C → 3.1
Word D → 0.2
Sau Softmax, chúng ta có thể nhận được các trọng số tương ứng:
Word A → 0.10
Word B → 0.05
Word C → 0.80
Word D → 0.05
Trong ví dụ này, Word C có trọng số lớn nhất.
Điều đó có nghĩa là khi tạo output, thông tin từ Word C sẽ có ảnh hưởng lớn hơn các từ còn lại.
7. Weighted Sum – Kết hợp thông tin
Sau khi có Attention Weights, mô hình sử dụng chúng để kết hợp các Value.
Output =
w₁V₁ + w₂V₂ + w₃V₃ + ... + wₙVₙ
Nếu một Value có trọng số lớn, nó sẽ đóng góp nhiều hơn vào output.
Quá trình có thể tóm tắt:
Query + Keys
     │
     ▼
Attention Scores
     │
     ▼
   Softmax
     │
     ▼
Attention Weights
     │
     ▼
Weights × Values
     │
     ▼
   Attention Output
8. Self-Attention là gì?
Một khái niệm quan trọng hơn nữa là Self-Attention.
Trong Self-Attention, Query, Key và Value đều được tạo ra từ chính sequence đầu vào.
Nói đơn giản, các từ trong một câu có thể “chú ý” đến những từ khác trong chính câu đó.
Ví dụ:
"The student opened the book because he needed it."

          ↑
          │
      "student"
          │
          ▼
        "he"
Self-Attention cho phép mô hình học mối quan hệ giữa các token trong cùng một sequence.
Đây là một trong những thành phần quan trọng nhất của Transformer.
9. Attention khác RNN như thế nào?
| Đặc điểm | RNN | Attention |
|---|---|---|
| Cách xử lý | Tuần tự | Có thể xử lý quan hệ giữa nhiều vị trí trực tiếp |
| Thông tin quá khứ | Truyền qua hidden state | Có thể kết nối trực tiếp giữa các vị trí |
| Sequence dài | Có thể gặp khó khăn | Có khả năng mô hình hóa quan hệ xa hiệu quả hơn |
| Parallelization | Hạn chế do tính tuần tự | Phù hợp hơn với tính toán song song |
| Kiến trúc tiêu biểu | RNN, LSTM, GRU | Transformer |
Attention không nhất thiết phải được xem như một “mô hình thay thế hoàn toàn RNN”. Nó là một cơ chế có thể được kết hợp với nhiều kiến trúc khác nhau.
10. Attention trong Machine Translation
Một trong những ứng dụng nổi tiếng của Attention là Machine Translation.
Giả sử chúng ta muốn dịch:
"I love studying Machine Learning."
Sang một ngôn ngữ khác.
Khi tạo từng từ trong câu output, mô hình có thể cần tập trung vào những từ khác nhau trong câu input.
Input:

I       love       studying       Machine Learning
│         │            │                 │
│         │            └─────────────────┤
│         └──────────────────────────────┤
└────────────────────────────────────────┘
                    │
                    ▼
               Attention
                    │
                    ▼
                Output
Thay vì phải nén toàn bộ câu input vào một vector cố định, Attention cho phép mô hình truy cập các phần khác nhau của input khi cần.
11. Attention trong Transformer
Năm 2017, nhóm nghiên cứu tại Google và University of Toronto công bố paper “Attention Is All You Need”.
Công trình này giới thiệu kiến trúc Transformer, sử dụng Attention làm thành phần trung tâm thay vì dựa vào recurrence như RNN.
Đây là một bước phát triển rất quan trọng trong lịch sử Deep Learning.
Transformer sử dụng:
- Self-Attention.
- Multi-Head Attention.
- Positional Encoding.
- Feed-Forward Network.
- Residual Connections.
- Layer Normalization.
Paper gốc:
Attention Is All You Need – Vaswani et al.
12. Multi-Head Attention là gì?
Transformer không chỉ sử dụng một Attention mechanism duy nhất.
Thay vào đó, nó sử dụng nhiều Attention Head.
Mỗi head có thể học những mối quan hệ khác nhau giữa các token.
                    Input
                      │
          ┌───────────┼───────────┐
          ▼           ▼           ▼
       Head 1       Head 2      Head 3
          │           │           │
          ▼           ▼           ▼
      Attention    Attention   Attention
          │           │           │
          └───────────┼───────────┘
                      ▼
                  Concatenate
                      │
                      ▼
                   Output
Ví dụ, một head có thể học mối quan hệ giữa chủ ngữ và động từ, trong khi một head khác có thể tập trung vào quan hệ ngữ nghĩa giữa các từ.
Đây chỉ là cách hình dung trực quan; các Attention Head không được lập trình thủ công để học một loại quan hệ cụ thể mà các mối quan hệ được học trong quá trình training.
13. Attention có phải là “AI đang nhìn” không?
Cách nói “AI tập trung vào từ quan trọng” rất hữu ích để hình dung Attention, nhưng cần hiểu rằng đây là một phép tính toán bằng vector và ma trận, không phải sự chú ý theo nghĩa con người.
Mô hình thực hiện:
Vector
  ↓
Dot Product
  ↓
Score
  ↓
Softmax
  ↓
Weight
  ↓
Weighted Sum
Do đó, Attention nên được hiểu là một cơ chế toán học giúp mô hình xác định mức độ đóng góp tương đối của các phần tử trong input vào một biểu diễn đầu ra.
14. Attention thay đổi Deep Learning như thế nào?
Attention mở ra một cách tiếp cận mới đối với dữ liệu tuần tự.
Trước đó, chúng ta có thể hình dung quá trình phát triển:
RNN
 │
 ▼
LSTM
 │
 ▼
GRU
 │
 ▼
Attention
 │
 ▼
Self-Attention
 │
 ▼
Transformer
Transformer sau đó trở thành nền tảng của rất nhiều mô hình hiện đại trong Natural Language Processing và các lĩnh vực khác.
Những kiến trúc như BERT, GPT và nhiều mô hình ngôn ngữ lớn đều gắn liền với sự phát triển của Transformer và Attention-based architectures.
15. Tổng kết
Attention Mechanism là một cơ chế giúp mô hình xác định mức độ quan trọng của các phần khác nhau trong input khi tạo output.
Các khái niệm quan trọng cần nhớ:
- Query: thông tin đang được truy vấn.
- Key: thông tin dùng để xác định mức độ liên quan.
- Value: thông tin được kết hợp để tạo output.
- Attention Score: mức độ liên quan giữa Query và Key.
- Attention Weight: trọng số sau khi chuẩn hóa score.
- Self-Attention: các phần tử trong cùng một sequence chú ý đến nhau.
- Multi-Head Attention: sử dụng nhiều attention head để học các mối quan hệ khác nhau.
Có thể ghi nhớ toàn bộ ý tưởng bằng một công thức:
Query + Key
     ↓
Attention Score
     ↓
Softmax
     ↓
Attention Weight
     ↓
Weighted Values
     ↓
Output
Và đây chính là cầu nối quan trọng từ RNN → LSTM → GRU → Attention → Transformer.
Ở bài tiếp theo, chúng ta sẽ đi sâu hơn vào Transformer – kiến trúc đã thay đổi cách Deep Learning xử lý dữ liệu ngôn ngữ và trở thành nền tảng của nhiều hệ thống AI hiện đại.
Tài liệu tham khảo
-
Attention Is All You Need – Vaswani et al.
-
Neural Machine Translation by Jointly Learning to Align and Translate
🚀 Học Data Science & AI cùng MCNA Technology School
Nếu bạn muốn xây dựng nền tảng từ Python, Data Analysis đến AI và Machine Learning, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Minh Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu