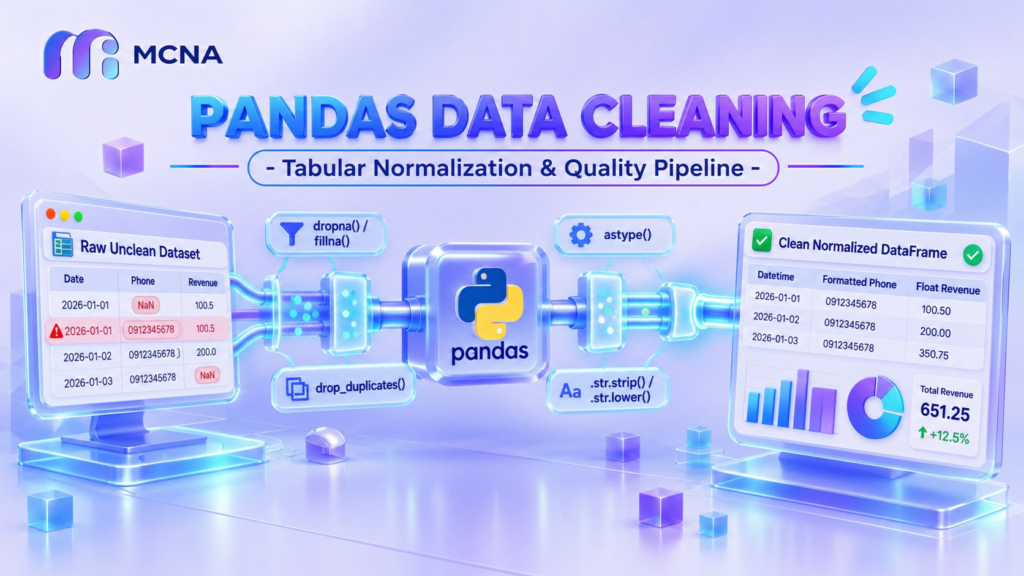
Trong phân tích dữ liệu, có một nguyên lý bất biến: “Garbage in, garbage out”. Nếu dữ liệu đầu vào là rác, kết quả phân tích hay báo cáo quản trị sẽ hoàn toàn mất giá trị. Thực tế tại các doanh nghiệp cho thấy Data Analyst thường phải dành từ 60% đến 80% thời gian của một dự án chỉ để kiểm tra, làm sạch và chuẩn hóa dữ liệu. Các bảng dữ liệu trích xuất từ CRM, POS hay Excel luôn tiềm ẩn nhiều vấn đề. Dữ liệu thường có giá trị khuyết thiếu (NaN) hoặc giao dịch bị trùng lặp. Tên khách hàng hay bị thừa khoảng trắng. Ngoài ra, cột ngày tháng và doanh thu thường bị lưu sai định dạng chuỗi (object).
Bài viết này cung cấp quy trình thực chiến toàn diện với thư viện Pandas trong Python. Bạn sẽ nắm vững 5 bước kiểm tra chất lượng dữ liệu đầu vào (Data Profiling). Đồng thời, bài viết hướng dẫn sử dụng chuẩn xác các hàm fillna(), dropna(), drop_duplicates(), astype() và chuỗi văn bản. Cuối cùng là cách đóng gói Data Pipeline làm sạch dữ liệu khách hàng và đơn hàng.
💡 TƯ DUY LÀM SẠCH DỮ LIỆU CHUẨN MỰC TRONG PANDAS
dropna(). Mục tiêu của Data Cleaning là bảo toàn tối đa thông tin kinh doanh có giá trị. Đồng thời, bạn cần khôi phục tính nhất quán của kiểu dữ liệu. Quan trọng nhất là thiết lập quy trình tự động hóa có thể tái sử dụng cho các kỳ báo cáo sau.1. Vì sao dữ liệu doanh nghiệp thực tế luôn cần làm sạch và chuẩn hóa?
Khi mới học lập trình phân tích, chúng ta thường làm việc với những tập dữ liệu mẫu trên Kaggle đã được chuẩn hóa gọn gàng. Trong môi trường doanh nghiệp thực tế, dữ liệu đến từ nhiều điểm chạm khác nhau. Đó có thể là biểu mẫu website, phần mềm POS tại cửa hàng hoặc file Excel nhập tay. Ngoài ra còn có log giao dịch từ cổng thanh toán.
groupby() sẽ tách "Hà Nội" và "Hà Nội " thành 2 thành phố khác nhau do dư khoảng trắng. Ngoài ra, hàm mean() sẽ bị kéo lệch bởi giá trị khuyết thiếu hoặc ngoại lai. Hàm count() cũng sẽ đếm trùng các đơn hàng bị lặp lại.4 Dạng dữ liệu bẩn thường gặp nhất trong doanh nghiệp
Bốn nhóm lỗi dữ liệu phổ biến nhất mà mọi Data Analyst đều phải xử lý hàng ngày:
- Giá trị khuyết thiếu (Missing Values –
NaN/None): Khách hàng có thể bỏ trống số điện thoại hoặc tuổi. Ngoài ra, lỗi kết nối API cũng làm mất thông tin doanh thu của một số giao dịch. - Bản ghi trùng lặp (Duplicate Records): Khách hàng có thể bấm nút thanh toán hai lần khi mạng chậm. Hoặc tiến trình đồng bộ dữ liệu (ETL) chạy lặp làm nhân đôi đơn hàng.
- Chuỗi văn bản không đồng nhất (Inconsistent Strings): Dính khoảng trắng thừa ở hai đầu, viết hoa viết thường lộn xộn (
"completed","COMPLETED","Completed") hoặc chứa ký tự đặc biệt. - Sai lệch kiểu dữ liệu (Incorrect Data Types): Cột ngày đặt hàng hoặc doanh thu thường bị hiểu nhầm là kiểu chuỗi (
object). Nguyên nhân do lẫn ký tự tiền tệ$, dấu phẩy hoặc dòng chữ ghi chú.
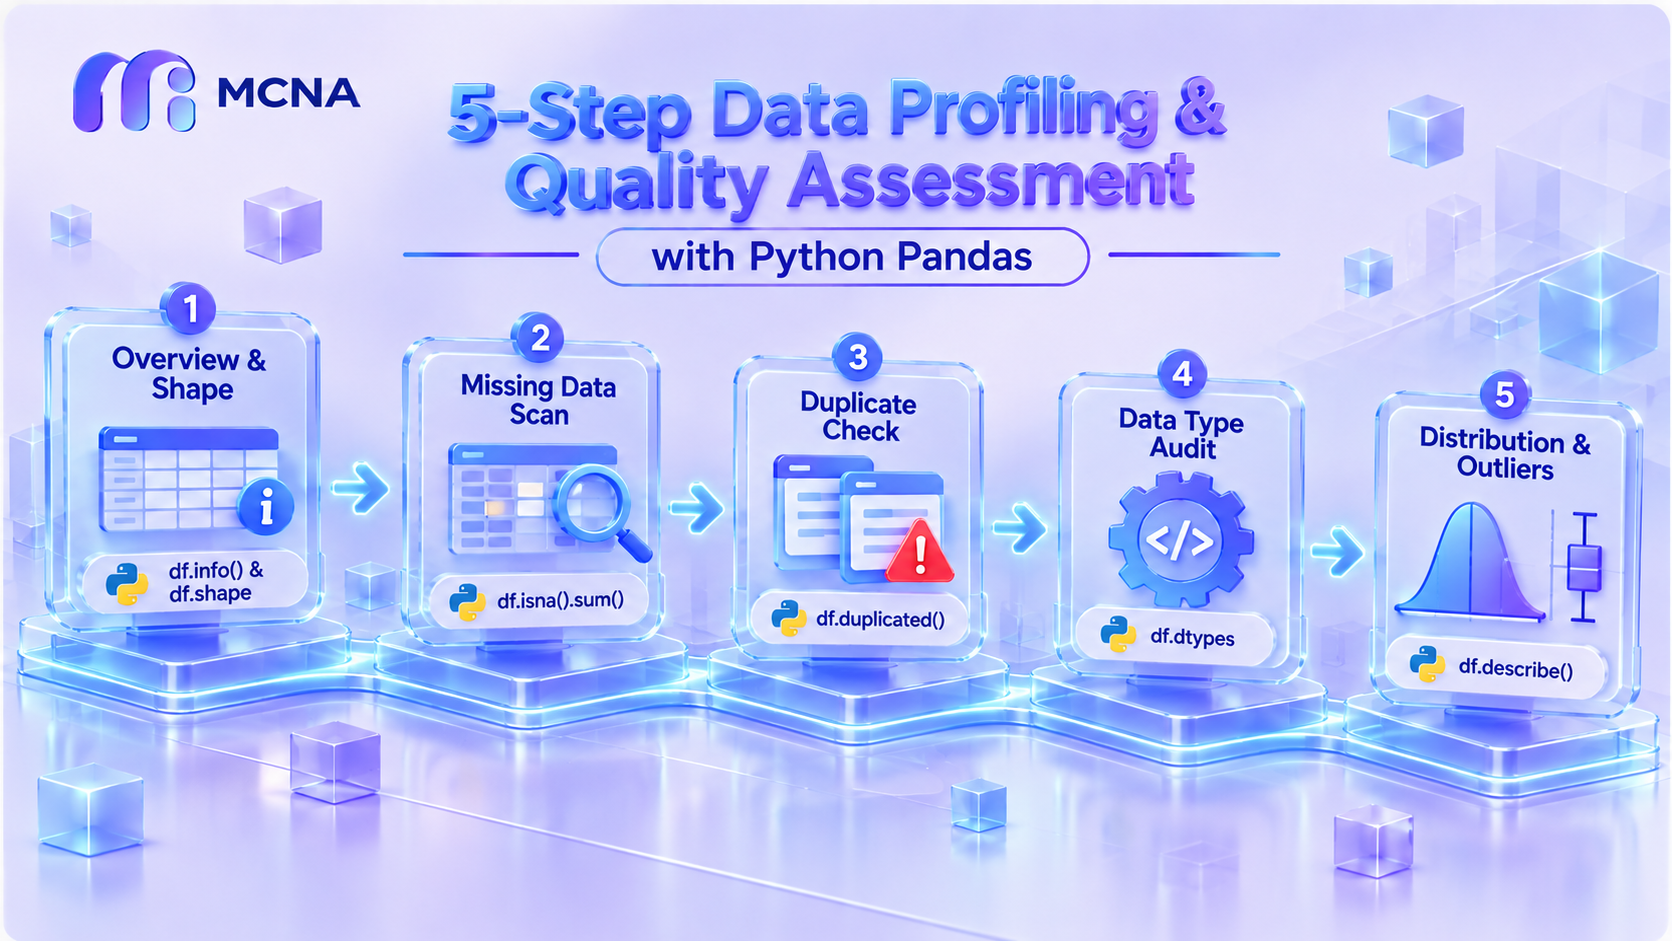
2. Quy trình 5 bước kiểm tra chất lượng dữ liệu đầu vào (Data Profiling)
Trước khi viết bất kỳ dòng lệnh chỉnh sửa nào, nguyên tắc bắt buộc là phải chẩn đoán hiện trạng của DataFrame (Data Quality Assessment). Dưới đây là tổ hợp 5 bước kiểm tra tiêu chuẩn trong Pandas:
3. Các phương thức làm sạch và chuẩn hóa cốt lõi trong Pandas
3.1 Xử lý giá trị khuyết thiếu: Khi nào dùng dropna() và khi nào dùng fillna()?
Khi phát hiện ô trống (NaN), bạn đứng trước hai lựa chọn: xóa bỏ bản ghi đó bằng dropna() hoặc điền giá trị thay thế bằng fillna(). Quyết định đúng đắn phải dựa trên ý nghĩa nghiệp vụ của từng cột dữ liệu:
| Phương thức | Cú pháp tiêu chuẩn | Kịch bản áp dụng trong thực tế |
|---|---|---|
| dropna() | df.dropna(subset=[‘order_id’]) | Dùng khi bị khuyết thiếu ở cột khóa định danh bắt buộc (như order_id, customer_id) hoặc tỷ lệ dòng thiếu rất nhỏ (< 2%). |
| fillna() (Hằng số) | df[‘city’].fillna(‘Chưa rõ’) | Áp dụng cho biến phân loại (Categorical) để giữ lại giao dịch trong tổng doanh thu nhưng tách riêng nhóm chưa rõ thông tin. |
| fillna() (Thống kê) | df[‘col’].fillna(df[‘col’].median()) | Áp dụng cho biến định lượng. Ưu tiên dùng trung vị (median) khi dữ liệu bị lệch (skewed) hoặc có ngoại lai; dùng trung bình (mean) khi phân phối chuẩn. |
| ffill() / bfill() | df[‘price’].ffill() | Lấy giá trị liền trước điền cho dòng sau. Rất hiệu quả với chuỗi thời gian (Time Series) như tỷ giá, tồn kho theo ngày. |
3.2 Loại bỏ bản ghi trùng lặp chuẩn xác với drop_duplicates()
Hàm drop_duplicates() cho phép khử các dòng bị lặp dựa trên toàn bộ cột hoặc một nhóm cột khóa chính thông qua tham số subset và keep:
3.3 Chuẩn hóa chuỗi văn bản với .str.strip(), .str.lower() và Regex
Thuộc tính accessor .str trong Pandas giúp bạn thực hiện các thao tác xử lý chuỗi đồng loạt (vectorized string operations) trên toàn bộ cột mà không cần dùng vòng lặp for chậm chạp:
3.4 Ép kiểu dữ liệu an toàn với astype() và pd.to_datetime()
Sau khi đã làm sạch các ký tự rác, bước tiếp theo là chuyển đổi cột về đúng kiểu dữ liệu nguyên bản để phục vụ tính toán số học và phân tích chuỗi thời gian:
4. Thực hành thực chiến: Làm sạch bộ dữ liệu khách hàng và lịch sử đơn hàng
4.1 Bối cảnh nghiệp vụ & Bộ dữ liệu thô ban đầu
Giả sử phòng Kinh doanh gửi cho bạn một tập dữ liệu xuất từ hệ thống quản lý đơn hàng gồm 6 bản ghi mẫu nhưng chứa đầy đủ các lỗi điển hình. Yêu cầu đặt ra là làm sạch hoàn toàn bảng dữ liệu này trước khi đưa vào báo cáo tổng hợp doanh thu tháng.
1. Khử dòng thiếu mã đơn hàng (
None) và dòng bị ghi đè trùng lặp (ORD-102).2. Chuẩn hóa tên khách hàng về dạng viết hoa chữ cái đầu, xóa khoảng trắng thừa.
3. Đồng bộ số điện thoại về chuỗi 10 chữ số chuẩn (thêm số 0 ở đầu nếu thiếu, xóa dấu gạch ngang/chấm).
4. Tách bỏ ký hiệu tiền tệ
$, dấu phẩy và điền giá trị trung vị cho ô doanh thu bị khuyết thiếu.Bảng dữ liệu thô trước khi làm sạch (raw_orders):
| order_id | customer_name | phone | order_date | raw_revenue | status |
|---|---|---|---|---|---|
| ORD-101 | nguyen van an | 0981-234-567 | 2026-05-10 | $1,200.00 | delivered |
| ORD-102 | TRAN THI BINH | 912.345.678 | 2026/05/11 | $800.00 | COMPLETED |
| ORD-102 (Trùng) | TRAN THI BINH | 912.345.678 | 2026/05/11 | $800.00 | COMPLETED |
| ORD-103 | NaN (Trống) | 0905 111 222 | 2026-05-12 | NaN (Trống) | Pending |
| None (Lỗi ID) | le minh cuong | 0933444555 | 2026-05-13 | $500.00 | cancelled |
4.2 Viết script Python làm sạch từng bước và đóng gói hàm Pipeline
Dưới đây là mã nguồn Python hoàn chỉnh kết hợp tất cả các phương thức đã học để xử lý triệt để bảng dữ liệu trên:
Đóng gói toàn bộ logic làm sạch vào hàm Pipeline tự động
4.3 Đối chiếu kết quả dữ liệu sau chuẩn hóa
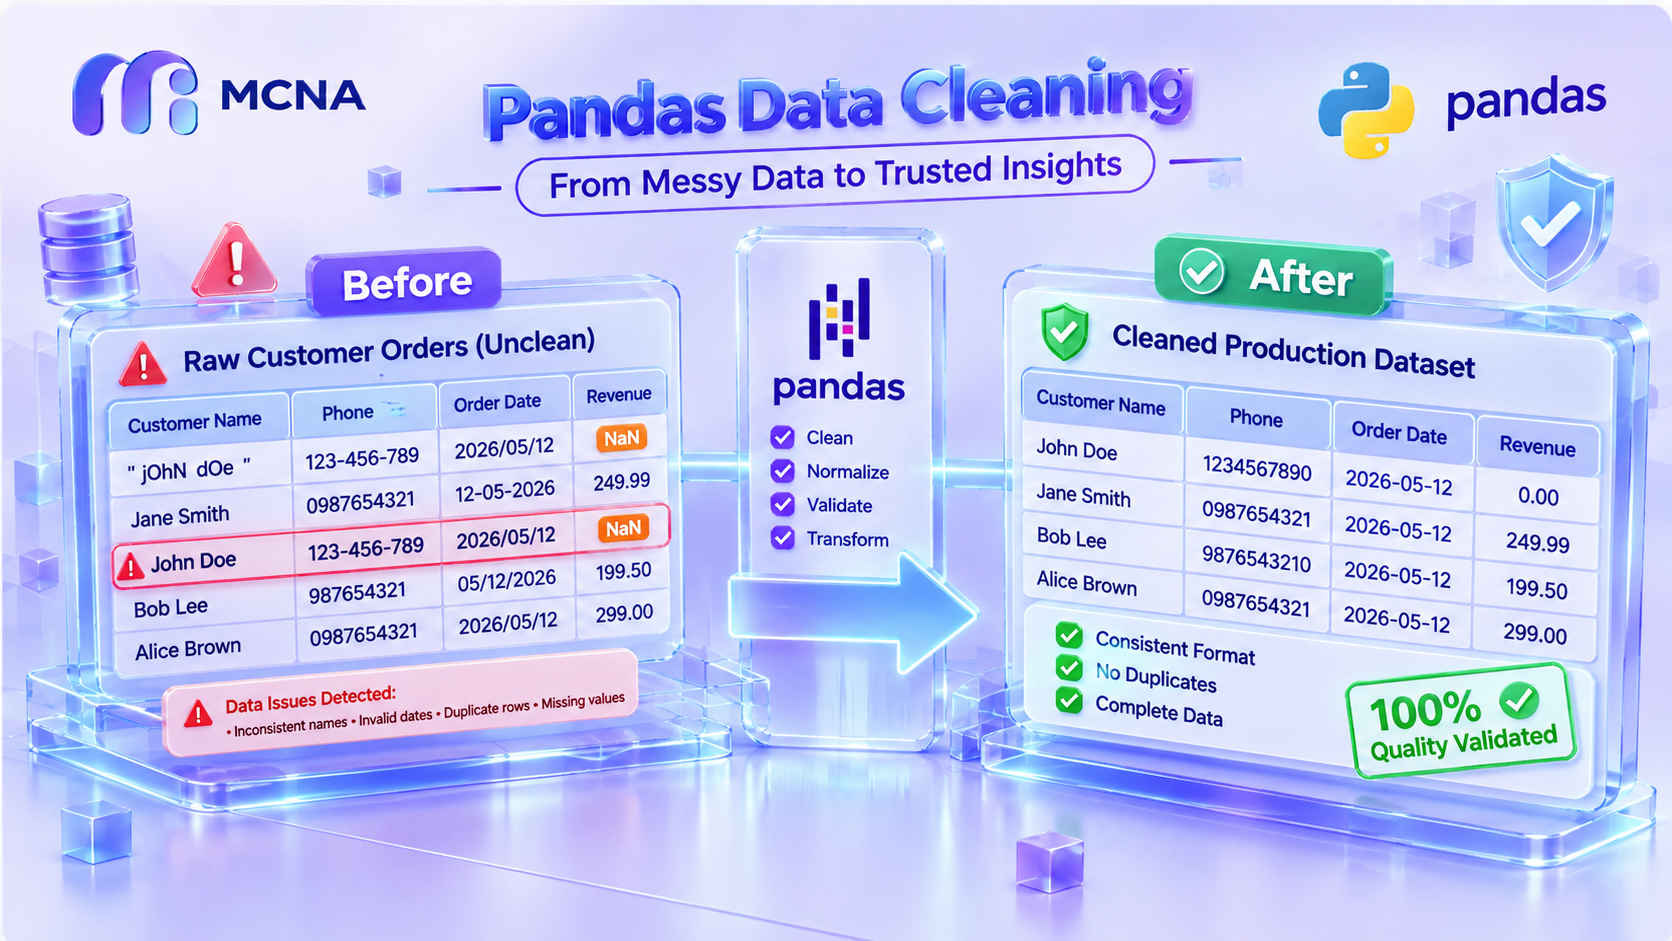
Sau khi chạy qua hàm clean_customer_orders(), hai dòng lỗi đã được loại bỏ hoàn toàn. Đó là đơn trùng ORD-102 và dòng hoàn toàn rỗng. Ô doanh thu trống của đơn ORD-103 được điền tự động bằng số trung vị (1,000.00). Kết quả trả về bảng dữ liệu sạch chuẩn mực:
Kết quả bảng dữ liệu sạch đầu ra (Cleaned DataFrame):
| order_id | customer_name | phone | order_date | revenue (float64) | status |
|---|---|---|---|---|---|
| ORD-101 | Nguyen Van An | 0981234567 | 2026-05-10 | 1,200.0 | Completed |
| ORD-102 | Tran Thi Binh | 0912345678 | 2026-05-11 | 800.0 | Completed |
| ORD-103 | Khách Hàng Vãng Lai | 0905111222 | 2026-05-12 | 1,000.0 | Pending |
5. Best Practices & 5 Lỗi kinh điển cần tránh khi dùng Pandas
❌ Lỗi 1: Cảnh báo SettingWithCopyWarning khi sửa dữ liệu trên bảng lọc
🔍 Nguyên nhân: Pandas không xác định được tập dữ liệu lọc ra là bản sao độc lập (Copy) hay chỉ là tham chiếu bộ nhớ (View) tới bảng gốc.
🔧 Cách xử lý: Luôn gắn thêm
.copy() khi tách bảng con (ví dụ: df_active = df[df['status'] == 'Active'].copy()) hoặc dùng df.loc[row_indexer, col_indexer] = val.❌ Lỗi 2: Lạm dụng tham số inplace=True làm gãy chuỗi xử lý
None khi gán df = df.dropna(inplace=True).🔍 Nguyên nhân: Khi bật
inplace=True, hàm sẽ sửa trực tiếp đối tượng và trả về None. Đồng thời, từ phiên bản Pandas 2.0+ hướng tới 3.0 (Copy-on-Write), tham số này đang dần bị loại bỏ.🔧 Cách xử lý: Không dùng
inplace=True; hãy luôn dùng phép gán tường minh: df = df.dropna().❌ Lỗi 3: Gọi astype(int) trực tiếp lên cột đang chứa giá trị NaN hoặc ký tự lạ
🔍 Nguyên nhân: Kiểu số nguyên chuẩn của NumPy (
int32, int64) không hỗ trợ lưu giá trị NaN.🔧 Cách xử lý: Hãy xử lý sạch giá trị
NaN bằng fillna() trước khi ép kiểu, hoặc sử dụng kiểu dữ liệu Nullable Integer của Pandas là astype('Int64') (chữ I viết hoa).❌ Lỗi 4: Mất số 0 ở đầu cột Số điện thoại hoặc Mã bưu chính (Zip Code)
0981234567 bị biến thành số nguyên 981234567 ngay sau khi đọc file CSV.🔍 Nguyên nhân: Hàm
pd.read_csv() tự động suy luận cột toàn chữ số là kiểu số nguyên (integer) nên cắt bỏ số 0 vô nghĩa ở đầu.🔧 Cách xử lý: Chỉ định rõ kiểu chuỗi ngay lúc đọc file:
pd.read_csv('file.csv', dtype={'phone': str, 'zip_code': str}).❌ Lỗi 5: Gọi df.dropna() toàn bảng không kèm tham số subset
df.dropna().🔍 Nguyên nhân: Mặc định
df.dropna() sẽ xóa toàn bộ dòng nếu có bất kỳ 1 cột nào bị trống (kể cả cột phụ như ghi_chu hay ma_giam_gia).🔧 Cách xử lý: Luôn truyền danh sách các cột trọng yếu vào tham số
subset: df.dropna(subset=['order_id', 'customer_id']).6. Tài liệu tham khảo
| • |
– Tài liệu kỹ thuật chính thức từ Pandas về xử lý giá trị khuyết thiếu (NA/NaN), các phương thức dropna và fillna.
|
| • |
– Hướng dẫn thực hành làm sạch chuỗi văn bản với các phương thức .str, biểu thức chính quy (Regex) và chuẩn hóa kiểu chữ.
|
Nâng cao tư duy lập trình, xử lý dữ liệu và làm chủ công nghệ AI cùng các chương trình đào tạo chuyên sâu:
|
BI & AI Analytics
Combo 5 Khóa AI & Power BI
Làm chủ tư duy phân tích dữ liệu, tự động hóa xử lý và xây dựng báo cáo quản trị thông minh với Power BI và AI.
|
Python Data & Automation
Combo Python Chuyên Sâu
Từ nền tảng lập trình đến phân tích dữ liệu thực chiến, xây dựng data pipeline và ứng dụng học máy vào kinh doanh.
|