AI Agent Memory Optimization: Context Compression, Memory Pruning & Retrieval Efficiency
Trong các hệ thống AI Agent, bộ nhớ không chỉ đơn giản là nơi lưu lại những gì người dùng đã nói. Memory còn giúp Agent duy trì trạng thái công việc, ghi nhớ quyết định trước đó, sử dụng kinh nghiệm từ những phiên làm việc cũ và thực hiện các tác vụ kéo dài qua nhiều bước.
Tuy nhiên, khi một AI Agent hoạt động trong thời gian dài, lượng dữ liệu cần quản lý có thể tăng rất nhanh. Lịch sử hội thoại, kết quả truy vấn, phản hồi từ tools, tài liệu tham khảo và các bản ghi trung gian có thể khiến context ngày càng lớn.
Việc đưa toàn bộ dữ liệu vào mỗi lần gọi LLM gây lãng phí token, tăng độ trễ và khiến những thông tin quan trọng bị chìm giữa lượng dữ liệu không cần thiết.
Đây là lý do AI Agent Memory Optimization trở thành một thành phần quan trọng trong thiết kế hệ thống AI Agent hiện đại.
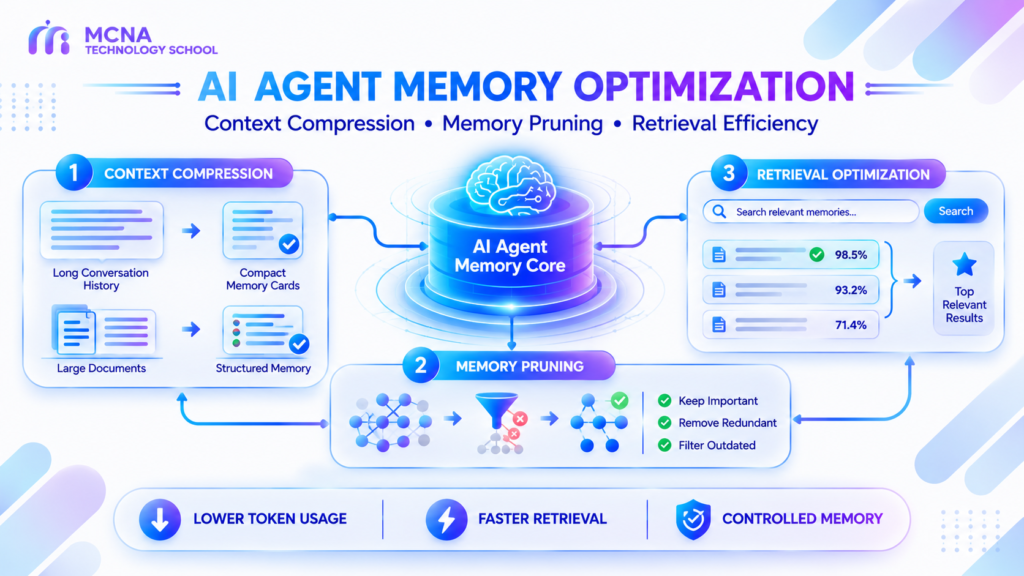
Trong bài viết này, chúng ta sẽ tìm hiểu ba nhóm kỹ thuật chính:
- Context Compression: Nén lịch sử và thông tin thành biểu diễn ngắn gọn hơn.
- Memory Pruning: Loại bỏ những memory không còn hữu ích hoặc bị trùng lặp.
- Retrieval Optimization: Truy xuất đúng thông tin cần thiết thay vì lấy toàn bộ dữ liệu.
1. Vì sao AI Agent cần tối ưu bộ nhớ?
1.1. Context Growth – Context ngày càng phình to
Mỗi lần AI Agent thực hiện một tác vụ, hệ thống có thể tạo thêm nhiều dữ liệu:
- Input từ người dùng.
- Phản hồi của LLM.
- Kết quả gọi API hoặc tool.
- Kết quả tìm kiếm tài liệu.
- Các quyết định và trạng thái trung gian.
- Thông tin được lưu vào long-term memory.
Giả sử một Agent hỗ trợ phân tích dữ liệu. Trong một phiên làm việc, Agent có thể đọc nhiều file CSV, chạy SQL, gọi API, phát hiện lỗi và tạo báo cáo. Nếu toàn bộ lịch sử được giữ nguyên và gửi lại cho LLM ở mỗi bước, context sẽ liên tục tăng lên.
Ví dụ minh họa:
| Thành phần | Token ước tính |
|---|---|
| System prompt và hướng dẫn | 1.000 |
| Lịch sử hội thoại | 8.000 |
| Kết quả tools | 12.000 |
| Tài liệu được truy xuất | 15.000 |
| Tổng cộng | 36.000 |
Đây là ví dụ giả định để minh họa cách context tăng lên, không phải mức tiêu thụ cố định của mọi Agent.
1.2. Những vấn đề khi không tối ưu Memory
| Vấn đề | Nguyên nhân | Hệ quả |
|---|---|---|
| Token Cost tăng | Gửi lại quá nhiều lịch sử và dữ liệu | Chi phí inference cao hơn |
| Latency tăng | LLM phải xử lý context lớn | Phản hồi chậm hơn |
| Retrieval Noise | Lấy quá nhiều memory không liên quan | Thông tin quan trọng bị nhiễu |
| Context Overflow | Dữ liệu vượt ngân sách context | Phải cắt bớt hoặc không thể xử lý |
| Information Loss | Nén hoặc xóa memory không đúng cách | Agent có thể quên dữ kiện quan trọng |
Vì vậy, mục tiêu không phải là lưu càng nhiều memory càng tốt. Mục tiêu là đưa đúng thông tin vào đúng thời điểm với chi phí hợp lý.
2. Tổng quan kiến trúc Memory Optimization
Một hệ thống tối ưu memory có thể được thiết kế theo luồng sau:
User Input
    |
    v
Intent Detection
    |
    v
Memory Retrieval
    |
    v
Relevance Filtering
    |
    v
Context Compression
    |
    v
Token Budget Allocation
    |
    v
LLM / AI Agent
    |
    v
Response + New Experience
    |
    v
Memory Update
    |
    v
Deduplication / Consolidation / Pruning
    |
    v
Memory Storage
Luồng này gồm hai quá trình liên kết với nhau:
- Read Path: Tìm kiếm, lọc và nén memory trước khi đưa vào LLM.
- Write Path: Đánh giá, hợp nhất, cập nhật hoặc loại bỏ memory sau khi Agent hoàn thành tác vụ.
Điểm quan trọng là memory optimization không chỉ diễn ra khi lưu dữ liệu. Một hệ thống có thể lưu trữ hàng triệu bản ghi nhưng vẫn hoạt động hiệu quả nếu chỉ truy xuất đúng phần cần thiết.
3. Context Compression – Nén ngữ cảnh
3.1. Context Compression là gì?
Context Compression là quá trình giảm số lượng token của thông tin đầu vào trong khi cố gắng giữ lại những dữ kiện cần thiết cho nhiệm vụ hiện tại.
Thay vì gửi toàn bộ lịch sử hội thoại, Agent có thể chuyển lịch sử thành một bản tóm tắt có cấu trúc.
Ví dụ, lịch sử hội thoại ban đầu:
User: Tôi đang xây dựng hệ thống phân tích dữ liệu ngân hàng.
Assistant: Bạn đang sử dụng công nghệ nào?
User: Tôi dùng Python, PostgreSQL và Power BI.
Assistant: Mục tiêu của hệ thống là gì?
User: Tôi muốn xây dựng pipeline ETL, lưu dữ liệu vào database và tạo báo cáo.
User: Tôi cũng muốn pipeline có thể chạy lại khi gặp lỗi.
Assistant: Vậy chúng ta cần thiết kế cơ chế logging và retry.
Sau khi nén thành memory có cấu trúc:
{
  "project": "Bank Data Analytics",
  "tools": [
    "Python",
    "PostgreSQL",
    "Power BI"
  ],
  "objectives": [
    "Build ETL pipeline",
    "Store data in PostgreSQL",
    "Create analytical reports",
    "Support retry and logging"
  ]
}
Thông tin được chuyển từ hội thoại tự nhiên sang biểu diễn ngắn gọn, dễ truy xuất và dễ cập nhật hơn.
3.2. Các phương pháp Context Compression
A. Extractive Compression
Extractive Compression chọn lọc những câu hoặc đoạn thông tin quan trọng từ dữ liệu gốc mà không viết lại nội dung.
Ví dụ:
Original:
- User uses Python for ETL.
- User uses PostgreSQL as database.
- User uses Power BI for reporting.
- User wants pipeline retry functionality.
- User discussed an unrelated movie recommendation.

Extracted:
- Python: ETL
- PostgreSQL: database
- Power BI: reporting
- Requirement: retry functionality
Ưu điểm:
- Giảm nguy cơ làm sai lệch ý nghĩa vì giữ lại nội dung gốc.
- Dễ kiểm tra nguồn thông tin.
- Phù hợp với các dữ kiện quan trọng như số liệu, tên bảng và quy tắc nghiệp vụ.
Hạn chế: Nếu dữ liệu gốc dài hoặc có nhiều cách diễn đạt khác nhau, việc trích xuất có thể chưa loại bỏ được toàn bộ phần dư thừa.
B. Abstractive Compression
Abstractive Compression sử dụng mô hình ngôn ngữ để diễn đạt lại thông tin thành một bản tóm tắt ngắn hơn.
Ví dụ:
Original:
The user is building a bank analytics platform.
Python is used to extract and transform transaction data.
PostgreSQL is used to store structured data.
Power BI is used to build dashboards.
The pipeline should support retry and error logging.

Compressed:
Project: Bank Analytics Platform.
Stack: Python, PostgreSQL, Power BI.
Requirements: ETL, dashboards, retry, error logging.
Ưu điểm:
- Có thể hợp nhất nhiều câu có cùng ý nghĩa.
- Tạo memory ngắn gọn, dễ đọc.
- Phù hợp với lịch sử hội thoại dài.
Hạn chế: Mô hình có thể vô tình bỏ sót số liệu, điều kiện hoặc chi tiết quan trọng. Vì vậy, những thông tin có tính quyết định cần được giữ nguyên hoặc kiểm tra lại với dữ liệu gốc.
C. Hierarchical Compression
Hierarchical Compression tổ chức thông tin theo nhiều cấp độ thay vì nén tất cả thành một bản tóm tắt duy nhất.
Memory
|
+-- Level 1: Global Summary
|      +-- User profile
|      +-- Long-term goals
|
+-- Level 2: Project Memory
|      +-- Bank Analytics
|      +-- Recruitment Automation
|
+-- Level 3: Detailed Memory
       +-- Database schema
       +-- ETL configuration
       +-- Error logs
       +-- Execution history
Khi người dùng hỏi về mục tiêu dự án, Agent chỉ cần truy xuất Level 1 hoặc Level 2. Khi cần sửa một câu SQL cụ thể, Agent có thể lấy thêm Level 3.
Cách tổ chức này giúp giảm lượng dữ liệu phải đưa vào context trong mỗi lần xử lý.
3.3. Khi nào nên nén Context?
Không nên nén dữ liệu sau mỗi câu hỏi vì quá trình nén cũng tiêu tốn tài nguyên và có thể làm mất thông tin. Một số điều kiện kích hoạt phổ biến gồm:
- Context đạt một tỷ lệ nhất định so với token budget.
- Số lượng lượt hội thoại vượt ngưỡng.
- Một tác vụ hoặc phiên làm việc đã hoàn thành.
- Có nhiều tool outputs trùng lặp.
- Agent chuyển sang một giai đoạn công việc mới.
Ví dụ, hệ thống có thể kích hoạt compression khi context sử dụng trên 70% ngân sách được phân bổ. Ngưỡng này cần được điều chỉnh theo mô hình, độ dài tác vụ và yêu cầu độ chính xác.
4. Memory Pruning – Loại bỏ Memory không cần thiết
4.1. Memory Pruning là gì?
Memory Pruning là quá trình loại bỏ hoặc giảm mức ưu tiên của những bản ghi không còn cần thiết trong hệ thống memory.
Không phải mọi thông tin từng xuất hiện đều có giá trị lâu dài. Ví dụ:
- Một kết quả tìm kiếm tạm thời chỉ phục vụ một câu hỏi.
- Một bản ghi bị trùng lặp nhiều lần.
- Một trạng thái công việc đã được thay thế.
- Một thông tin đã hết hạn.
- Một dữ kiện không còn liên quan đến mục tiêu hiện tại.
Nếu không có cơ chế pruning, memory store có thể ngày càng lớn và khiến retrieval trả về nhiều dữ liệu nhiễu.
4.2. Các tiêu chí đánh giá Memory
Để quyết định memory nào nên giữ lại, hệ thống có thể tính điểm dựa trên nhiều yếu tố.
| Tiêu chí | Ý nghĩa | Ví dụ |
|---|---|---|
| Importance | Mức độ quan trọng | Quyết định kiến trúc hệ thống |
| Recency | Độ mới của thông tin | Cập nhật gần đây |
| Frequency | Tần suất được sử dụng | Thông tin thường xuyên được truy xuất |
| Relevance | Mức độ liên quan đến nhiệm vụ | Liên quan trực tiếp đến câu hỏi hiện tại |
| Confidence | Độ tin cậy của dữ kiện | Thông tin được xác nhận từ nguồn chính thức |
| Expiration | Thời hạn sử dụng | Trạng thái phiên làm việc đã kết thúc |
4.3. Xây dựng Memory Scoring
Ta có thể xây dựng một công thức điểm ưu tiên đơn giản:
Memory Score = 0.30 × Importance + 0.20 × Recency + 0.20 × Frequency + 0.20 × Relevance + 0.10 × Confidence
Trong đó, các biến được chuẩn hóa về khoảng từ 0 đến 1.
Ví dụ:
| Memory | Importance | Recency | Frequency | Relevance | Confidence |
|---|---|---|---|---|---|
| Database schema | 0.9 | 0.9 | 0.8 | 1.0 | 1.0 |
| Temporary search result | 0.2 | 0.3 | 0.1 | 0.2 | 0.7 |
| Project deadline | 1.0 | 0.9 | 0.5 | 0.9 | 1.0 |
Điểm số chỉ là một heuristic. Trong hệ thống thực tế, trọng số cần được hiệu chỉnh theo dữ liệu và mục tiêu sử dụng.
4.4. Ví dụ triển khai bằng Python
Đoạn code sau minh họa cách tính điểm và lọc memory bằng thư viện chuẩn của Python:
from datetime import datetime, timedelta

def calculate_memory_score(memory):
    score = (
        0.30 * memory["importance"]
        + 0.20 * memory["recency"]
        + 0.20 * memory["frequency"]
        + 0.20 * memory["relevance"]
        + 0.10 * memory["confidence"]
    )

    return score


def prune_memories(memories, threshold=0.45):
    retained = []
    removed = []

    for memory in memories:
        score = calculate_memory_score(memory)

        if score >= threshold:
            memory["score"] = round(score, 3)
            retained.append(memory)
        else:
            removed.append(memory)

    return retained, removed


memories = [
    {
        "content": "Database schema uses PostgreSQL",
        "importance": 0.9,
        "recency": 0.9,
        "frequency": 0.8,
        "relevance": 1.0,
        "confidence": 1.0
    },
    {
        "content": "Temporary search result",
        "importance": 0.2,
        "recency": 0.3,
        "frequency": 0.1,
        "relevance": 0.2,
        "confidence": 0.7
    }
]

retained, removed = prune_memories(memories)

print("Retained memories:")
for item in retained:
    print(item["content"], item["score"])

print("\nRemoved memories:")
for item in removed:
    print(item["content"])
Trong ví dụ này, memory được giữ lại hoặc đưa vào danh sách cần loại bỏ dựa trên threshold. Hệ thống thực tế nên có thêm trạng thái archive hoặc soft delete để tránh xóa vĩnh viễn dữ liệu quan trọng.
4.5. Forgetting không đồng nghĩa với xóa dữ liệu gốc
Đây là một điểm cần phân biệt rõ trong thiết kế memory system:
- Pruning: Loại bỏ memory khỏi tập dữ liệu được ưu tiên truy xuất.
- Archiving: Chuyển memory sang vùng lưu trữ ít được sử dụng hơn.
- Expiration: Đánh dấu dữ liệu hết hạn theo chính sách.
- Deletion: Xóa dữ liệu theo yêu cầu hoặc quy định quản trị dữ liệu.
Không nên sử dụng một cơ chế pruning thông thường để thay thế quy trình xóa dữ liệu theo yêu cầu của người dùng hoặc chính sách bảo mật.
5. Retrieval Optimization – Tối ưu quá trình truy xuất
5.1. Vì sao truy xuất nhiều chưa chắc đã tốt?
Trong hệ thống RAG hoặc long-term memory, Agent thường sử dụng vector search, keyword search hoặc hybrid search để tìm thông tin.
Một cách triển khai đơn giản là lấy Top-K kết quả có similarity cao nhất. Tuy nhiên, nếu K quá lớn, hệ thống có thể đưa nhiều dữ liệu không liên quan vào context.
Ví dụ, khi người dùng hỏi về cấu trúc database, Agent chỉ cần các memory liên quan đến schema, table và relationship. Những nội dung về deadline, email marketing hoặc lịch sử tìm kiếm có thể không cần thiết.
5.2. Các kỹ thuật Retrieval Optimization
A. Query-aware Retrieval
Thay vì truy xuất memory theo một cấu hình cố định, hệ thống phân tích mục đích câu hỏi để điều chỉnh phạm vi tìm kiếm.
| Loại câu hỏi | Phạm vi truy xuất đề xuất |
|---|---|
| Hỏi thông tin cá nhân hoặc sở thích | Profile memory |
| Hỏi trạng thái dự án | Project memory và recent updates |
| Hỏi một lỗi kỹ thuật cụ thể | Error logs và technical memory |
| Hỏi quyết định trước đây | Decision records và historical memory |
B. Hybrid Retrieval
Hybrid Retrieval kết hợp nhiều phương pháp tìm kiếm:
- Keyword Search: Tìm theo từ khóa chính xác.
- Vector Search: Tìm theo mức độ tương đồng ngữ nghĩa.
- Metadata Filtering: Lọc theo project, thời gian, loại dữ liệu hoặc nguồn.
Ví dụ, người dùng hỏi: “Database của dự án ngân hàng đang sử dụng hệ quản trị nào?”
Hệ thống có thể kết hợp:
Query:
"Database của dự án ngân hàng"

Metadata filter:
project = "Bank Analytics"

Keyword search:
database, PostgreSQL, schema

Vector search:
Tìm các memory có ngữ nghĩa liên quan

Final retrieval:
Các bản ghi xác nhận hệ quản trị và cấu trúc database
C. Reranking
Reranking là bước đánh giá lại các kết quả đã truy xuất để đưa những thông tin phù hợp nhất lên đầu.
Luồng xử lý:
User Query
    |
    v
Initial Retrieval (Top 20)
    |
    v
Reranking Model
    |
    v
Relevance Scoring
    |
    v
Select Top 5
    |
    v
Context Construction
    |
    v
LLM
Vector search có thể tìm được những tài liệu gần nghĩa, nhưng không phải kết quả nào cũng trả lời trực tiếp câu hỏi. Reranking giúp ưu tiên những kết quả có liên quan sát hơn.
D. Adaptive Top-K
Thay vì luôn lấy 5 hoặc 10 kết quả, hệ thống điều chỉnh K theo độ phức tạp của câu hỏi.
- Câu hỏi đơn giản: lấy ít memory.
- Câu hỏi cần so sánh nhiều giai đoạn: lấy thêm memory.
- Câu hỏi liên quan nhiều dự án: mở rộng phạm vi truy xuất.
- Câu hỏi có độ tin cậy thấp: tìm thêm bằng chứng hoặc yêu cầu làm rõ.
Adaptive Top-K giúp cân bằng giữa độ đầy đủ thông tin và chi phí context.
6. Token Budget Allocation – Phân bổ ngân sách Context
Một hệ thống Agent thường phải phân bổ context cho nhiều thành phần khác nhau. Nếu không có ngân sách rõ ràng, một nhóm dữ liệu có thể chiếm gần hết context và làm giảm không gian dành cho những thông tin còn lại.
Ví dụ, ngân sách 10.000 token có thể được phân bổ như sau:
| Thành phần | Ngân sách | Tỷ lệ |
|---|---|---|
| System Instructions | 1.000 | 10% |
| Current User Query | 500 | 5% |
| Retrieved Memory | 2.500 | 25% |
| Tool Outputs | 2.000 | 20% |
| Conversation Summary | 1.500 | 15% |
| Reasoning / Working Context | 1.500 | 15% |
| Response Reserve | 1.000 | 10% |
| Total | 10.000 | 100% |
Đây là cách phân bổ minh họa, không phải cấu hình tối ưu cho mọi mô hình. Tỷ lệ cần được điều chỉnh theo đặc điểm tác vụ, giới hạn context và mức độ quan trọng của từng nguồn thông tin.
Một nguyên tắc hữu ích là không cố định toàn bộ ngân sách. Agent nên có khả năng điều chỉnh lượng memory, tool outputs và conversation summary theo yêu cầu thực tế.
7. Kết hợp Compression, Pruning và Retrieval Optimization
Ba kỹ thuật trên giải quyết những vấn đề khác nhau nhưng cần được kết hợp trong cùng một kiến trúc.
| Kỹ thuật | Câu hỏi cần giải quyết | Thời điểm chính |
|---|---|---|
| Context Compression | Làm thế nào biểu diễn thông tin ngắn hơn? | Trước khi đưa dữ liệu vào context |
| Memory Pruning | Thông tin nào không còn cần thiết? | Khi quản lý và cập nhật memory |
| Retrieval Optimization | Thông tin nào cần được lấy ra? | Khi Agent nhận truy vấn |
| Budget Allocation | Dành bao nhiêu token cho từng thành phần? | Khi xây dựng context cuối cùng |
Ví dụ về một quy trình hoàn chỉnh:
- Người dùng yêu cầu Agent tiếp tục dự án phân tích dữ liệu ngân hàng.
- Agent xác định project liên quan và truy xuất memory theo metadata.
- Hệ thống dùng keyword search và vector search để tìm các bản ghi phù hợp.
- Reranker đánh giá lại và chọn những memory có giá trị cao.
- Context compression hợp nhất các thông tin trùng lặp.
- Token budget manager kiểm tra tổng số token.
- LLM nhận context đã tối ưu và tiếp tục thực hiện nhiệm vụ.
- Sau khi hoàn thành, hệ thống cập nhật trạng thái và lưu các quyết định mới.
- Deduplication và pruning được thực hiện theo chính sách memory.
8. Xây dựng một Memory Optimizer đơn giản bằng Python
Để hiểu rõ cách các kỹ thuật phối hợp với nhau, chúng ta có thể xây dựng một phiên bản Memory Optimizer nhỏ bằng Python. Ví dụ này không sử dụng LLM hoặc vector database, mà tập trung minh họa các nguyên tắc xử lý dữ liệu.
8.1. Chuẩn bị dữ liệu
memories = [
    {
        "id": 1,
        "project": "Bank Analytics",
        "content": "The project uses PostgreSQL.",
        "importance": 0.9,
        "relevance": 0.9,
        "frequency": 0.8,
        "recency": 0.9
    },
    {
        "id": 2,
        "project": "Bank Analytics",
        "content": "PostgreSQL is used by the project.",
        "importance": 0.8,
        "relevance": 0.9,
        "frequency": 0.7,
        "recency": 0.8
    },
    {
        "id": 3,
        "project": "Marketing",
        "content": "The campaign used Brevo.",
        "importance": 0.5,
        "relevance": 0.1,
        "frequency": 0.2,
        "recency": 0.5
    },
    {
        "id": 4,
        "project": "Bank Analytics",
        "content": "The ETL pipeline must support retry.",
        "importance": 1.0,
        "relevance": 1.0,
        "frequency": 0.8,
        "recency": 1.0
    }
]
8.2. Xây dựng hàm chấm điểm
def memory_score(memory):
    return (
        0.35 * memory["importance"]
        + 0.30 * memory["relevance"]
        + 0.20 * memory["frequency"]
        + 0.15 * memory["recency"]
    )
8.3. Lọc theo project và relevance
def retrieve_memories(memories, project, min_score=0.5):
    results = []

    for memory in memories:
        if memory["project"] != project:
            continue

        score = memory_score(memory)

        if score >= min_score:
            results.append({
                "id": memory["id"],
                "content": memory["content"],
                "score": round(score, 3)
            })

    results.sort(
        key=lambda item: item["score"],
        reverse=True
    )

    return results
8.4. Loại bỏ nội dung trùng lặp đơn giản
Trong ví dụ này, chúng ta chuẩn hóa chuỗi trước khi so sánh. Đây chỉ là cách phát hiện trùng lặp chính xác sau chuẩn hóa, chưa phải semantic deduplication.
def normalize_text(text):
    return " ".join(text.lower().strip().split())


def remove_exact_duplicates(memories):
    unique_memories = []
    seen = set()

    for memory in memories:
        normalized = normalize_text(memory["content"])

        if normalized not in seen:
            seen.add(normalized)
            unique_memories.append(memory)

    return unique_memories
8.5. Kết hợp thành một pipeline
def optimize_memory(
    memories,
    project,
    min_score=0.5
):
    # Step 1: Retrieve relevant memories
    retrieved = retrieve_memories(
        memories,
        project,
        min_score
    )

    # Step 2: Remove exact duplicates
    optimized = remove_exact_duplicates(retrieved)

    # Step 3: Return optimized context
    return optimized


optimized_memory = optimize_memory(
    memories,
    project="Bank Analytics"
)

for memory in optimized_memory:
    print(memory)
Kết quả mong đợi là các memory thuộc dự án Bank Analytics được ưu tiên, bản ghi không liên quan bị loại khỏi kết quả truy xuất và những nội dung trùng lặp chính xác được giảm bớt.
Để triển khai production, hệ thống cần bổ sung semantic deduplication, versioning, nguồn gốc dữ liệu, thời gian hiệu lực, kiểm soát quyền truy cập và quy trình phục hồi khi compression gây mất thông tin.
9. Đánh giá hiệu quả Memory Optimization
Không thể kết luận một hệ thống tốt hơn chỉ vì nó sử dụng ít token hơn. Nếu memory bị nén quá mức và Agent trả lời sai, việc tiết kiệm token không còn ý nghĩa.
Do đó, cần đánh giá đồng thời chất lượng, hiệu suất và chi phí.
| Metric | Ý nghĩa |
|---|---|
| Token Reduction Rate | Tỷ lệ token giảm sau compression |
| Retrieval Precision | Tỷ lệ kết quả truy xuất thực sự liên quan |
| Retrieval Recall | Tỷ lệ thông tin liên quan được tìm thấy |
| Answer Accuracy | Độ chính xác của câu trả lời cuối cùng |
| Latency | Thời gian xử lý truy vấn |
| Memory Storage Size | Dung lượng memory được lưu trữ |
| Cost per Task | Chi phí trung bình cho một nhiệm vụ |
9.1. Token Reduction Rate
Công thức:
Token Reduction Rate = (Original Tokens - Compressed Tokens) / Original Tokens × 100%
Ví dụ:
- Context ban đầu: 10.000 tokens.
- Context sau compression: 4.000 tokens.
- Token Reduction Rate: 60%.
9.2. Retrieval Precision và Recall
Precision đo tỷ lệ kết quả được truy xuất có liên quan. Recall đo tỷ lệ thông tin liên quan thực sự được tìm thấy.
Precision = Relevant Retrieved / Total Retrieved
Recall = Relevant Retrieved / Total Relevant
Nếu chỉ tối ưu Precision, hệ thống có thể trả về rất ít memory và bỏ sót dữ kiện quan trọng. Nếu chỉ tối ưu Recall, hệ thống có thể lấy quá nhiều memory không cần thiết. Vì vậy, cần theo dõi cả hai chỉ số.
9.3. Cost per Task
Chi phí nên được đo trên toàn bộ tác vụ, không chỉ một lần gọi LLM.
Total Cost = Input Token Cost + Output Token Cost + Retrieval Cost + Storage Cost + Tool Cost
Compression có thể làm giảm input token nhưng lại phát sinh chi phí cho bước tóm tắt. Do đó, cần đo tổng chi phí trước và sau tối ưu.
9.4. So sánh trước và sau tối ưu
| Metric | Before | After |
|---|---|---|
| Input tokens | 10.000 | 4.000 |
| Retrieval results | 20 | 5 |
| Latency | 3.5 giây | 2.1 giây |
| Answer Accuracy | 92% | 91% |
| Cost per task | 100% | 55% |
Các con số trên hoàn toàn mang tính minh họa. Trong thực tế, cần chạy benchmark trên cùng một tập truy vấn, cùng mô hình, cùng điều kiện và nhiều lần thử để có kết luận đáng tin cậy.
10. Những rủi ro cần lưu ý
10.1. Over-compression
Nén quá mạnh có thể làm mất các điều kiện, ngoại lệ hoặc mối quan hệ giữa các sự kiện. Ví dụ, memory “Database chuyển từ MySQL sang PostgreSQL từ tháng 8” không nên bị nén thành “Database sử dụng PostgreSQL” nếu Agent vẫn cần biết lịch sử thay đổi.
10.2. Sai lệch do tóm tắt
Abstractive compression có thể tạo ra thông tin không tồn tại trong dữ liệu gốc. Những thông tin quan trọng cần lưu kèm nguồn, timestamp và trạng thái xác minh.
10.3. Xóa nhầm Memory quan trọng
Memory ít được truy xuất không nhất thiết là memory vô dụng. Một quyết định kiến trúc có thể chỉ cần sử dụng một lần nhưng vẫn rất quan trọng trong tương lai.
10.4. Retrieval quá phụ thuộc Similarity Score
Similarity score cao không đồng nghĩa với thông tin chính xác hoặc còn hiệu lực. Hệ thống cần kết hợp metadata, thời gian, nguồn dữ liệu và trạng thái cập nhật.
10.5. Mất khả năng truy vết
Khi memory được hợp nhất hoặc nén, cần giữ liên kết đến dữ liệu nguồn. Nếu không, việc kiểm tra vì sao Agent đưa ra một quyết định sẽ trở nên khó khăn.
11. Best Practices khi thiết kế Memory Optimization
- Không lưu toàn bộ hội thoại vào long-term memory một cách mặc định.
- Phân biệt raw history, structured memory và compressed summary.
- Giữ lại nguồn gốc, timestamp và phiên bản của memory.
- Ưu tiên metadata filtering trước khi thực hiện semantic retrieval.
- Sử dụng reranking khi có nhiều kết quả tương đồng.
- Thiết lập token budget cho từng thành phần của context.
- Không xóa vĩnh viễn dữ liệu chỉ dựa trên một điểm importance đơn lẻ.
- Đánh giá cả token cost, latency và answer accuracy.
- Thiết kế cơ chế phục hồi từ dữ liệu gốc khi summary bị sai.
- Kiểm soát quyền truy cập và thời hạn lưu trữ theo chính sách dữ liệu.
12. Kết luận
AI Agent Memory Optimization không đơn thuần là giảm dung lượng dữ liệu. Đây là bài toán phân bổ thông tin: dữ liệu nào cần giữ, dữ liệu nào cần nén, dữ liệu nào nên loại khỏi luồng truy xuất và thông tin nào cần được đưa vào context ở từng thời điểm.
Ba kỹ thuật cốt lõi có vai trò bổ trợ cho nhau:
- Context Compression giúp giảm kích thước thông tin.
- Memory Pruning giúp kiểm soát dữ liệu dư thừa và lỗi thời.
- Retrieval Optimization giúp Agent truy xuất đúng dữ kiện cần thiết.
Khi kết hợp với Token Budget Allocation và hệ thống đánh giá phù hợp, các kỹ thuật này giúp AI Agent hoạt động hiệu quả hơn trong những tác vụ dài hạn mà vẫn duy trì chất lượng xử lý.
Trong thực tế, một hệ thống memory tốt không phải hệ thống nhớ mọi thứ. Đó là hệ thống biết khi nào cần ghi nhớ, khi nào cần truy xuất và khi nào không cần đưa một thông tin vào context.
Tài liệu tham khảo
- Context Compression for LLM Agents: A Survey of Methods, Failure Modes, and Evaluation – EMNLP 2026
- SimpleMem: Efficient Lifelong Memory for LLM Agents – ICML 2026
- SCOPE: Stratum-Coordinated Optimization Pipeline for Efficient Agent Context – EMNLP 2026
- Memory for Autonomous LLM Agents: Mechanisms, Evaluation, and Emerging Frontiers
- Managing Memory for AI Agents – Redis
Nếu bạn muốn xây dựng nền tảng kiến thức về Python, dữ liệu và AI để phát triển các hệ thống ứng dụng thực tế, có thể tham khảo các chương trình học tại MCNA Technology School.