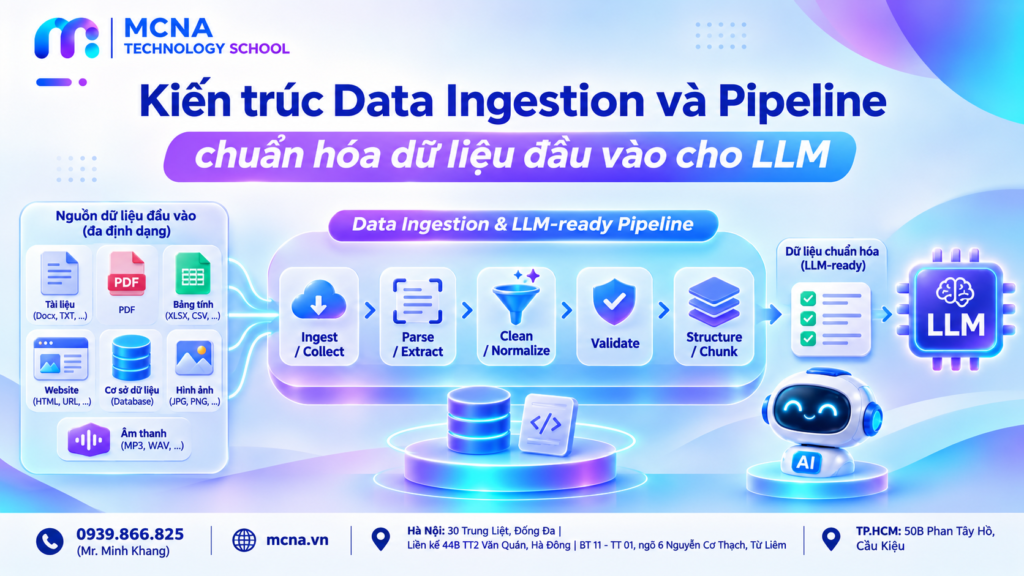
Trong hệ sinh thái trí tuệ nhân tạo, hiệu năng của mô hình ngôn ngữ lớn (LLM) không chỉ phụ thuộc vào số lượng tham số. Nó còn chịu chi phối tuyệt đối bởi chất lượng dữ liệu đầu vào. Mô hình tiên tiến đến đâu cũng sẽ sụp đổ nếu tiếp nhận nguồn dữ liệu nhiễu loạn. Tại MCNA Technology School, chúng tôi giải mã kiến trúc Data Ingestion và pipeline chuẩn hóa. Đây là chìa khóa biến đổi dữ liệu thô thành nguồn tri thức thuần khiết cho hệ thống RAG.
Pipeline chuẩn hóa dữ liệu chính là bộ lọc sinh tử. Nếu khâu này lỏng lẻo, toàn bộ các tầng phía sau như embedding hay vector database sẽ bị ô nhiễm dữ liệu, gây ra hiện tượng ảo giác (hallucination) nghiêm trọng.
1. Giải Mã Kiến Trúc Data Ingestion Trong Hệ Thống LLM
Data Ingestion không đơn thuần là sao chép tệp tin. Đó là một quá trình tự động hóa phức tạp nhằm trích xuất, định hình và dẫn dắt dòng chảy dữ liệu từ vô số nguồn phân tán vào trung tâm xử lý của AI.
Sơ đồ dưới đây phác họa bức tranh toàn cảnh của một pipeline chuẩn hóa dữ liệu tiêu chuẩn tại các hệ thống AI hiện đại:
[ Raw Data Sources ]
(PDF, Web, API, SQL)
        │
        ▼
┌────────────────────────┐
│     Data Ingestion     │ ──► Thu thập, định dạng thô
└────────────────────────┘
        │
        ▼
┌────────────────────────┐
│    Data Cleaning       │ ──► Loại bỏ nhiễu, chuẩn hóa ký tự
└────────────────────────┘
        │
        ▼
┌────────────────────────┐
│   Semantic Chunking    │ ──► Cắt khúc ngữ nghĩa văn bản
└────────────────────────┘
        │
        ▼
┌────────────────────────┐
│ Vector Embedding Engine│ ──► Chuyển đổi thành vector số học
└────────────────────────┘
        │
        ▼
[ Vector Database / LLM Core ]
2. Các Chiến Lược Thu Thập Dữ Liệu Thô (Raw Data Collection)
Tùy thuộc vào đặc thù của nguồn tài nguyên, kỹ sư dữ liệu sẽ thiết kế phương thức thu thập tối ưu nhằm đảm bảo tính toàn vẹn và độ tươi mới của thông tin:
Thu thập dữ liệu theo lô định kỳ, chẳng hạn như quét cơ sở dữ liệu kho hàng vào cuối ngày. Phù hợp với tập dữ liệu ít biến động thời gian thực.
Thu thập dữ liệu dòng thời gian thực qua Apache Kafka hoặc Webhook. Cực kỳ thích hợp cho hệ thống chatbot chăm sóc khách hàng trực tuyến.
Tự động bóc tách tài liệu kỹ thuật từ các cổng thông tin công khai để làm nền tảng tri thức cho trợ lý ảo doanh nghiệp.
3. Vận Hành Pipeline Làm Sạch Dữ Liệu (Data Cleaning & Normalization)
Dữ liệu thô luôn chứa đầy rác kỹ thuật như thẻ HTML thừa, ký tự điều khiển hay lỗi chính tả. Nếu nạp thẳng vào LLM, chúng sẽ làm loãng ngữ cảnh và ngốn sạch khoảng không gian của bộ nhớ context window.
Quá trình làm sạch đòi hỏi sự tinh tế khi phải bảo toàn các dấu câu cấu trúc như dấu chấm hay dấu phẩy. Chúng đóng vai trò là ranh giới ngữ nghĩa giúp mô hình không bị hiểu sai bản chất câu lệnh.
Bảng đối chiếu dưới đây làm rõ sự thay đổi cấu trúc dữ liệu qua các tầng xử lý:
| Tiêu chí | Dữ liệu thô (Raw Data) | Dữ liệu đã chuẩn hóa (Cleaned Data) |
|---|---|---|
| Định dạng | Hỗn hợp HTML, Markdown, PDF lỗi font | Plain text đồng nhất chuẩn UTF-8 |
| Khoảng trắng | Nhiều khoảng trắng thừa, xuống dòng liên tục | Chuẩn hóa thành một khoảng trắng duy nhất |
| Ký tự đặc biệt | Chứa mã độc lập (\\n, , ký tự rác) | Đã được lọc bỏ hoặc chuyển mã an toàn |
4. Nghệ Thuật Cắt Khúc Dữ Liệu (Chunking Strategies)
Sau khi làm sạch, văn bản thường vượt quá giới hạn token của mô hình embedding. Kỹ thuật Chunking xuất hiện như một giải pháp bắt buộc để phân rã tài liệu thành các khối nhỏ dễ quản lý.
Tuyệt đối không chia nhỏ văn bản bằng cách đếm ký tự cứng nhắc. Thao tác này sẽ bẻ gãy mạch logic giữa các câu, khiến khả năng truy xuất thông tin của RAG sụt giảm trầm trọng.
Các chiến lược chunking tiên tiến đang được áp dụng rộng rãi:
- Fixed-size Chunking: Cắt văn bản dựa trên kích thước token cố định kèm khoảng chồng lấp (Overlap) nhằm duy trì tính liên tục ngữ cảnh giữa các khối liền kề.
- Semantic Chunking: Sử dụng mô hình embedding để đo lường độ tương đồng cosine giữa các câu. Hệ thống sẽ tự động ngắt đoạn khi phát hiện sự sụt giảm đột ngột về ý nghĩa.
- Hierarchical Chunking: Phân chia tài liệu thành khối lớn chứa toàn bộ chương mục, sau đó bóc tách thành các khối con để tối ưu hóa độ chính xác khi tìm kiếm.
Ví dụ minh họa việc thiết lập pipeline cắt khúc thông minh bằng thư viện Python langchain:
from langchain_text_splitters import RecursiveCharacterTextSplitter

# Khởi tạo bộ chia tài liệu chuyên dụng cho hệ thống LLM
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=300,
    chunk_overlap=50,
    separators=["\n\n", "\n", " ", ""]
)

# Dữ liệu văn bản đầu vào từ quy trình Data Ingestion
raw_text = "Kiến trúc Data Ingestion đóng vai trò cốt lõi trong hệ thống RAG. Pipeline chuẩn hóa giúp loại bỏ nhiễu dữ liệu thô. Quá trình chunking đảm bảo ngữ cảnh không bị đứt gãy khi đưa vào LLM."

# Thực hiện phân tách văn bản thành các chunks tối ưu hóa
chunks = text_splitter.create_documents([raw_text])

for index, chunk in enumerate(chunks):
    print(f"Chunk {index + 1}: {chunk.page_content}")
5. Tổng Kết
Xây dựng một pipeline Data Ingestion chuẩn mực chính là bệ phóng cho mọi ứng dụng AI thành công. Sự kết hợp hoàn hảo giữa thu thập tự động, làm sạch khắt khe và cắt khúc ngữ nghĩa thông minh sẽ trao cho LLM sức mạnh xử lý đỉnh cao, mang lại giá trị thực tiễn vững chắc cho doanh nghiệp.
Khám Phá Lộ Trình Chuyên Sâu Cùng MCNA Technology School
Nâng tầm tư duy kỹ thuật và làm chủ công nghệ trí tuệ nhân tạo cùng các chương trình đào tạo chuyên sâu của chúng tôi:
- Combo 5 khóa AI & Power BI: Xem chi tiết khóa học
- Combo Python: Xem chi tiết khóa học
Tác giả: Đàm Thị Thu Hiền – Marketer tại MCNA Technology School
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
🌐 Website: mcna.vn
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
📍 TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu