AI Agent Memory Evaluation: Measuring Memory Quality, Retrieval Accuracy & Memory Drift
Trong các hệ thống AI Agent hiện đại, Memory giúp Agent duy trì thông tin qua nhiều lượt hội thoại, ghi nhớ sở thích người dùng, tái sử dụng kết quả từ những nhiệm vụ trước và thực hiện các workflow dài hạn.
Tuy nhiên, một hệ thống có khả năng lưu trữ hàng nghìn memory items chưa chắc đã là một hệ thống có bộ nhớ tốt.
Agent có thể lưu đúng thông tin nhưng truy xuất sai. Nó có thể tìm được một dữ kiện liên quan nhưng bỏ qua thông tin quan trọng hơn. Thậm chí, Agent có thể tiếp tục sử dụng một thông tin đã lỗi thời dù người dùng đã cập nhật dữ liệu ở phiên làm việc sau.
Vì vậy, câu hỏi không chỉ là hệ thống lưu được bao nhiêu thông tin, mà còn là:
- Agent có nhớ đúng những gì đã được cung cấp không?
- Agent có truy xuất được thông tin phù hợp với câu hỏi hiện tại không?
- Agent có nhận ra khi một thông tin đã thay đổi không?
- Agent có biết từ chối trả lời khi không có đủ bằng chứng không?
- Chất lượng bộ nhớ có suy giảm khi số lượng hội thoại tăng lên không?
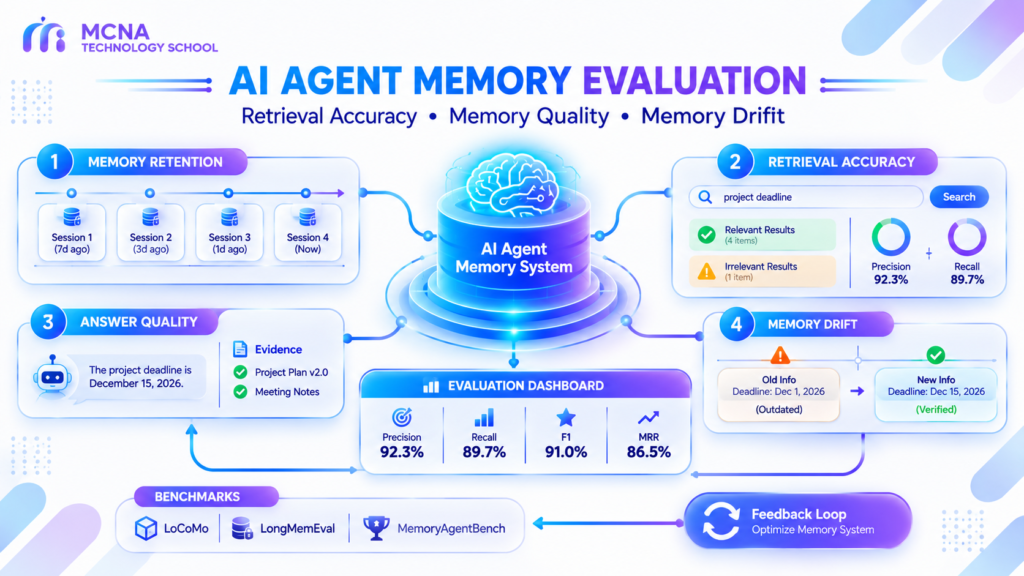
Đây chính là bài toán AI Agent Memory Evaluation – đánh giá chất lượng bộ nhớ trong toàn bộ quá trình lưu trữ, truy xuất và sử dụng thông tin của AI Agent.
1. AI Agent Memory Evaluation là gì?
AI Agent Memory Evaluation là quá trình đo lường khả năng của hệ thống AI Agent trong việc ghi nhớ, tổ chức, truy xuất, cập nhật và sử dụng thông tin từ các phiên làm việc trước đó.
Khác với việc chỉ đánh giá chất lượng câu trả lời của LLM, Memory Evaluation tập trung vào toàn bộ pipeline xử lý bộ nhớ.
Một pipeline cơ bản có thể gồm:
Conversation / External Data
          |
          v
    Memory Extraction
          |
          v
      Memory Store
          |
          v
     Memory Retrieval
          |
          v
    Context Assembly
          |
          v
      LLM Reasoning
          |
          v
      Final Answer
          |
          v
     Evaluation Layer
Ở mỗi giai đoạn, hệ thống đều có thể phát sinh lỗi:
| Giai đoạn | Lỗi có thể xảy ra | Cách đánh giá |
|---|---|---|
| Memory Extraction | Bỏ sót hoặc trích xuất sai dữ kiện | Extraction Accuracy |
| Memory Storage | Ghi trùng, ghi đè hoặc lưu sai phiên bản | Memory Integrity |
| Memory Retrieval | Không tìm thấy hoặc tìm nhầm thông tin | Precision, Recall, MRR |
| Context Assembly | Thiếu bằng chứng hoặc đưa quá nhiều dữ liệu nhiễu | Context Relevance |
| Answer Generation | Trả lời sai dù có bằng chứng đúng | Answer Accuracy |
| Memory Update | Tiếp tục sử dụng dữ liệu cũ | Knowledge Update Accuracy |
Điểm quan trọng: không nên chỉ đánh giá câu trả lời cuối cùng rồi kết luận bộ nhớ tốt hay kém. Cần xác định lỗi xuất hiện ở bước nào để có thể cải thiện đúng thành phần.
2. Bốn năng lực cốt lõi cần đánh giá
2.1. Memory Retention – Khả năng lưu giữ thông tin
Retention đo lường khả năng hệ thống giữ lại những thông tin quan trọng sau khi hội thoại kết thúc hoặc sau khi context ban đầu không còn được đưa trực tiếp vào prompt.
Ví dụ:
- Session 1: Người dùng cho biết tên dự án là Project Alpha.
- Session 2: Người dùng trao đổi về một chủ đề khác.
- Session 3: Người dùng hỏi lại tên dự án.
Nếu Agent vẫn trả lời chính xác là Project Alpha, hệ thống đã thể hiện khả năng giữ lại thông tin qua nhiều phiên.
Có thể đo tỷ lệ ghi nhớ thành công bằng công thức:
Memory Retention Rate
Retention Rate = Số thông tin quan trọng được giữ lại / Tổng số thông tin cần ghi nhớ
Chỉ số này cần được đo trên một tập thông tin đã xác định trước. Không nên xem mọi nội dung trong hội thoại đều là thông tin bắt buộc phải ghi nhớ.
2.2. Retrieval Accuracy – Độ chính xác truy xuất
Retrieval Accuracy đo lường khả năng tìm đúng memory khi Agent nhận được một câu hỏi hoặc nhiệm vụ.
Ví dụ, trong memory store có các thông tin:
- Customer prefers email notifications.
- Customer purchased a laptop in March.
- Customer’s project deadline is December 15.
- Customer prefers weekly reports.
Khi được hỏi: “What is the customer’s notification preference?”, Agent cần truy xuất thông tin về email notifications, thay vì lấy một memory khác chỉ vì nó có từ khóa gần giống.
Đây là thành phần thường được đánh giá bằng Precision, Recall, Hit Rate và MRR.
2.3. Knowledge Update – Khả năng cập nhật kiến thức
Trong môi trường thực tế, thông tin có thể thay đổi.
Ví dụ:
- Tháng 1: Người dùng làm việc tại Company A.
- Tháng 5: Người dùng chuyển sang Company B.
- Tháng 7: Người dùng hỏi Agent về công ty hiện tại.
Agent phải ưu tiên thông tin mới nhất và hiểu rằng dữ kiện cũ chỉ đúng trong một khoảng thời gian trước đó.
Đánh giá knowledge update cần kiểm tra:
- Agent có nhận ra thông tin mới không?
- Agent có phân biệt dữ liệu hiện tại và lịch sử không?
- Agent có tránh sử dụng thông tin đã bị thay thế không?
- Agent có giữ được mốc thời gian của từng thông tin không?
2.4. Selective Forgetting – Khả năng quên có chọn lọc
Một hệ thống memory tốt không chỉ biết ghi nhớ mà còn cần biết không sử dụng hoặc loại bỏ những thông tin không còn phù hợp.
Ví dụ, nếu người dùng yêu cầu xóa một thông tin khỏi bộ nhớ, hệ thống cần thực hiện đúng quy trình xóa đã thiết kế.
Selective Forgetting cần đánh giá hai khía cạnh:
- Thông tin cần giữ lại không bị xóa nhầm.
- Thông tin cần quên không tiếp tục xuất hiện trong kết quả truy xuất.
Đây không chỉ là bài toán retrieval. Nó còn liên quan đến deletion workflow, cache, vector index và các bản sao dữ liệu.
3. Retrieval Metrics – Các chỉ số đánh giá khả năng truy xuất
Để hiểu chất lượng retrieval, trước tiên cần xác định đâu là kết quả đúng và đâu là kết quả không phù hợp.
Giả sử một câu hỏi có ba memory items được đánh dấu là bằng chứng phù hợp:
Relevant Memories:
- M1
- M2
- M3

Retrieved Memories:
- M1
- M4
- M2
- M5
Trong trường hợp này:
- True Positive (TP) = 2: M1 và M2 được truy xuất đúng.
- False Positive (FP) = 2: M4 và M5 không liên quan.
- False Negative (FN) = 1: M3 bị bỏ sót.
3.1. Precision
Precision cho biết trong số những memory được truy xuất, có bao nhiêu memory thực sự liên quan.
Precision = TP / (TP + FP)
Với ví dụ trên:
Precision = 2 / (2 + 2) = 0.5 = 50%
Precision cao có nghĩa là hệ thống ít đưa dữ liệu không liên quan vào context.
3.2. Recall
Recall cho biết trong tổng số memory thực sự liên quan, hệ thống tìm được bao nhiêu.
Recall = TP / (TP + FN)
Với ví dụ trên:
Recall = 2 / (2 + 1) = 0.667 = 66.7%
Recall cao có nghĩa là hệ thống ít bỏ sót những thông tin cần thiết.
3.3. F1-score
F1-score là trung bình điều hòa giữa Precision và Recall.
F1 = 2 × Precision × Recall / (Precision + Recall)
Trong ví dụ:
F1 = 2 × 0.5 × 0.667 / (0.5 + 0.667) ≈ 0.571
F1 hữu ích khi muốn cân bằng giữa việc tìm đủ thông tin và tránh truy xuất quá nhiều dữ liệu nhiễu.
3.4. Hit Rate@K
Hit Rate@K đo tỷ lệ câu hỏi mà trong K kết quả đầu tiên có ít nhất một memory phù hợp.
Ví dụ, Hit Rate@5 kiểm tra xem trong năm kết quả đầu tiên có ít nhất một bằng chứng đúng hay không.
Chỉ số này hữu ích khi hệ thống chỉ cần một memory đủ tốt để trả lời câu hỏi.
3.5. Recall@K
Recall@K đo tỷ lệ các bằng chứng liên quan được tìm thấy trong K kết quả đầu tiên.
Recall@K đặc biệt hữu ích với câu hỏi cần tổng hợp thông tin từ nhiều phiên hội thoại hoặc nhiều tài liệu.
3.6. Mean Reciprocal Rank (MRR)
MRR đo vị trí xuất hiện của kết quả liên quan đầu tiên trong danh sách retrieval.
MRR = Trung bình của 1 / rank
Ví dụ:
| Query | Vị trí kết quả đúng đầu tiên | Reciprocal Rank |
|---|---|---|
| Q1 | 1 | 1.00 |
| Q2 | 2 | 0.50 |
| Q3 | 4 | 0.25 |
MRR = (1 + 0.5 + 0.25) / 3 = 0.583
MRR càng cao, hệ thống càng có xu hướng đưa bằng chứng đúng lên vị trí đầu danh sách.
3.7. So sánh các retrieval metrics
| Metric | Câu hỏi cần trả lời | Phù hợp với |
|---|---|---|
| Precision | Kết quả tìm được có liên quan không? | Giảm dữ liệu nhiễu |
| Recall | Có bỏ sót bằng chứng không? | Truy xuất đầy đủ |
| F1-score | Cân bằng Precision và Recall ra sao? | So sánh tổng thể |
| Hit Rate@K | Top K có ít nhất một kết quả đúng không? | Single-evidence retrieval |
| Recall@K | Top K tìm được bao nhiêu bằng chứng? | Multi-evidence retrieval |
| MRR | Kết quả đúng đầu tiên đứng ở vị trí nào? | Đánh giá thứ hạng |
Lưu ý: Không nên sử dụng một metric duy nhất để kết luận memory system tốt hay kém. Ví dụ, Hit Rate@5 có thể cao dù hệ thống vẫn bỏ sót nhiều bằng chứng cần thiết cho một câu hỏi tổng hợp.
4. Answer Quality – Đánh giá câu trả lời sau khi truy xuất
Retrieval đúng chưa đảm bảo Agent trả lời đúng.
Giả sử hệ thống đã truy xuất được memory:
Customer's current company: Company B
Updated: May 2026
Nhưng Agent lại trả lời: “The customer currently works at Company A.”
Trong tình huống này, retrieval có thể đã hoạt động đúng, nhưng bước reasoning hoặc answer generation đã thất bại.
Vì vậy, cần đánh giá thêm:
- Answer Accuracy: câu trả lời có đúng với đáp án tham chiếu không?
- Faithfulness: câu trả lời có được hỗ trợ bởi bằng chứng đã truy xuất không?
- Completeness: câu trả lời có bao quát đủ các thông tin cần thiết không?
- Abstention: Agent có biết từ chối khi không có đủ bằng chứng không?
- Temporal Correctness: Agent có sử dụng đúng phiên bản thông tin theo thời điểm được hỏi không?
Đối với các câu hỏi cần bằng chứng, nên lưu lại những memory IDs đã được sử dụng để có thể kiểm tra nguồn gốc của câu trả lời.
5. Memory Drift – Khi bộ nhớ dần trở nên sai lệch
Memory Drift là hiện tượng chất lượng hoặc tính phù hợp của bộ nhớ suy giảm theo thời gian, do dữ liệu lỗi thời, thay đổi thực tế, thông tin mâu thuẫn hoặc quá trình cập nhật không chính xác.
Memory Drift có thể xuất hiện theo nhiều cách.
5.1. Temporal Drift
Thông tin cũ vẫn tồn tại và được sử dụng như thể nó còn đúng ở hiện tại.
Ví dụ:
- Tháng 1: Người dùng sống tại Hà Nội.
- Tháng 6: Người dùng chuyển đến TP.HCM.
- Tháng 8: Agent vẫn trả lời người dùng đang sống tại Hà Nội.
Giải pháp:
- Lưu timestamp cho từng memory.
- Phân biệt valid_from và valid_to.
- Ưu tiên thông tin còn hiệu lực.
- Thiết kế quy trình xác minh lại những dữ kiện có thể thay đổi.
5.2. Contradiction Drift
Hai memory chứa thông tin mâu thuẫn cùng tồn tại mà không có cơ chế giải quyết.
Ví dụ:
M1: Customer prefers email notifications.
M2: Customer prefers SMS notifications.
Nếu không có timestamp, nguồn và trạng thái xác minh, Agent có thể truy xuất ngẫu nhiên một trong hai thông tin.
Giải pháp là lưu lịch sử phiên bản, nguồn gốc và quy tắc xử lý xung đột.
5.3. Extraction Drift
Quá trình tóm tắt hoặc trích xuất memory có thể làm mất chi tiết, thay đổi ý nghĩa hoặc biến một suy luận thành một dữ kiện.
Ví dụ:
- Original: “I might move to Singapore next year.”
- Incorrect memory: “User lives in Singapore.”
Thông tin ban đầu chỉ là một khả năng trong tương lai, nhưng memory lại biến nó thành một sự thật ở hiện tại.
Giải pháp: lưu trạng thái certainty, source type và nguyên văn bằng chứng khi cần thiết.
5.4. Retrieval Drift
Khi memory store ngày càng lớn, những dữ liệu cũ hoặc ít liên quan có thể xuất hiện thường xuyên hơn trong top-K retrieval.
Điều này có thể xảy ra do:
- Embedding không phân biệt tốt các ngữ cảnh tương tự.
- Thiếu bộ lọc thời gian hoặc metadata.
- Không có cơ chế reranking.
- Quá nhiều memory trùng lặp.
- Query không thể hiện rõ mục đích hoặc mốc thời gian.
Giải pháp có thể kết hợp semantic search, keyword search, metadata filtering và reranking.
6. Memory Benchmarks – Những bộ dữ liệu đánh giá phổ biến
Để so sánh các kiến trúc memory một cách có hệ thống, có thể sử dụng những benchmark chuyên biệt thay vì chỉ tự tạo vài câu hỏi kiểm thử.
6.1. LoCoMo
LoCoMo là benchmark tập trung vào khả năng ghi nhớ và trả lời câu hỏi dựa trên các cuộc hội thoại dài, diễn ra qua nhiều phiên.
Benchmark này có thể được sử dụng để kiểm tra:
- Single-hop recall: truy xuất một dữ kiện.
- Multi-hop reasoning: kết hợp nhiều dữ kiện.
- Temporal reasoning: hiểu thông tin theo thời gian.
- Open-domain questions: trả lời câu hỏi cần tổng hợp ngữ cảnh rộng hơn.
LoCoMo phù hợp khi muốn kiểm tra khả năng duy trì và khai thác thông tin trong lịch sử hội thoại dài.
6.2. LongMemEval
LongMemEval đánh giá khả năng ghi nhớ dài hạn trong các tình huống có nhiều phiên hội thoại và thông tin thay đổi.
Các nhóm câu hỏi chính gồm:
- Single-session user information.
- Single-session assistant information.
- Single-session preferences.
- Multi-session reasoning.
- Temporal reasoning.
- Knowledge updates.
Điểm đáng chú ý là LongMemEval không chỉ kiểm tra việc nhớ lại một dữ kiện, mà còn kiểm tra khả năng xử lý thông tin thay đổi và kết hợp bằng chứng qua nhiều phiên.
6.3. MemoryAgentBench
MemoryAgentBench hướng đến việc đánh giá memory trong bối cảnh Agent cần tương tác và sử dụng thông tin qua các bước xử lý.
Các năng lực quan trọng gồm:
- Retrieval: tìm kiếm thông tin liên quan.
- Test-time learning: tiếp nhận kiến thức mới trong quá trình hoạt động.
- Long-range understanding: hiểu thông tin qua khoảng thời gian dài.
- Selective forgetting: biết loại bỏ hoặc không sử dụng thông tin không còn phù hợp.
6.4. So sánh benchmark
| Benchmark | Trọng tâm | Khi nào nên dùng? |
|---|---|---|
| LoCoMo | Long-term conversational recall | Kiểm tra ghi nhớ hội thoại dài |
| LongMemEval | Multi-session, temporal reasoning, knowledge updates | Đánh giá trợ lý có memory dài hạn |
| MemoryAgentBench | Retrieval, learning, long-range understanding, forgetting | Đánh giá memory trong Agent workflow |
Không có benchmark nào bao phủ hoàn toàn mọi vấn đề của một hệ thống memory. Doanh nghiệp nên kết hợp benchmark công khai với bộ test được xây dựng từ các tình huống thực tế của chính ứng dụng.
7. Python Implementation: Xây dựng bộ đánh giá Retrieval
Trong phần này, chúng ta sử dụng Python thuần để xây dựng một bộ đánh giá retrieval cơ bản.
Giả sử hệ thống có một số câu hỏi và danh sách memory được truy xuất tương ứng. Mỗi câu hỏi có một tập hợp các memory IDs được đánh dấu là bằng chứng đúng.
7.1. Tạo dữ liệu kiểm thử
test_cases = [
    {
        "query": "What is the customer's notification preference?",
        "relevant": ["M1", "M2"],
        "retrieved": ["M1", "M3", "M2"]
    },
    {
        "query": "What is the project deadline?",
        "relevant": ["M4"],
        "retrieved": ["M5", "M4", "M6"]
    },
    {
        "query": "Which company does the user work for?",
        "relevant": ["M7", "M8"],
        "retrieved": ["M9", "M10"]
    }
]
7.2. Tính Precision
def precision_at_k(relevant, retrieved):
    if len(retrieved) == 0:
        return 0

    true_positive = 0

    for memory_id in retrieved:
        if memory_id in relevant:
            true_positive += 1

    return true_positive / len(retrieved)


for case in test_cases:
    score = precision_at_k(
        case["relevant"],
        case["retrieved"]
    )

    print(case["query"])
    print("Precision:", round(score, 3))
7.3. Tính Recall
def recall_at_k(relevant, retrieved):
    if len(relevant) == 0:
        return 0

    true_positive = 0

    for memory_id in retrieved:
        if memory_id in relevant:
            true_positive += 1

    return true_positive / len(relevant)


for case in test_cases:
    score = recall_at_k(
        case["relevant"],
        case["retrieved"]
    )

    print(case["query"])
    print("Recall:", round(score, 3))
7.4. Tính F1-score
def f1_score(precision, recall):
    if precision + recall == 0:
        return 0

    return (
        2 * precision * recall
        / (precision + recall)
    )


for case in test_cases:
    precision = precision_at_k(
        case["relevant"],
        case["retrieved"]
    )

    recall = recall_at_k(
        case["relevant"],
        case["retrieved"]
    )

    f1 = f1_score(precision, recall)

    print(case["query"])
    print("F1-score:", round(f1, 3))
7.5. Tính Hit Rate@K
def hit_rate_at_k(relevant, retrieved, k):
    top_k = retrieved[:k]

    for memory_id in top_k:
        if memory_id in relevant:
            return 1

    return 0


def average_hit_rate(test_cases, k):
    if len(test_cases) == 0:
        return 0

    total_hits = 0

    for case in test_cases:
        total_hits += hit_rate_at_k(
            case["relevant"],
            case["retrieved"],
            k
        )

    return total_hits / len(test_cases)


print("Hit Rate@2:", round(
    average_hit_rate(test_cases, 2), 3
))
7.6. Tính MRR
def reciprocal_rank(relevant, retrieved):
    for rank, memory_id in enumerate(retrieved, start=1):
        if memory_id in relevant:
            return 1 / rank

    return 0


def mean_reciprocal_rank(test_cases):
    if len(test_cases) == 0:
        return 0

    total = 0

    for case in test_cases:
        total += reciprocal_rank(
            case["relevant"],
            case["retrieved"]
        )

    return total / len(test_cases)


print("MRR:", round(
    mean_reciprocal_rank(test_cases), 3
))
7.7. Tổng hợp kết quả đánh giá
def evaluate_memory(test_cases, k=3):
    precision_scores = []
    recall_scores = []
    f1_scores = []
    mrr_scores = []

    for case in test_cases:
        precision = precision_at_k(
            case["relevant"],
            case["retrieved"][:k]
        )

        recall = recall_at_k(
            case["relevant"],
            case["retrieved"][:k]
        )

        f1 = f1_score(precision, recall)

        mrr = reciprocal_rank(
            case["relevant"],
            case["retrieved"][:k]
        )

        precision_scores.append(precision)
        recall_scores.append(recall)
        f1_scores.append(f1)
        mrr_scores.append(mrr)

    result = {
        "Precision@K": sum(precision_scores) / len(precision_scores),
        "Recall@K": sum(recall_scores) / len(recall_scores),
        "F1@K": sum(f1_scores) / len(f1_scores),
        "MRR@K": sum(mrr_scores) / len(mrr_scores)
    }

    return result


results = evaluate_memory(test_cases, k=3)

for metric, score in results.items():
    print(metric, ":", round(score, 3))
Đây là bộ đánh giá retrieval đơn giản, trong đó mỗi memory ID đã được gán nhãn relevant hoặc irrelevant từ trước. Kết quả chỉ phản ánh chất lượng danh sách truy xuất, chưa đánh giá khả năng tổng hợp câu trả lời của LLM.
8. Xây dựng bộ test để phát hiện Memory Drift
Để đánh giá Memory Drift, không nên chỉ kiểm tra một thời điểm. Cần tạo các tình huống có dữ kiện thay đổi theo thời gian và kiểm tra xem Agent có sử dụng đúng thông tin hiện tại hay không.
8.1. Tạo dữ liệu có phiên bản
memory_history = [
    {
        "fact": "company",
        "value": "Company A",
        "valid_from": "2026-01-01",
        "valid_to": "2026-05-31"
    },
    {
        "fact": "company",
        "value": "Company B",
        "valid_from": "2026-06-01",
        "valid_to": None
    }
]
8.2. Truy xuất thông tin tại một thời điểm
def get_fact_at_time(memory_history, fact, query_date):
    for memory in reversed(memory_history):
        if memory["fact"] != fact:
            continue

        valid_from = memory["valid_from"]
        valid_to = memory["valid_to"]

        if valid_from <= query_date:
            if valid_to is None or query_date <= valid_to:
                return memory["value"]

    return None


print(get_fact_at_time(
    memory_history,
    "company",
    "2026-03-01"
))

print(get_fact_at_time(
    memory_history,
    "company",
    "2026-08-01"
))
Kết quả mong đợi:
Company A
Company B
Ví dụ này minh họa cách lưu thông tin theo khoảng thời gian hiệu lực. Trong hệ thống thực tế, cần xác định rõ quy ước thời gian, múi giờ và xử lý khoảng ngày bắt đầu/kết thúc để tránh chồng lấn hoặc tạo ra khoảng trống dữ liệu.
8.3. Tạo test case cho Memory Drift
drift_tests = [
    {
        "question": "Which company did the user work for in March?",
        "query_date": "2026-03-01",
        "expected": "Company A"
    },
    {
        "question": "Which company does the user work for in August?",
        "query_date": "2026-08-01",
        "expected": "Company B"
    }
]

correct = 0

for test in drift_tests:
    answer = get_fact_at_time(
        memory_history,
        "company",
        test["query_date"]
    )

    if answer == test["expected"]:
        correct += 1

    print("Question:", test["question"])
    print("Expected:", test["expected"])
    print("Actual:", answer)

accuracy = correct / len(drift_tests)

print("Temporal Accuracy:", round(accuracy, 3))
Temporal Accuracy trong ví dụ này đo tỷ lệ câu hỏi được trả lời bằng đúng giá trị có hiệu lực tại thời điểm được hỏi. Đây là một kiểm thử minh họa, chưa thay thế việc đánh giá toàn bộ pipeline truy xuất và sinh câu trả lời.
9. Xây dựng Evaluation Pipeline cho AI Agent
Trong môi trường production, nên biến Memory Evaluation thành một quy trình kiểm thử có thể chạy lặp lại sau mỗi lần thay đổi kiến trúc.
Một pipeline tham khảo:
Evaluation Dataset
       |
       v
Memory Ingestion
       |
       v
Agent Query Execution
       |
       v
Memory Retrieval
       |
       v
Answer Generation
       |
       v
Metric Calculation
       |
       v
Error Analysis
       |
       v
Regression Report
9.1. Xây dựng Evaluation Dataset
Mỗi test case nên có:
- Conversation History: lịch sử hội thoại đầu vào.
- Question: câu hỏi cần Agent trả lời.
- Expected Answer: đáp án tham chiếu.
- Relevant Memory IDs: các memory chứa bằng chứng đúng.
- Timestamp: thời điểm cần đánh giá.
- Question Type: loại câu hỏi.
- Expected Behavior: trả lời, cập nhật hoặc từ chối.
9.2. Chạy Regression Test
Mỗi khi thay đổi embedding model, chunking strategy, memory extractor, retrieval algorithm hoặc reranking model, cần chạy lại cùng một bộ test.
Điều này giúp phát hiện trường hợp một thay đổi cải thiện một nhóm câu hỏi nhưng làm giảm chất lượng ở nhóm khác.
9.3. Theo dõi chất lượng theo thời gian
Ngoài điểm số tổng thể, nên theo dõi metric theo từng nhóm:
- Single-session recall.
- Multi-session recall.
- Knowledge update accuracy.
- Temporal reasoning accuracy.
- Abstention accuracy.
- Average retrieval latency.
- Token usage và chi phí mỗi truy vấn.
Không nên chỉ nhìn vào một con số accuracy tổng thể. Một hệ thống có thể đạt điểm trung bình tốt nhưng vẫn thất bại ở các tình huống quan trọng như knowledge updates hoặc temporal reasoning.
10. Những sai lầm thường gặp khi đánh giá Memory
10.1. Chỉ đánh giá câu trả lời cuối cùng
Nếu Agent trả lời sai, nguyên nhân có thể nằm ở extraction, retrieval, context assembly hoặc reasoning. Chỉ đánh giá đáp án cuối cùng sẽ khó xác định thành phần cần cải thiện.
10.2. Chỉ sử dụng câu hỏi dễ
Những câu hỏi truy xuất một dữ kiện đơn giản không phản ánh đầy đủ khả năng của memory system. Cần có câu hỏi nhiều phiên, câu hỏi có thông tin thay đổi và câu hỏi cần kết hợp nhiều bằng chứng.
10.3. Không có câu hỏi không thể trả lời
Nếu toàn bộ test đều có đáp án, hệ thống có thể học cách luôn đưa ra một câu trả lời ngay cả khi không có bằng chứng.
Cần bổ sung câu hỏi không có dữ kiện tương ứng để kiểm tra khả năng abstention.
10.4. Thay đổi nhiều thành phần cùng lúc
Nếu thay đổi đồng thời embedding model, retrieval strategy và answer model, kết quả tốt hoặc xấu sẽ khó được quy về đúng nguyên nhân.
Nên giữ cố định các thành phần không thuộc phạm vi thử nghiệm khi so sánh hai phương án.
10.5. Không kiểm soát tính nhất quán của Evaluation
LLM judge có thể đưa ra kết quả khác nhau giữa các lần chạy. Do đó, cần cố định model, prompt, tiêu chí chấm điểm và lưu lại kết quả đánh giá để có thể tái lập.
11. Tổng kết
AI Agent Memory Evaluation giúp xác định liệu hệ thống có thực sự ghi nhớ và sử dụng thông tin đúng cách hay không.
Một bộ đánh giá đầy đủ nên bao gồm:
- Memory Retention: kiểm tra khả năng giữ lại thông tin quan trọng.
- Retrieval Accuracy: đánh giá Precision, Recall, F1, Hit Rate và MRR.
- Answer Quality: kiểm tra độ chính xác, tính đầy đủ và mức độ bám sát bằng chứng.
- Knowledge Update: xác định Agent có sử dụng phiên bản thông tin mới nhất không.
- Selective Forgetting: kiểm tra khả năng không sử dụng hoặc xóa dữ liệu theo yêu cầu.
- Memory Drift: phát hiện dữ liệu lỗi thời, mâu thuẫn và sai lệch theo thời gian.
LoCoMo, LongMemEval và MemoryAgentBench là những benchmark hữu ích để đánh giá các khía cạnh khác nhau của memory. Tuy nhiên, benchmark công khai nên được kết hợp với dữ liệu kiểm thử phản ánh các tình huống thực tế của ứng dụng.
Một AI Agent có bộ nhớ tốt không phải là Agent lưu được nhiều thông tin nhất. Đó là Agent có thể tìm đúng thông tin, sử dụng đúng phiên bản, đưa ra câu trả lời có bằng chứng và nhận ra khi mình không biết.
12. Tài liệu tham khảo
- LongMemEval – Benchmarking Chat Assistants on Long-Term Interactive Memory
- LoCoMo – Long Conversation Memory Benchmark
- MemoryAgentBench – Benchmarking Memory for Long-Horizon Interactive Agents
- MLflow – Agent Memory Evaluation: Datasets, Metrics, and a Practical Setup
- Redis – Building and Evaluating Long-Term Conversational Memory
- AgentEval – Memory Benchmark
Học và triển khai AI cùng MCNA Technology School
Để xây dựng và đánh giá các hệ thống AI Agent, bạn cần kết hợp kiến thức Python, xử lý dữ liệu, API, LLM và tư duy đánh giá mô hình.
Tham khảo các chương trình học tại MCNA Technology School: