Ở bài viết trước, chúng ta đã sử dụng Redis để lưu lịch sử hội thoại và quản lý session cho AI Agent. Tuy nhiên, lịch sử hội thoại và bộ nhớ dài hạn là hai bài toán khác nhau. Redis có thể giúp ứng dụng truy cập nhanh các phiên đang hoạt động, nhưng Agent vẫn cần một cơ chế để lưu những thông tin hữu ích qua nhiều cuộc hội thoại và tìm lại chúng khi phù hợp.
Ví dụ, một người dùng thường yêu cầu báo cáo doanh thu theo tháng, sử dụng đơn vị triệu đồng và ưu tiên biểu đồ đường. Thay vì yêu cầu người dùng nhắc lại những tùy chọn này trong mỗi phiên, hệ thống có thể lưu chúng thành User Preferences và truy xuất khi người dùng yêu cầu một báo cáo mới.
Trong bài viết này, MCNA Technology School sẽ hướng dẫn xây dựng AI Agent Long-term Memory bằng PostgreSQL, Python và pgvector. Chúng ta sẽ phân biệt dữ liệu có cấu trúc với memory dạng ngữ nghĩa, thiết kế bảng lưu trữ và xây dựng cơ chế tìm kiếm thông tin liên quan.
1. AI Agent Long-term Memory là gì?
Long-term Memory là cơ chế cho phép AI Agent lưu giữ và truy xuất thông tin qua nhiều phiên hội thoại. Thông tin có thể là tùy chọn của người dùng, các sự kiện quan trọng, thông tin nghiệp vụ hoặc những nội dung cần sử dụng lại trong tương lai.
Không phải toàn bộ lịch sử hội thoại đều cần được ghi nhớ. Một hệ thống tốt nên lựa chọn thông tin theo mục đích sử dụng, kiểm tra tính hợp lệ và xác định thời gian lưu giữ phù hợp.
Ví dụ thực tế
Người dùng có thể trao đổi với Agent trong hai phiên khác nhau:
Phiên 1: Tôi muốn các báo cáo doanh thu hiển thị theo tháng, đơn vị triệu đồng.
Phiên 2: Hãy lập báo cáo doanh thu quý này.
Nếu thông tin từ phiên đầu được lưu đúng cách và còn hiệu lực, Agent có thể sử dụng tùy chọn đó để trình bày báo cáo ở phiên sau mà không cần người dùng nhắc lại.
Điều này không có nghĩa Agent nên lưu mọi câu nói. Những thông tin nhạy cảm, dữ liệu tạm thời hoặc thông tin chưa được xác nhận cần được xử lý theo chính sách riêng.
2. Phân biệt Structured Memory và Semantic Memory
Có hai hướng lưu trữ thường hữu ích khi xây dựng bộ nhớ dài hạn: dữ liệu có cấu trúc và dữ liệu được truy xuất theo ngữ nghĩa.
| Tiêu chí | Structured Memory | Semantic Memory |
|---|---|---|
| Dữ liệu | Các trường rõ ràng như đơn vị tiền tệ, định dạng ngày, tùy chọn biểu đồ | Thông tin dạng câu hoặc đoạn văn |
| Cách truy xuất | SQL, bộ lọc theo cột, user ID hoặc loại thông tin | Embedding và tìm kiếm vector theo độ tương đồng |
| Ví dụ | currency = VND, chart_type = line | Người dùng thích báo cáo xu hướng theo thời gian |
| Ưu điểm | Dễ kiểm soát, cập nhật và xác minh | Tìm được thông tin có ý nghĩa tương tự dù cách diễn đạt khác nhau |
Structured Memory phù hợp với các tùy chọn có thể biểu diễn bằng trường dữ liệu. Semantic Memory hữu ích khi cần tìm những ký ức có nội dung gần với câu hỏi hiện tại.
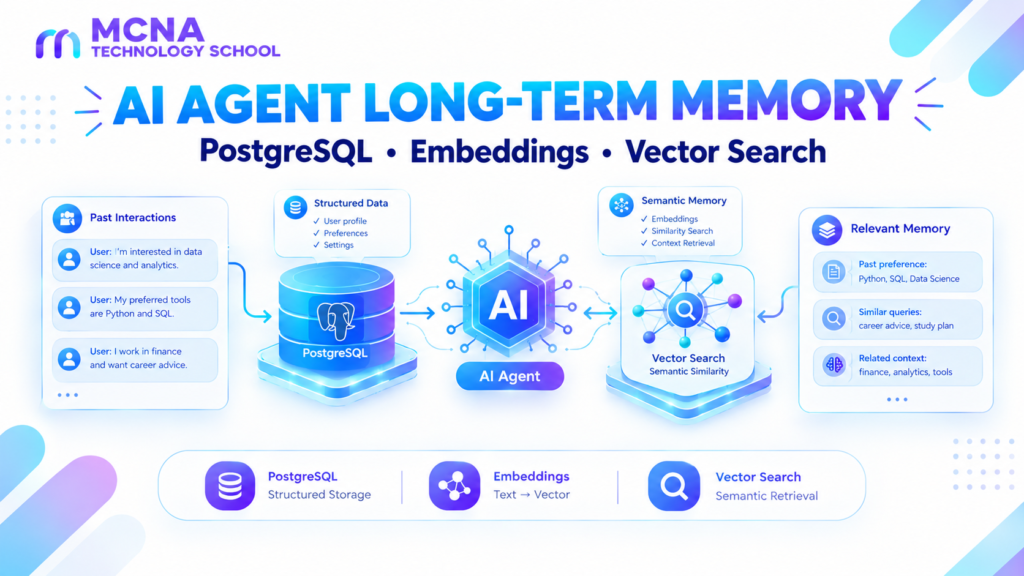
Trong ứng dụng thực tế, hai cách này có thể phối hợp với nhau. PostgreSQL lưu dữ liệu có cấu trúc, trong khi pgvector bổ sung khả năng tìm kiếm vector ngay trong cùng hệ quản trị cơ sở dữ liệu.
Tài liệu tham khảo: pgvector – Vector similarity search for Postgres.
3. Kiến trúc Long-term Memory cho AI Agent
Luồng xử lý cơ bản có thể được mô tả như sau:
User Message
     |
     v
Memory Retrieval
     |
     v
PostgreSQL + pgvector
     |
     v
Relevant Memories
     |
     v
LLM / AI Agent
     |
     v
Response to User
Khi người dùng gửi yêu cầu mới, hệ thống có thể chuyển câu hỏi thành embedding, tìm những ký ức gần nhất trong database và chọn thông tin phù hợp để bổ sung vào ngữ cảnh của Agent.
Ở một luồng riêng, khi người dùng cung cấp thông tin đáng ghi nhớ, ứng dụng có thể lưu thông tin đó cùng embedding tương ứng. Quá trình lưu cần kiểm tra dữ liệu trùng lặp, quyền riêng tư và khả năng cập nhật hoặc xóa về sau.
4. Vì sao sử dụng PostgreSQL và pgvector?
PostgreSQL là hệ quản trị cơ sở dữ liệu quan hệ. Với pgvector, PostgreSQL có thể lưu embedding và hỗ trợ tìm kiếm vector theo nhiều loại khoảng cách, bao gồm cosine distance và Euclidean distance.
Giải pháp này phù hợp khi ứng dụng muốn quản lý dữ liệu người dùng, nội dung memory và embedding trong cùng một hệ thống database.
- PostgreSQL: Lưu user ID, nội dung memory, loại dữ liệu và thời gian tạo.
- pgvector: Lưu embedding và tìm những vector gần với truy vấn.
- Python: Xử lý nghiệp vụ, tạo embedding và giao tiếp với database.
Với dữ liệu nhỏ, có thể bắt đầu bằng tìm kiếm vector chính xác mà chưa cần index chuyên dụng. Khi quy mô tăng, pgvector hỗ trợ các index gần đúng như HNSW và IVFFlat, đổi lại cần cân nhắc giữa tốc độ và độ đầy đủ của kết quả.
Tham khảo: pgvector Documentation.
5. Thiết kế bảng lưu trữ Memory
Giả sử ứng dụng cần lưu hai nhóm thông tin: User Preferences có cấu trúc và các ký ức dạng văn bản cần tìm kiếm theo ngữ nghĩa.
Bước 1: Tạo bảng User Preferences
CREATE TABLE user_preferences (
    user_id TEXT PRIMARY KEY,
    preferences JSONB NOT NULL DEFAULT '{}',
    updated_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);
Cột preferences lưu các tùy chọn dưới dạng JSONB. Ví dụ, một bản ghi có thể chứa:
{
  "currency": "VND",
  "report_period": "monthly",
  "chart_type": "line",
  "display_unit": "million"
}
Cách lưu này phù hợp với những tùy chọn có thể truy xuất trực tiếp. Với các trường có yêu cầu kiểm tra nghiêm ngặt, nên cân nhắc thiết kế thành những cột riêng và áp dụng ràng buộc dữ liệu.
Bước 2: Tạo bảng Semantic Memory
Ví dụ sau sử dụng embedding có 1.536 chiều để minh họa. Kích thước vector thực tế phải khớp với mô hình embedding mà ứng dụng sử dụng.
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE agent_memories (
    id BIGSERIAL PRIMARY KEY,
    user_id TEXT NOT NULL,
    content TEXT NOT NULL,
    memory_type TEXT NOT NULL DEFAULT 'general',
    embedding VECTOR(1536) NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);
Mỗi bản ghi đại diện cho một memory. Cột user_id giúp phân vùng dữ liệu theo người dùng, còn embedding lưu biểu diễn vector của nội dung.
Lưu ý: Extension pgvector phải được cài đặt và bật trong môi trường PostgreSQL. Nếu nhà cung cấp hoặc môi trường của bạn không hỗ trợ extension này, cần lựa chọn phương án triển khai phù hợp trước khi chạy câu lệnh SQL.
6. Kết nối PostgreSQL bằng Python
Trong ví dụ này, chúng ta sử dụng psycopg phiên bản 3 để kết nối PostgreSQL. Tạo file requirements.txt:
psycopg[binary]
pgvector
openai
Cài đặt thư viện:
python -m pip install -r requirements.txtĐặt thông tin kết nối database và API key vào environment variables thay vì ghi trực tiếp trong mã nguồn:
DATABASE_URL=postgresql://app_user:your_password@localhost:5432/agent_db
OPENAI_API_KEY=your_api_key
Đây là ví dụ về định dạng cấu hình, không phải thông tin đăng nhập có thể sử dụng trực tiếp. Trong production, hãy sử dụng secret manager hoặc cơ chế quản lý secret của nền tảng triển khai.
7. Tạo embedding cho memory
Embedding chuyển văn bản thành một vector số để hệ thống có thể so sánh mức độ tương đồng về ngữ nghĩa. Các câu có nội dung gần nhau có thể tạo ra những vector gần nhau trong không gian embedding, tùy thuộc vào mô hình sử dụng.
Ví dụ dưới đây sử dụng embedding API của OpenAI. Nếu sử dụng nhà cung cấp khác, cần thay phần gọi API và đảm bảo kích thước vector phù hợp với schema database.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENAI_API_KEY"]
)


def create_embedding(text: str) -> list[float]:
    response = client.embeddings.create(
        model="text-embedding-3-small",
        input=text
    )

    return response.data[0].embedding
Hàm create_embedding() nhận một đoạn văn bản và trả về vector tương ứng. Trong hệ thống thật, nên bổ sung xử lý lỗi API, timeout, giới hạn đầu vào và theo dõi chi phí.
Tài liệu tham khảo: OpenAI – Embeddings Guide.
8. Lưu memory vào PostgreSQL
Sau khi tạo embedding, chúng ta có thể lưu nội dung và vector vào bảng agent_memories.
import os
import psycopg

from pgvector.psycopg import register_vector


DATABASE_URL = os.environ["DATABASE_URL"]


def save_memory(
    user_id: str,
    content: str,
    memory_type: str = "general"
):
    embedding = create_embedding(content)

    with psycopg.connect(DATABASE_URL) as conn:
        register_vector(conn)

        conn.execute(
            """
            INSERT INTO agent_memories
                (user_id, content, memory_type, embedding)
            VALUES (%s, %s, %s, %s)
            """,
            (
                user_id,
                content,
                memory_type,
                embedding
            )
        )

        conn.commit()
Ví dụ, hệ thống có thể lưu một thông tin đã được người dùng xác nhận:
save_memory(
    user_id="user_001",
    content=(
        "Người dùng muốn báo cáo doanh thu "
        "theo tháng và đơn vị triệu đồng."
    ),
    memory_type="preference"
)
Đây chỉ là ví dụ minh họa. Trước khi lưu memory từ hội thoại thật, ứng dụng nên xác định nội dung nào đáng lưu, tránh tạo nhiều bản ghi trùng lặp và cho phép người dùng kiểm soát thông tin được ghi nhớ.
9. Truy xuất Memory bằng Vector Search
Khi người dùng đặt câu hỏi, hệ thống tạo embedding cho câu hỏi rồi tìm những memory gần nhất trong cùng phạm vi người dùng.
def search_memories(
    user_id: str,
    query: str,
    limit: int = 5
):
    query_embedding = create_embedding(query)

    with psycopg.connect(DATABASE_URL) as conn:
        register_vector(conn)

        rows = conn.execute(
            """
            SELECT
                content,
                memory_type,
                1 - (embedding <=> %s) AS similarity
            FROM agent_memories
            WHERE user_id = %s
            ORDER BY embedding <=> %s
            LIMIT %s
            """,
            (
                query_embedding,
                user_id,
                query_embedding,
                limit
            )
        ).fetchall()

    return [
        {
            "content": row[0],
            "memory_type": row[1],
            "similarity": float(row[2])
        }
        for row in rows
    ]
Toán tử <=> trong pgvector tính cosine distance. Biểu thức 1 - distance được dùng ở đây để biểu diễn cosine similarity cho mục đích tham khảo.
Cosine similarity không phải xác suất và không tự động cho biết một memory có đúng hoặc còn phù hợp hay không. Ngưỡng lựa chọn phải được kiểm thử trên dữ liệu thực tế.
Ví dụ gọi hàm:
memories = search_memories(
    user_id="user_001",
    query="Tôi muốn xem báo cáo doanh thu quý này",
    limit=5
)

for memory in memories:
    print(memory)
Trong production, cần xử lý trường hợp không có kết quả phù hợp, giới hạn độ dài nội dung và tránh trả về memory thuộc người dùng khác. Điều kiện lọc theo user ID phải được thực hiện trong truy vấn database, không chỉ lọc sau khi lấy dữ liệu.
10. Đưa Memory vào ngữ cảnh của AI Agent
Sau khi tìm được các memory liên quan, ứng dụng có thể sử dụng chúng để bổ sung ngữ cảnh cho lời gọi LLM.
def build_memory_context(memories):
    if not memories:
        return "Không tìm thấy memory liên quan."

    lines = []

    for item in memories:
        lines.append(
            "- " + item["content"]
        )

    return "\n".join(lines)
Ví dụ, kết quả truy xuất có thể cung cấp thông tin rằng người dùng thích báo cáo theo tháng và đơn vị triệu đồng. Agent có thể sử dụng các tùy chọn đó khi xây dựng câu trả lời cho yêu cầu mới.
Tuy nhiên, memory chỉ nên đóng vai trò dữ liệu tham khảo. Không nên coi nội dung truy xuất là chỉ dẫn có quyền ghi đè chính sách hệ thống. Nếu memory chứa nội dung do người dùng nhập, Agent cần tiếp tục áp dụng các quy tắc an toàn và kiểm tra quyền phù hợp.
11. Khi nào nên dùng Structured Memory, khi nào dùng Vector Search?
| Tình huống | Phương pháp phù hợp |
|---|---|
| Đọc tùy chọn đơn vị tiền tệ | Truy vấn cột hoặc JSONB |
| Lấy ngày báo cáo gần nhất | Truy vấn SQL có điều kiện và sắp xếp theo thời gian |
| Tìm ký ức có ý nghĩa tương tự câu hỏi mới | Vector Search |
| Vừa lọc theo user ID vừa tìm theo ngữ nghĩa | SQL filter kết hợp Vector Search |
| Thông tin không còn đúng | Cập nhật, đánh dấu hết hiệu lực hoặc xóa memory |
Không phải mọi dữ liệu đều cần embedding. Với thông tin có cấu trúc như đơn vị tiền tệ, trạng thái tài khoản hoặc tùy chọn định dạng, truy vấn SQL thường đơn giản và dễ kiểm soát hơn.
12. Index và tối ưu hiệu năng
Khi bảng memory tăng lên, có thể cân nhắc tạo index HNSW cho tìm kiếm cosine distance:
CREATE INDEX agent_memories_embedding_hnsw
ON agent_memories
USING hnsw (embedding vector_cosine_ops);
HNSW là một phương pháp tìm kiếm láng giềng gần đúng, có thể cải thiện hiệu năng trên dữ liệu vector lớn nhưng đánh đổi một phần độ đầy đủ của kết quả và sử dụng thêm tài nguyên. Với bảng nhỏ, truy vấn chính xác có thể đã đủ nhanh.
Trước khi tối ưu, hãy đo thời gian truy vấn, số lượng memory, chất lượng kết quả và tỷ lệ tìm đúng thông tin. Sau đó mới lựa chọn index, cấu hình và chiến lược lọc phù hợp.
Tài liệu tham khảo: pgvector – Indexing.
13. Bảo mật và quản lý vòng đời Memory
Long-term Memory có thể lưu thông tin cá nhân, sở thích hoặc dữ liệu nội bộ. Vì vậy, hệ thống cần có chính sách quản lý memory rõ ràng:
- Phân quyền: Chỉ truy xuất memory trong phạm vi người dùng đã được xác thực.
- Kiểm soát nội dung: Không tự động lưu mọi nội dung hội thoại thành ký ức dài hạn.
- Cập nhật và xóa: Có cơ chế sửa thông tin lỗi thời và xóa dữ liệu khi cần.
- Giới hạn lưu trữ: Xác định thời gian lưu phù hợp với mục đích sử dụng.
- Chống trùng lặp: Hạn chế lưu nhiều memory diễn đạt cùng một thông tin.
- Kiểm soát ngữ cảnh: Giới hạn số memory được đưa vào request để tránh tăng chi phí và độ trễ.
Nếu dùng vector search trên hệ thống nhiều người dùng, bộ lọc phân quyền phải được áp dụng trong quá trình truy vấn. Không nên tìm trên toàn bộ dữ liệu rồi mới cố gắng loại bỏ các kết quả không thuộc người dùng.
Kết luận
AI Agent Long-term Memory giúp hệ thống tái sử dụng những thông tin hữu ích qua nhiều phiên hội thoại. PostgreSQL phù hợp để lưu dữ liệu có cấu trúc và thông tin memory, trong khi pgvector bổ sung khả năng tìm kiếm theo ngữ nghĩa.
Kiến trúc hiệu quả không nhất thiết phải lưu mọi thứ bằng vector. Hãy dùng SQL cho các trường dữ liệu rõ ràng, vector search cho những ký ức cần tìm theo ý nghĩa và kết hợp cả hai khi bài toán yêu cầu.
Quan trọng hơn, memory cần được kiểm soát về độ chính xác, quyền truy cập, khả năng cập nhật và chính sách xóa dữ liệu. Đây là những yếu tố giúp AI Agent ghi nhớ hữu ích mà vẫn an toàn và dễ bảo trì.
Học thêm về AI và Data tại MCNA Technology School
Nếu bạn muốn xây dựng nền tảng Python, phân tích dữ liệu và ứng dụng AI vào các bài toán thực tế, có thể tham khảo các chương trình học tại MCNA Technology School: