Agent trả lời nghe rất thông minh nhưng liệu có hoàn thành đúng nhiệm vụ?
Trong làn sóng phát triển của trí tuệ nhân tạo, sự chú ý đang dịch chuyển mạnh mẽ từ các mô hình ngôn ngữ đơn thuần (LLM) sang các AI Agent – những hệ thống có khả năng tự suy luận, lập kế hoạch và chủ động gọi công cụ để thực thi công việc.
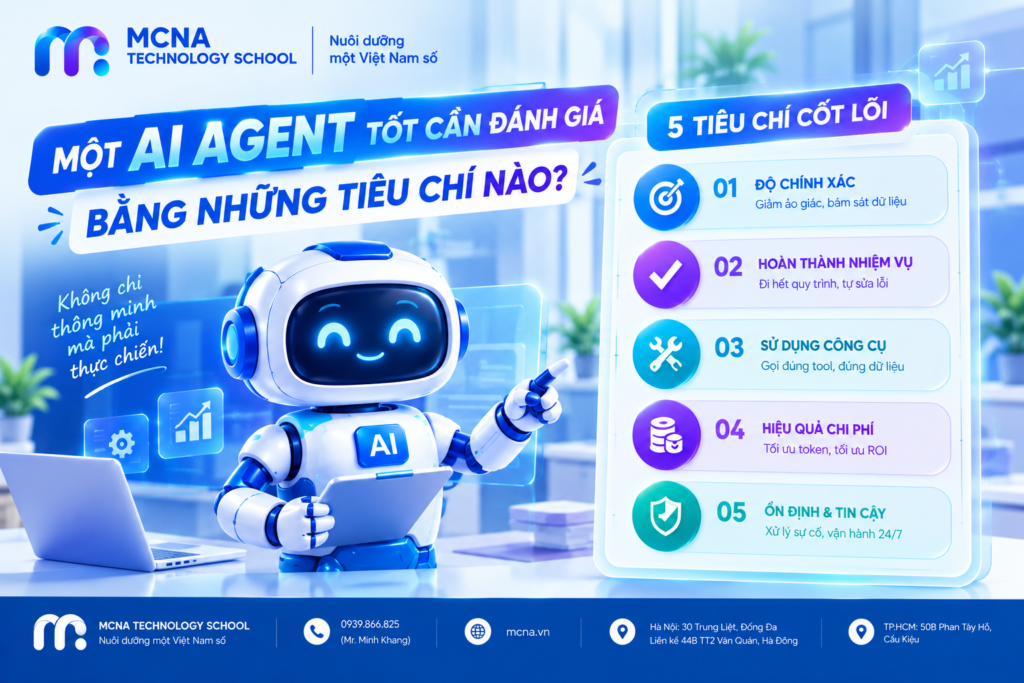
Tuy nhiên, một Agent biết trò chuyện hoa mỹ, trích dẫn triết lý hay viết đoạn văn mượt mà không đồng nghĩa với việc nó là một AI Agent tốt trong môi trường vận hành thực tế (Production). Để tránh cái bẫy “thông minh trên giấy tờ”, doanh nghiệp và kỹ sư cần sở hữu một khung đánh giá toàn diện dựa trên 5 tiêu chí cốt lõi.
1. Bộ 5 Tiêu Chí Cốt Lõi Đánh Giá AI Agent Thực Chiến
Toàn bộ sức mạnh và độ tin cậy của một AI Agent được đo lường qua 5 góc độ kinh tế và kỹ thuật sau:
[ AI AGENT QUALITY ] = Accuracy + Task Completion + Tool Use + Cost Efficiency + Stability
1.1. Độ Chính Xác & Giảm Ảo Giác (Accuracy & Hallucination Rate)
-
Khả năng bám sát ngữ cảnh: Agent có đưa ra câu trả lời dựa đúng trên dữ liệu được cung cấp (RAG / Knowledge Base) hay tự bịa đặt thông tin?
-
Độ tin cậy của thông số: Đối với các tác vụ trích xuất dữ liệu hoặc tính toán, sai số thông tin phải tiệm cận mức 0%.
1.2. Tỷ Lệ Hoàn Thành Nhiệm Vụ (Task Completion Rate – TCR)
-
End-to-End Success: Agent có đi hết toàn bộ quy trình từ điểm A đến điểm Z để trả về kết quả cuối cùng hay dừng lại giữa chừng?
-
Khả năng tự sửa lỗi (Self-Correction): Khi gặp chướng ngại vật ở một bước trung gian, Agent có biết điều chỉnh lập luận để thử lại phương án khác hay báo lỗi ngay lập tức?
1.3. Khả Năng Sử Dụng Công Cụ (Tool Use & Function Calling)
-
Đúng công cụ, đúng thời điểm: Agent có chọn chính xác API, cơ sở dữ liệu hoặc Search Engine cần thiết cho tác vụ đó không?
-
Chuẩn xác cấu trúc dữ liệu: Tham số truyền vào công cụ (JSON Schema) có chính xác định dạng để hệ thống phía sau tiếp nhận hay bị sai cú pháp?
1.4. Hiệu Quả Chi Phí (Cost Efficiency)
-
Tối ưu Token API: Agent có tốn quá nhiều lượt gọi LLM lặp đi lặp lại (Loop) cho một tác vụ đơn giản?
-
Chi phí biên trên mỗi đơn vị xử lý (Cost per Task): Tổng chi phí Token + Server để hoàn thành 1 nhiệm vụ có nhỏ hơn chi phí thuê con người xử lý thủ công hay không?
1.5. Tính Ổn Định & Độ Tin Cậy Vận Hành (System Stability & Reliability)
-
Xử lý sự cố (Error Handling): Khi API bên thứ ba bị nghẽn (Timeout, Rate Limit), Agent có hành xử thông minh (Retry, Fallback) hay treo toàn bộ luồng?
-
Tính nhất quán (Consistency): Khi chạy cùng một kịch bản 100 lần, tỷ lệ thành công có duy trì ổn định hay dao động thất thường?
2. Bảng Tóm Tắt Bộ Tiêu Chí Đánh Giá AI Agent
| Tiêu chí | Câu hỏi kiểm tra cốt lõi | Chỉ số đo lường (KPI) |
| 1. Accuracy | Agent trả lời có đúng sự thật và bám sát dữ liệu không? | Hallucination Rate (%), Factuality Score |
| 2. Task Completion | Agent có giải quyết triệt để bài toán được giao? | Task Completion Rate (TCR %), Retry Count |
| 3. Tool Use | Agent gọi công cụ và truyền dữ liệu có chuẩn xác? | Tool Call Accuracy (%), Schema Error Rate |
| 4. Cost Efficiency | Chi phí chạy Agent có mang lại lợi nhuận ròng (ROI)? | Cost per Executed Task ($), Token Usage |
| 5. Stability | Hệ thống có chạy ổn định 24/7 bất chấp sự cố API? | Uptime (%), SLA, Fallback Trigger Rate |
3. Phân Biệt “Benchmark Phòng Lab” Với “Kết Quả Thực Tế”
Nhiều nhà quản lý thường mắc sai lầm khi thấy một mô hình đạt điểm số Benchmark cao ngất ngưởng (như MMLU, HumanEval, GAIA) liền vội vã đưa vào doanh nghiệp và thất vọng vì kết quả không như kỳ vọng.
┌────────────────────────────────────────┐     ┌────────────────────────────────────────┐
│          BENCHMARK PHÒNG LAB           │     │            KẾT QUẢ THỰC TẾ             │
├────────────────────────────────────────┤     ├────────────────────────────────────────┤
│ • Môi trường sạch, dữ liệu chuẩn hóa   │ VS  │ • Dữ liệu thô nhiễu, thiếu cấu trúc    │
│ • Kiểm tra khả năng suy luận lý thuyết │     │ • Phụ thuộc vào API bên thứ 3 chập chờn│
│ • Giới hạn trong kịch bản cố định      │     │ • Phát sinh vô số Edge Cases bất ngờ   |
└────────────────────────────────────────┘     └────────────────────────────────────────┘
-
Benchmark phòng lab đo lường Trí thông minh tiềm năng (Potential Intelligence) của mô hình trong điều kiện hoàn hảo.
-
Kết quả thực tế (Production Readiness) đo lường Năng lực vận hành (Operational Capability) của cả kiến trúc hệ thống bao gồm Prompt Engineering, Error Handling, RAG và Governance.
4. Kết Luận
Một AI Agent giỏi không nằm ở việc nó nói chuyện thông minh ra sao, mà nằm ở tỷ lệ hoàn thành công việc chính xác, chi phí tối ưu và tính vận hành ổn định. Việc áp dụng một bộ tiêu chí đánh giá chuẩn xác ngay từ đầu sẽ giúp doanh nghiệp nhanh chóng loại bỏ các giải pháp AI mang tính “diễn xuất” để tập trung xây dựng những hệ thống tự động hóa tạo ra giá trị kinh tế thực sự.
Tham khảo thêm Framework đánh giá và phân quyền cho AI Agent cùng các lộ trình đào tạo kỹ thuật tự động hóa chuyên sâu tại MCNA Technology School:
-
Combo 5 khóa AI & Power BI: https://mcna.vn/khoa-hoc/khoa-hoc-combo-5-khoa-ai-va-power-bi/
-
Combo Python: https://mcna.vn/khoa-hoc/combo-python/
Tác giả: Nguyễn Thị Phương Anh – Intern Marketing tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Minh Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu