Trong Machine Learning, dữ liệu thực tế có thể chứa hàng chục, hàng trăm hoặc hàng nghìn Features. Số lượng Features lớn giúp mô tả nhiều khía cạnh của dữ liệu, nhưng cũng làm tăng chi phí tính toán, khiến việc trực quan hóa khó khăn và đôi khi đưa vào những thông tin trùng lặp hoặc không cần thiết.
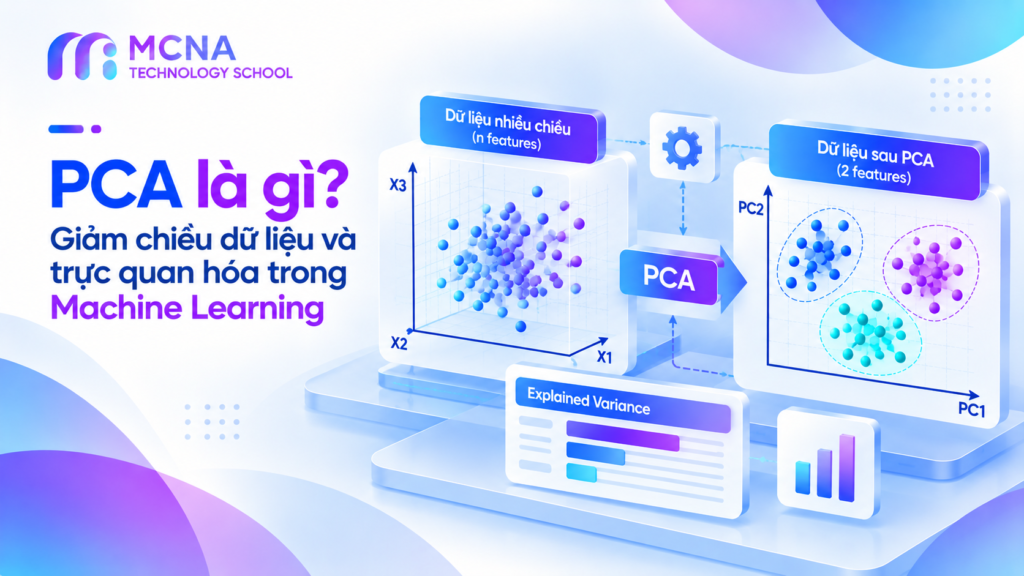
Principal Component Analysis (PCA) là một phương pháp Dimensionality Reduction phổ biến, giúp biến đổi dữ liệu từ không gian đặc trưng ban đầu sang một không gian mới có số chiều ít hơn. Điểm quan trọng là PCA cố gắng giữ lại nhiều phương sai của dữ liệu nhất có thể trong số chiều đã chọn.
PCA thường được giới thiệu trong nhóm phương pháp Unsupervised Learning vì không cần nhãn mục tiêu để tìm các Principal Components. Tuy nhiên, bản chất của PCA không phải là phân nhóm hay dự đoán, mà là tìm một cách biểu diễn dữ liệu hiệu quả hơn theo tiêu chí phương sai.
Bài viết này sẽ giải thích trực giác hình học, nền tảng toán học, cách lựa chọn số Principal Components, ứng dụng trực quan hóa và quy trình triển khai PCA bằng Python.
1. Vì sao Machine Learning cần giảm chiều dữ liệu?
Mỗi Feature có thể được xem là một chiều trong không gian dữ liệu. Nếu một bộ dữ liệu có hai Features, ta có thể biểu diễn các quan sát trên mặt phẳng hai chiều. Với ba Features, dữ liệu có thể được biểu diễn trong không gian ba chiều. Nhưng khi có hàng trăm Features, việc hình dung trực tiếp trở nên khó khăn.
1.1. Vấn đề dữ liệu nhiều chiều
Giả sử một doanh nghiệp lưu trữ dữ liệu khách hàng với các Features như tổng chi tiêu, chi tiêu trung bình, số đơn hàng, số lần truy cập, thời gian sử dụng dịch vụ và nhiều chỉ số hành vi khác.
Một số Features có thể tương quan với nhau. Ví dụ, tổng chi tiêu và số đơn hàng thường có liên hệ trong nhiều bối cảnh kinh doanh. Khi đó, dữ liệu có thể chứa nhiều chiều nhưng một phần biến thiên lại tập trung theo một số hướng nhất định.
Dimensionality Reduction tìm cách biểu diễn dữ liệu bằng ít chiều hơn mà vẫn giữ lại những thông tin quan trọng theo tiêu chí đã lựa chọn.
1.2. Lợi ích và giới hạn của giảm chiều
- Trực quan hóa: Biểu diễn dữ liệu nhiều chiều trên biểu đồ hai hoặc ba chiều.
- Giảm chi phí tính toán: Một số thuật toán có thể huấn luyện hoặc dự đoán nhanh hơn khi số Features giảm.
- Giảm thông tin trùng lặp: Có thể nén những hướng biến thiên có tương quan tuyến tính trong dữ liệu.
- Hỗ trợ khám phá cấu trúc: Giúp quan sát các hướng biến thiên nổi bật và mối quan hệ giữa các quan sát.
Tuy nhiên, giảm chiều không mặc nhiên cải thiện chất lượng mô hình. Những hướng có phương sai nhỏ đôi khi vẫn chứa thông tin quan trọng cho bài toán dự đoán. Vì vậy, hiệu quả của PCA cần được đánh giá theo mục tiêu sử dụng.
2. PCA là gì?
PCA (Principal Component Analysis) là phương pháp biến đổi tuyến tính, xây dựng một hệ trục tọa độ mới từ dữ liệu ban đầu. Các trục mới được gọi là Principal Components.
Những Principal Components có các đặc điểm quan trọng:
- Chúng là các tổ hợp tuyến tính của Features ban đầu.
- Các hướng Principal Components trực giao với nhau.
- Principal Component đầu tiên mô tả hướng có phương sai lớn nhất.
- Principal Component tiếp theo mô tả hướng có phương sai lớn nhất trong các hướng trực giao với những thành phần đã chọn.
Nếu giữ lại tất cả các Principal Components trong một PCA đầy đủ, ta có thể biểu diễn lại dữ liệu đã được Centering mà không mất thông tin do việc loại bỏ chiều. Khi chỉ giữ lại một phần các thành phần, ta chấp nhận mất một phần phương sai để giảm số chiều.
2.1. Trực giác hình học của PCA
Hãy tưởng tượng một tập điểm dữ liệu hai chiều phân bố theo hình elip kéo dài theo đường chéo. Nếu chỉ nhìn theo hai trục ban đầu, cả hai Features đều có vẻ biến thiên. Tuy nhiên, phần lớn sự thay đổi của dữ liệu thực tế nằm dọc theo hướng kéo dài của hình elip.
PCA sẽ tìm hướng đó làm Principal Component đầu tiên (PC1). Hướng vuông góc với PC1 trở thành Principal Component thứ hai (PC2).
Không gian ban đầu (X1, X2)

        X2
         |
         |        .  .
         |      .  .
         |    .  .
         |  .  .
         |.  .
         +---------------- X1

Dữ liệu biến thiên chủ yếu theo hướng chéo.

Sau PCA:

PC1: Hướng có phương sai lớn nhất
PC2: Hướng vuông góc với PC1

Nếu chỉ giữ PC1:
Dữ liệu 2 chiều → Biểu diễn 1 chiều
Như vậy, PCA không đơn giản chọn một Feature cũ rồi bỏ Feature còn lại. Thuật toán tạo ra một hướng mới bằng cách kết hợp thông tin từ các Features ban đầu.
2.2. Principal Component khác Feature gốc như thế nào?
Feature gốc là biến quan sát hoặc đo lường được trong dữ liệu. Principal Component là một biến mới được tính từ tổ hợp tuyến tính của các Features.
Ví dụ, nếu dữ liệu gồm hai Features X1 và X2, một Principal Component có thể được biểu diễn dưới dạng:
PC1 = a1 × (X1 - mean(X1))
    + a2 × (X2 - mean(X2))
Trong đó a1 và a2 là các hệ số của hướng Principal Component, còn mean(X1) và mean(X2) là giá trị trung bình của từng Feature trên dữ liệu dùng để fit PCA.
Các hệ số không được lựa chọn tùy ý. Chúng được xác định từ cấu trúc phương sai và hiệp phương sai của dữ liệu.
3. PCA hoạt động như thế nào?
Về mặt khái niệm, PCA tìm các hướng trực giao sao cho khi chiếu dữ liệu lên những hướng này, phương sai được giữ lại là lớn nhất theo số chiều đã chọn.
3.1. Quy trình thực hiện PCA
Dữ liệu ban đầu
       |
       v
Kiểm tra và xử lý dữ liệu
       |
       v
Centering / Standardization
       |
       v
Tìm các Principal Components
       |
       v
Sắp xếp theo phương sai giải thích
       |
       v
Lựa chọn số Components
       |
       v
Chiếu dữ liệu lên không gian mới
       |
       v
Trực quan hóa / Phân tích / Modeling
Trong triển khai thực tế, việc tính toán thường dựa trên Singular Value Decomposition (SVD) hoặc những thuật toán số tương đương, thay vì bắt buộc phải tạo và phân rã Covariance Matrix một cách tường minh.
3.2. Centering dữ liệu
PCA tiêu chuẩn yêu cầu xem xét biến thiên quanh giá trị trung bình. Vì vậy, trước khi tìm Principal Components, dữ liệu được Centering bằng cách trừ đi trung bình của từng Feature:
X_centered = X - mean(X)Centering giúp PCA xác định các hướng biến thiên của dữ liệu thay vì bị ảnh hưởng bởi vị trí trung bình của tập điểm trong hệ tọa độ.
3.3. Tìm các hướng có phương sai lớn nhất
Giả sử dữ liệu đã được Centering và có n quan sát. Với một vector đơn vị w, phép chiếu mỗi quan sát x_i lên hướng w là:
z_i = wᵀx_iPCA tìm hướng w làm phương sai của các giá trị z_i lớn nhất, với điều kiện:
wᵀw = 1Ràng buộc độ dài bằng 1 giúp tránh việc tăng phương sai một cách tùy ý bằng cách nhân hệ số của vector hướng.
Principal Component đầu tiên là nghiệm của bài toán tối ưu này. Những thành phần tiếp theo phải trực giao với các thành phần trước đó.
4. Nền tảng toán học của PCA
Để hiểu PCA sâu hơn, cần nắm ba khái niệm: Covariance Matrix, Eigenvectors và Eigenvalues.
4.1. Covariance Matrix là gì?
Covariance đo lường xu hướng hai biến thay đổi cùng nhau. Nếu hai Features thường tăng hoặc giảm cùng chiều, Covariance có thể dương. Nếu một Feature có xu hướng tăng khi Feature kia giảm, Covariance có thể âm.
Với ma trận dữ liệu X_centered có n hàng và d cột, Sample Covariance Matrix được tính như sau:
Σ = (1 / (n - 1)) × X_centeredᵀ × X_centeredMa trận Σ có kích thước d × d. Các phần tử trên đường chéo là phương sai của từng Feature, còn các phần tử ngoài đường chéo là Covariance giữa các cặp Features.
4.2. Eigenvectors và Eigenvalues
PCA có thể được giải thích thông qua bài toán Eigenvalue Decomposition của Covariance Matrix:
Σv = λvTrong đó:
- Σ: Covariance Matrix.
- v: Eigenvector xác định một hướng Principal Component.
- λ: Eigenvalue tương ứng, biểu thị phương sai theo hướng đó.
Các Eigenvectors được lựa chọn và sắp xếp theo Eigenvalues từ lớn đến nhỏ. Những hướng có Eigenvalues lớn hơn giải thích nhiều phương sai hơn.
4.3. Chiếu dữ liệu sang không gian mới
Sau khi chọn k Principal Components, ta ghép các vector hướng tương ứng thành ma trận W có kích thước d × k.
Dữ liệu mới được tính bằng:
Z = X_centered × WNếu X_centered có kích thước n × d thì Z có kích thước n × k.
Như vậy, PCA giảm số chiều từ d xuống k. Các quan sát vẫn giữ nguyên số lượng, nhưng mỗi quan sát được biểu diễn bằng k tọa độ mới thay vì d Features ban đầu.
4.4. PCA và SVD có liên hệ gì?
Singular Value Decomposition phân rã ma trận dữ liệu đã Centering thành:
X_centered = U × S × VᵀTrong đó các vector thuộc V xác định những hướng Principal Components, còn các Singular Values trong S liên hệ với phương sai giải thích.
Với Sample Covariance Matrix, Eigenvalues tương ứng được tính từ bình phương Singular Values chia cho n – 1.
SVD thường được ưu tiên trong triển khai số vì có thể tránh việc tạo trực tiếp Covariance Matrix và hỗ trợ nhiều chiến lược tính toán phù hợp với kích thước dữ liệu.
5. Explained Variance trong PCA là gì?
Một câu hỏi quan trọng khi sử dụng PCA là: nếu giảm từ hàng chục Features xuống hai hoặc ba Principal Components, chúng ta giữ lại được bao nhiêu thông tin?
PCA thường trả lời câu hỏi này thông qua Explained Variance.
5.1. Explained Variance Ratio
Explained Variance Ratio của Principal Component thứ i là tỷ lệ phương sai mà thành phần đó giải thích so với tổng phương sai của các thành phần.
Explained Variance Ratio_i
    = λ_i / Σλ_j
Trong đó λ_i là Eigenvalue của thành phần thứ i và tổng ở mẫu số bao gồm các Eigenvalues của toàn bộ thành phần trong biểu diễn đầy đủ.
5.2. Ví dụ minh họa
Giả sử một bộ dữ liệu sau khi thực hiện PCA có bốn Principal Components với tỷ lệ phương sai giải thích như sau. Đây là ví dụ giả định để minh họa cách đọc kết quả, không phải số liệu từ một bộ dữ liệu thực tế.
| Principal Component | Explained Variance Ratio | Cumulative Explained Variance |
|---|---|---|
| PC1 | 50% | 50% |
| PC2 | 30% | 80% |
| PC3 | 15% | 95% |
| PC4 | 5% | 100% |
Nếu chỉ giữ PC1 và PC2, ta giữ lại 80% tổng phương sai. Nếu giữ ba thành phần đầu tiên, tỷ lệ phương sai giữ lại là 95%.
Điều này không có nghĩa là giữ được 80% hoặc 95% toàn bộ ý nghĩa của dữ liệu. Explained Variance đo phương sai, không trực tiếp đo khả năng dự đoán, thông tin về Label hoặc giá trị kinh doanh.
6. Cách lựa chọn số Principal Components
Số lượng Principal Components cần giữ lại phụ thuộc vào mục tiêu sử dụng PCA.
6.1. Chọn theo Cumulative Explained Variance
Một cách phổ biến là lựa chọn số thành phần nhỏ nhất sao cho tổng Explained Variance Ratio đạt một ngưỡng định trước, chẳng hạn 90% hoặc 95%.
Các ngưỡng này chỉ là quy tắc thực hành, không phải chuẩn bắt buộc. Với một số bài toán, tỷ lệ phương sai thấp hơn vẫn đủ để trực quan hóa; với bài toán khác, cần giữ nhiều thành phần hơn để bảo toàn thông tin hữu ích.
6.2. Scree Plot
Scree Plot biểu diễn Explained Variance hoặc Eigenvalues theo thứ tự Principal Components.
Người phân tích có thể tìm một vị trí mà mức giảm phương sai giữa các thành phần bắt đầu chậm lại rõ rệt. Tuy nhiên, không phải Scree Plot nào cũng có điểm khuỷu tay rõ ràng.
6.3. Chọn theo mục tiêu trực quan hóa
Khi muốn vẽ biểu đồ Scatter Plot, ta thường giữ hai Principal Components đầu tiên. Nếu muốn trực quan hóa không gian ba chiều, có thể giữ ba thành phần.
Tuy nhiên, cần kiểm tra tổng Explained Variance Ratio của các thành phần được sử dụng. Nếu PC1 và PC2 chỉ giải thích một phần nhỏ tổng phương sai, biểu đồ hai chiều có thể bỏ qua nhiều cấu trúc của dữ liệu gốc.
7. PCA có cần Feature Scaling không?
Đây là một trong những vấn đề quan trọng nhất khi áp dụng PCA.
PCA dựa trên phương sai. Vì vậy, Features có thang đo lớn thường tạo ra phương sai lớn hơn và có thể chi phối các Principal Components.
7.1. Ví dụ về sự khác biệt thang đo
Giả sử dữ liệu khách hàng có hai Features:
- Tuổi, tính bằng năm.
- Thu nhập, tính bằng đồng.
Do đơn vị đo khác nhau, phương sai của thu nhập có thể lớn hơn rất nhiều so với phương sai của tuổi. Nếu áp dụng PCA trực tiếp, hướng phương sai lớn nhất có thể chủ yếu phản ánh biến thu nhập.
Trong trường hợp các Features có đơn vị đo khác nhau và cần được xem xét trên thang đo tương đương, Standardization thường là lựa chọn phù hợp.
7.2. Standardization trước PCA
Standardization biến đổi mỗi Feature theo công thức:
z = (x - μ) / σTrong đó μ là trung bình và σ là độ lệch chuẩn được tính từ dữ liệu dùng để fit bộ biến đổi.
Sau Standardization, mỗi Feature có trung bình gần 0 và phương sai gần 1 trên dữ liệu huấn luyện, với cách tính độ lệch chuẩn tương ứng.
Tuy nhiên, không phải lúc nào cũng cần Standardization. Nếu các Features cùng đơn vị đo và độ lớn phương sai mang ý nghĩa thực tế cần bảo toàn, việc chỉ Centering có thể phù hợp hơn.
Điều quan trọng là hiểu Standardization thay đổi tiêu chí phương sai mà PCA tối ưu. Đây không phải một bước hoàn toàn trung tính.
8. PCA và Feature Selection khác nhau như thế nào?
PCA thường được gọi là một phương pháp Feature Extraction, trong khi Feature Selection là quá trình lựa chọn một tập con của các Features ban đầu.
| Tiêu chí | PCA | Feature Selection |
|---|---|---|
| Cách giảm chiều | Tạo ra các Features mới từ tổ hợp tuyến tính | Giữ lại một số Features ban đầu |
| Khả năng diễn giải | Có thể khó diễn giải vì Components kết hợp nhiều Features | Thường dễ diễn giải hơn vì vẫn giữ Features gốc |
| Sử dụng Label | PCA tiêu chuẩn không sử dụng Label | Có phương pháp dùng Label và phương pháp không dùng Label |
| Mục tiêu | Giữ lại nhiều phương sai theo số chiều đã chọn | Chọn các Features phù hợp với tiêu chí lựa chọn |
Nếu mục tiêu là giảm số chiều để trực quan hóa hoặc nén biểu diễn tuyến tính, PCA là một lựa chọn đáng thử. Nếu mục tiêu là giữ các biến có ý nghĩa trực tiếp đối với quyết định kinh doanh hoặc dự đoán, Feature Selection có thể phù hợp hơn.
9. PCA có giúp Machine Learning chính xác hơn không?
PCA có thể cải thiện hiệu quả của một số mô hình trong những điều kiện phù hợp, nhưng không bảo đảm làm tăng Accuracy hoặc các chỉ số dự đoán khác.
9.1. Khi PCA có thể hữu ích
- Dữ liệu có nhiều Features tương quan mạnh.
- Cần giảm số chiều để tiết kiệm tài nguyên tính toán.
- Mô hình nhạy với số chiều hoặc khoảng cách trong không gian đặc trưng.
- Muốn giảm ảnh hưởng của những hướng biến thiên rất nhỏ, với điều kiện chúng không chứa thông tin quan trọng.
9.2. Khi PCA có thể làm giảm hiệu quả mô hình
PCA không sử dụng Label để tìm các thành phần chính. Vì vậy, một Feature có phương sai nhỏ nhưng có khả năng phân biệt lớp tốt vẫn có thể bị loại bỏ khi giảm chiều.
Ví dụ, trong một bài toán Classification, sự khác biệt nhỏ giữa hai nhóm có thể nằm theo một hướng có phương sai thấp. Nếu PCA loại bỏ hướng đó, mô hình dự đoán có thể mất thông tin quan trọng.
Do đó, khi sử dụng PCA trước Classification hoặc Regression, cần đánh giá toàn bộ Pipeline bằng Cross-Validation thay vì chỉ dựa vào Explained Variance.
10. Thực hành PCA bằng Python và scikit-learn
Chúng ta sẽ sử dụng bộ dữ liệu Iris có sẵn trong scikit-learn. Bộ dữ liệu gồm bốn Features đo lường đặc điểm của hoa. PCA sẽ biến đổi dữ liệu từ bốn chiều xuống hai chiều để trực quan hóa.
Nhãn loài hoa chỉ được sử dụng để tô màu các điểm trên biểu đồ sau khi PCA đã được thực hiện, không tham gia vào quá trình tìm Principal Components.
10.1. Cài đặt thư viện
pip install numpy pandas matplotlib scikit-learn10.2. Thực hiện PCA với hai Components
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.datasets import load_iris
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA

# 1. Tải dữ liệu
iris = load_iris()

X = iris.data
y = iris.target

# 2. Standardization
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 3. PCA giảm từ 4 chiều xuống 2 chiều
pca = PCA(n_components=2)

X_pca = pca.fit_transform(X_scaled)

# 4. Xem kích thước dữ liệu
print("Original shape:", X.shape)
print("PCA shape:", X_pca.shape)

# 5. Explained Variance Ratio
print(
    "Explained Variance Ratio:",
    pca.explained_variance_ratio_
)

print(
    "Total Explained Variance:",
    pca.explained_variance_ratio_.sum()
)

# 6. Tạo DataFrame
df_pca = pd.DataFrame(
    X_pca,
    columns=["PC1", "PC2"]
)

df_pca["Species"] = y

# 7. Trực quan hóa
plt.figure(figsize=(8, 6))

scatter = plt.scatter(
    df_pca["PC1"],
    df_pca["PC2"],
    c=df_pca["Species"],
    cmap="viridis",
    alpha=0.8
)

plt.xlabel("Principal Component 1")
plt.ylabel("Principal Component 2")
plt.title("PCA Visualization - Iris Dataset")

plt.legend(
    handles=scatter.legend_elements()[0],
    labels=list(iris.target_names),
    title="Species"
)

plt.grid(alpha=0.3)
plt.show()
10.3. Giải thích kết quả
Đoạn mã thực hiện các bước:
- Tải dữ liệu Iris gồm bốn Features.
- Standardization để các Features được xét trên thang đo phù hợp.
- Áp dụng PCA với
n_components=2. - Biến đổi dữ liệu thành hai tọa độ mới PC1 và PC2.
- Kiểm tra tỷ lệ phương sai được giữ lại.
- Vẽ biểu đồ hai chiều và dùng nhãn có sẵn để hỗ trợ diễn giải.
Giá trị Explained Variance Ratio thực tế sẽ được in ra khi chạy chương trình. Không nên suy đoán trước tỷ lệ này hoặc mặc định rằng hai Components giữ lại toàn bộ cấu trúc dữ liệu.
Nếu các nhóm hoa có xu hướng tách biệt trên biểu đồ, điều đó cho thấy hai hướng biến thiên chính có thể phản ánh một phần sự khác biệt giữa các nhóm. Tuy nhiên, PCA không sử dụng nhãn để tối ưu khả năng phân loại và không bảo đảm tạo ra sự phân tách tốt nhất.
11. Cách chọn số Components bằng Cumulative Explained Variance
Trong nhiều bài toán, chúng ta không muốn chọn số Components tùy ý. Thay vào đó, có thể xem tỷ lệ phương sai tích lũy để xác định số chiều phù hợp.
11.1. Vẽ Cumulative Explained Variance
import numpy as np
import matplotlib.pyplot as plt

from sklearn.decomposition import PCA

# X_scaled được tạo từ ví dụ trước
pca_full = PCA()
pca_full.fit(X_scaled)

cumulative_variance = np.cumsum(
    pca_full.explained_variance_ratio_
)

components = np.arange(
    1,
    len(cumulative_variance) + 1
)

plt.figure(figsize=(8, 5))

plt.plot(
    components,
    cumulative_variance,
    marker="o"
)

plt.axhline(
    y=0.95,
    color="red",
    linestyle="--",
    label="95% Variance"
)

plt.xlabel("Number of Components")
plt.ylabel("Cumulative Explained Variance")
plt.title("Choosing PCA Components")
plt.xticks(components)
plt.legend()
plt.grid(alpha=0.3)
plt.show()
Biểu đồ thể hiện mức độ phương sai tích lũy khi tăng số Principal Components. Người phân tích có thể sử dụng kết quả này để cân nhắc sự đánh đổi giữa số chiều và phương sai được giữ lại.
11.2. Tự động chọn số chiều theo tỷ lệ phương sai
scikit-learn hỗ trợ lựa chọn số Components dựa trên ngưỡng Explained Variance bằng tham số n_components dạng số thực từ 0 đến 1 khi sử dụng solver phù hợp.
from sklearn.decomposition import PCA

pca_95 = PCA(
    n_components=0.95,
    svd_solver="full"
)

X_reduced = pca_95.fit_transform(X_scaled)

print(
    "Number of Components:",
    pca_95.n_components_
)

print(
    "Explained Variance:",
    pca_95.explained_variance_ratio_.sum()
)
Trong ví dụ này, PCA chọn số thành phần nhỏ nhất cần thiết để đạt ít nhất 95% phương sai theo tiêu chí của thư viện.
12. PCA và Data Leakage: Sai lầm cần tránh
Một sai lầm phổ biến là thực hiện Standardization và PCA trên toàn bộ dữ liệu trước khi chia Train/Test trong bài toán dự đoán.
Cách làm đó khiến thống kê của tập test ảnh hưởng đến phép biến đổi được sử dụng trong quá trình huấn luyện, gây ra Data Leakage.
12.1. Quy trình đúng khi dùng PCA với Supervised Learning
Dữ liệu có Features và Labels
             |
             v
      Train / Test Split
             |
             v
       Training Data
             |
             v
     Fit StandardScaler
             |
             v
          Fit PCA
             |
             v
       Fit Classifier
             |
             v
       Đánh giá trên Test
       bằng các phép biến đổi
       đã học từ Training Data
12.2. Sử dụng Pipeline trong scikit-learn
Pipeline giúp kết hợp các bước Standardization, PCA và mô hình dự đoán, đồng thời bảo đảm những phép biến đổi được fit đúng trên tập huấn luyện trong quy trình đánh giá.
from sklearn.datasets import load_iris
from sklearn.model_selection import (
    train_test_split,
    cross_val_score
)
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.linear_model import LogisticRegression

iris = load_iris()

X = iris.data
y = iris.target

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

pipeline = Pipeline([
    ("scaler", StandardScaler()),
    ("pca", PCA(n_components=2)),
    ("classifier", LogisticRegression(
        max_iter=1000
    ))
])

scores = cross_val_score(
    pipeline,
    X_train,
    y_train,
    cv=5,
    scoring="accuracy"
)

print("CV Accuracy:", scores.mean())

pipeline.fit(X_train, y_train)

print(
    "Test Accuracy:",
    pipeline.score(X_test, y_test)
)
Trong ví dụ này, Cross-Validation được thực hiện trên tập huấn luyện. Ở mỗi lần chia, StandardScaler và PCA được fit lại trên phần dữ liệu dùng để huấn luyện của lần đó, giúp tránh sử dụng thông tin từ phần validation để xây dựng phép biến đổi.
Để xác định PCA có thực sự hữu ích hay không, nên so sánh Pipeline có PCA với một Pipeline tương tự nhưng không có PCA, sử dụng cùng quy trình đánh giá.
13. Những hạn chế quan trọng của PCA
13.1. PCA chỉ tìm cấu trúc tuyến tính
PCA xây dựng các Principal Components bằng tổ hợp tuyến tính của Features ban đầu. Vì vậy, phương pháp này không được thiết kế để mô tả trực tiếp mọi cấu trúc phi tuyến phức tạp.
Với dữ liệu có cấu trúc phi tuyến, những phương pháp khác như Kernel PCA, t-SNE hoặc UMAP có thể đáng cân nhắc tùy mục tiêu. Tuy nhiên, các phương pháp này có giả định và cách diễn giải riêng, không thể thay thế PCA một cách máy móc.
13.2. PCA nhạy với Outliers
Vì dựa trên phương sai, PCA có thể bị ảnh hưởng đáng kể bởi những quan sát ngoại lệ. Một số Outliers có thể làm thay đổi hướng của Principal Components.
Do đó, trước khi thực hiện PCA, cần kiểm tra dữ liệu bất thường và xác định liệu chúng là lỗi dữ liệu hay những quan sát hợp lệ có ý nghĩa thực tế.
13.3. Principal Components có thể khó diễn giải
Một Principal Component có thể kết hợp nhiều Features với các hệ số khác nhau. Vì vậy, đôi khi rất khó gắn một ý nghĩa kinh doanh đơn giản cho PC1 hoặc PC2.
Để hỗ trợ diễn giải, có thể xem components_ trong scikit-learn nhằm kiểm tra hệ số của từng Feature trong mỗi Principal Component. Khi diễn giải, cần lưu ý dấu của một Principal Component có thể đảo mà không thay đổi bản chất của không gian biểu diễn.
13.4. Phương sai lớn không đồng nghĩa với thông tin quan trọng
PCA ưu tiên các hướng có phương sai lớn, nhưng những hướng này không nhất thiết là những hướng quan trọng nhất cho Classification, Regression hoặc một mục tiêu kinh doanh cụ thể.
Đây là giới hạn mang tính bản chất của PCA, không phải lỗi triển khai. Vì vậy, cần xác định rõ mục tiêu trước khi lựa chọn số Components và đánh giá kết quả.
14. Khi nào nên sử dụng PCA?
PCA thường là lựa chọn phù hợp khi cần khám phá cấu trúc biến thiên của dữ liệu số, giảm số chiều hoặc trực quan hóa dữ liệu nhiều Features.
| Tình huống | Có nên thử PCA? | Lưu ý |
|---|---|---|
| Trực quan hóa dữ liệu nhiều chiều | Có | Kiểm tra phương sai được giữ lại trong 2–3 Components. |
| Nhiều Features tương quan | Có | PCA có thể nén các hướng biến thiên trùng lặp. |
| Cần giữ nguyên ý nghĩa từng Feature | Cân nhắc | Feature Selection có thể dễ diễn giải hơn. |
| Dữ liệu có nhiều Outliers | Cần thận trọng | Outliers có thể làm thay đổi các hướng Principal Components. |
| Muốn tăng Accuracy của mô hình | Cần kiểm chứng | So sánh mô hình có PCA và không có PCA bằng Cross-Validation. |
| Dữ liệu có cấu trúc phi tuyến phức tạp | Cân nhắc phương pháp khác | PCA tuyến tính có thể không bảo toàn cấu trúc cần quan sát. |
15. Kết luận
PCA là một phương pháp Dimensionality Reduction quan trọng trong Machine Learning, giúp biến đổi dữ liệu nhiều chiều thành một hệ tọa độ mới gồm các Principal Components trực giao.
Nguyên lý cốt lõi của PCA là tìm những hướng có phương sai lớn nhất, sau đó giữ lại một số hướng để biểu diễn dữ liệu với ít chiều hơn. Explained Variance Ratio giúp định lượng lượng phương sai được bảo toàn, trong khi Cumulative Explained Variance hỗ trợ lựa chọn số Components.
Tuy nhiên, PCA không phải công cụ tự động loại bỏ mọi thông tin không quan trọng. Phương sai lớn không đồng nghĩa với giá trị dự đoán cao, và việc giảm chiều có thể làm mất những tín hiệu hữu ích cho một bài toán cụ thể.
Khi được sử dụng đúng cách, đặc biệt với Feature Scaling phù hợp, quy trình đánh giá tránh Data Leakage và mục tiêu phân tích rõ ràng, PCA trở thành một công cụ hiệu quả để khám phá, trực quan hóa và xây dựng biểu diễn dữ liệu trong Machine Learning.
16. Tài liệu tham khảo
- scikit-learn. Principal Component Analysis (PCA). Tài liệu chính thức về PCA và Dimensionality Reduction. https://scikit-learn.org/stable/modules/decomposition.html#pca
- scikit-learn. PCA API Reference. Tài liệu về các tham số, Explained Variance và cách triển khai PCA. https://scikit-learn.org/stable/modules/generated/sklearn.decomposition.PCA.html
- scikit-learn. Importance of Feature Scaling. Ví dụ giải thích ảnh hưởng của Standardization đối với PCA và các thuật toán Machine Learning. https://scikit-learn.org/stable/auto_examples/preprocessing/plot_scaling_importance.html
- scikit-learn. Common Pitfalls and Recommended Practices. Tài liệu về Data Leakage và các thực hành Machine Learning phù hợp. https://scikit-learn.org/stable/common_pitfalls.html
- Jolliffe, I. T., & Cadima, J. (2016). Principal component analysis: a review and recent developments. Philosophical Transactions of the Royal Society A. https://doi.org/10.1098/rsta.2015.0202
- Pearson, K. (1901). On Lines and Planes of Closest Fit to Systems of Points in Space. Philosophical Magazine. https://doi.org/10.1080/14786440109462720
17. Học thêm Data, AI và Machine Learning tại MCNA
Nếu bạn muốn phát triển kiến thức về Python, Data Analysis và ứng dụng AI trong công việc, có thể tham khảo các chương trình học tại MCNA Technology School:
- Combo 5 khóa AI & Power BI: Tìm hiểu chương trình Combo 5 khóa AI & Power BI
- Combo Python: Tìm hiểu chương trình Combo Python
Tác giả
Nguyễn Quốc Hải – Data Analyst tại MCNA Technology School
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp lớn như Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
🌐 Website: mcna.vn
📘 Facebook: facebook.com/mcnatechnologyschool
▶️ YouTube: youtube.com/@mcna.technology.school
💼 LinkedIn: linkedin.com/company/mcna-vn
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B, TT2, Văn Quán, Hà Đông
📍 TP.HCM: The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu