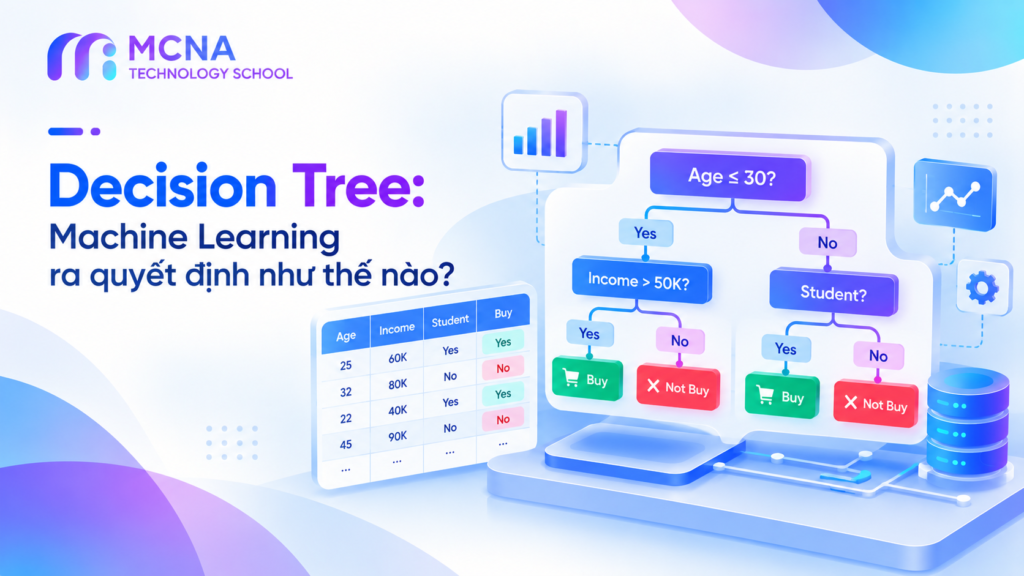
Trong Machine Learning, nhiều thuật toán dự đoán kết quả thông qua những công thức toán học tương đối khó diễn giải. Decision Tree (Cây quyết định) tiếp cận vấn đề theo một cách trực quan hơn: mô hình đặt ra các câu hỏi về dữ liệu, chia dữ liệu thành những nhóm nhỏ và tiếp tục phân chia cho đến khi có thể đưa ra dự đoán.
Ví dụ, một doanh nghiệp muốn dự đoán khách hàng có tiếp tục sử dụng dịch vụ hay không. Decision Tree có thể học được những quy tắc như: khách hàng có thời gian sử dụng ngắn và ít tương tác có nguy cơ rời bỏ cao hơn. Đây là ví dụ minh họa về dạng quy tắc mà mô hình có thể học, không phải kết luận áp dụng cho mọi doanh nghiệp.
Điểm đặc biệt của Decision Tree là các quy tắc không nhất thiết phải do con người viết trước. Thuật toán tự tìm cách chia dữ liệu dựa trên các tiêu chí tối ưu trong quá trình huấn luyện.
Trong chuỗi Machine Learning, bài viết này tiếp nối Logistic Regression. Nếu Logistic Regression mô hình hóa xác suất thông qua một biểu thức toán học, Decision Tree học các điều kiện phân chia dữ liệu theo từng bước.
1. Decision Tree là gì?
Decision Tree là thuật toán Supervised Learning sử dụng cấu trúc cây để chia dữ liệu thành các nhóm dựa trên điều kiện của những Feature, từ đó dự đoán nhãn hoặc giá trị mục tiêu.
Mô hình có cấu trúc gồm các thành phần chính:
- Root Node: nút gốc, nơi bắt đầu quá trình ra quyết định.
- Internal Node: nút trung gian chứa một điều kiện kiểm tra Feature.
- Branch: nhánh biểu diễn kết quả của điều kiện.
- Leaf Node: nút lá, nơi mô hình đưa ra dự đoán cuối cùng.
Ví dụ, nếu dự đoán khách hàng có gia hạn dịch vụ hay không, cây có thể bắt đầu bằng câu hỏi “Khách hàng đã sử dụng dịch vụ trên 6 tháng chưa?”. Tùy câu trả lời, dữ liệu đi theo các nhánh khác nhau. Mỗi nhánh tiếp tục kiểm tra điều kiện khác nếu cần.
1.1. Cấu trúc cơ bản của một cây quyết định
                 [Thời gian sử dụng > 6 tháng?]
                         /          \
                       Có            Không
                       /                \
             [Tần suất sử dụng cao?]   [Leaf: Nhóm rủi ro]
                    /       \
                  Có         Không
                  /             \
       [Leaf: Nhóm ít rủi ro]  [Leaf: Nhóm cần theo dõi]
Sơ đồ trên chỉ minh họa cách một cây có thể được tổ chức. Khi huấn luyện thực tế, thuật toán quyết định Feature nào được dùng để chia trước, ngưỡng chia ở đâu và cây nên dừng tại độ sâu nào.
1.2. Decision Tree có thể giải quyết những bài toán nào?
Decision Tree thường được sử dụng cho hai nhóm bài toán:
| Loại bài toán | Mục tiêu | Ví dụ |
|---|---|---|
| Classification | Dự đoán một nhãn hoặc nhóm | Khách hàng rời bỏ hay tiếp tục sử dụng dịch vụ |
| Regression | Dự đoán một giá trị số | Dự đoán giá nhà hoặc doanh thu |
Với Classification, nút lá có thể đưa ra lớp dự đoán và tỷ lệ quan sát thuộc từng lớp trong nút đó. Với Regression, nút lá thường đưa ra giá trị đại diện của các mục tiêu trong vùng dữ liệu tương ứng, chẳng hạn giá trị trung bình khi sử dụng tiêu chí bình phương sai số.
2. Decision Tree ra quyết định như thế nào?
Để hiểu bản chất thuật toán, hãy phân biệt hai quá trình: huấn luyện cây và sử dụng cây để dự đoán. Huấn luyện là lúc mô hình tìm các điều kiện phân chia; dự đoán là lúc một quan sát mới đi qua những điều kiện đã học.
2.1. Bước 1: Bắt đầu từ toàn bộ dữ liệu huấn luyện
Giả sử doanh nghiệp có dữ liệu khách hàng với các Feature như số tháng sử dụng, số lần đăng nhập, mức chi tiêu và nhãn gia hạn dịch vụ. Ban đầu, toàn bộ quan sát nằm tại Root Node.
Nếu dữ liệu chứa cả khách hàng gia hạn và không gia hạn, nút gốc chưa thể đưa ra một quyết định đủ tốt cho mọi trường hợp. Thuật toán cần tìm cách chia dữ liệu thành những nhóm có nhãn đồng nhất hơn hoặc có giá trị mục tiêu gần nhau hơn.
2.2. Bước 2: Tạo các điều kiện phân chia ứng viên
Thuật toán xem xét những Feature có sẵn và tạo các điều kiện chia phù hợp. Với Feature dạng số, điều kiện thường có dạng so sánh với một ngưỡng:
So_thang_su_dung <= 6
Muc_chi_tieu <= 500000
So_lan_dang_nhap <= 10
Với Feature phân loại, điều kiện có thể kiểm tra một giá trị hoặc một nhóm giá trị, tùy thuật toán và cách biểu diễn dữ liệu. Cách hỗ trợ Feature phân loại trực tiếp cũng khác nhau giữa các thư viện; trong scikit-learn, dữ liệu phân loại thường cần được mã hóa phù hợp trước khi đưa vào cây.
2.3. Bước 3: Đánh giá chất lượng từng cách chia
Không phải điều kiện nào cũng có giá trị như nhau. Một cách chia tốt sẽ tạo ra các nhóm con phù hợp hơn với mục tiêu dự đoán.
Trong Classification, thuật toán thường đánh giá độ hỗn tạp của nhãn bằng các tiêu chí như Gini Impurity hoặc Entropy. Trong Regression, thuật toán có thể đánh giá mức độ phân tán của giá trị mục tiêu thông qua Mean Squared Error (MSE) hoặc tiêu chí khác.
Thuật toán lựa chọn cách chia làm giảm độ hỗn tạp theo tiêu chí đang sử dụng, có tính đến số lượng quan sát trong mỗi nhóm con.
2.4. Bước 4: Lặp lại trên các nút con
Sau khi chọn một điều kiện, dữ liệu được chia thành các nhóm. Thuật toán tiếp tục tìm điều kiện tốt cho từng nhóm con, rồi lặp lại quá trình này cho đến khi gặp điều kiện dừng.
Dữ liệu huấn luyện
        |
        v
Tìm điều kiện chia tốt nhất tại nút hiện tại
        |
        v
Đánh giá chất lượng các nhóm sau khi chia
        |
        v
Chọn điều kiện làm giảm độ hỗn tạp phù hợp
        |
        v
Tạo các nút con
        |
        v
Tiếp tục chia hoặc dừng
        |
        v
Hoàn thành cây quyết định
Đây thường là một chiến lược tham lam (Greedy): thuật toán chọn cách chia tốt nhất tại nút hiện tại theo tiêu chí đã định, thay vì tìm kiếm toàn bộ mọi cấu trúc cây có thể có. Vì vậy, cây được tạo ra không được bảo đảm là cấu trúc tối ưu toàn cục.
2.5. Bước 5: Dự đoán cho một quan sát mới
Khi cây đã được huấn luyện, một quan sát mới bắt đầu từ Root Node và lần lượt đi theo các nhánh tương ứng với giá trị Feature của nó. Khi đến Leaf Node, mô hình trả về dự đoán.
Quá trình này không yêu cầu huấn luyện lại cây cho từng quan sát. Các điều kiện phân chia đã được xác định trong giai đoạn huấn luyện.
3. Gini Impurity là gì?
Gini Impurity đo mức độ hỗn tạp của nhãn trong một nút. Nếu tất cả quan sát trong nút thuộc cùng một lớp, Gini bằng 0. Nếu các lớp phân bố đồng đều, Gini sẽ cao hơn.
3.1. Công thức Gini Impurity
Với K lớp và tỷ lệ quan sát thuộc lớp k là pk, công thức Gini là:
Gini = 1 - sum(p_k^2)Trong đó, pk là tỷ lệ quan sát thuộc lớp k trong nút đang xét. Với bài toán hai lớp, công thức có thể viết:
Gini = 1 - (p_0^2 + p_1^2)3.2. Ví dụ tính Gini
Giả sử một nút có 10 khách hàng, trong đó 8 khách hàng gia hạn dịch vụ và 2 khách hàng không gia hạn. Tỷ lệ hai lớp lần lượt là 0,8 và 0,2.
Gini = 1 - (0.8^2 + 0.2^2)
     = 1 - (0.64 + 0.04)
     = 0.32
Nếu cả 10 khách hàng đều gia hạn, Gini sẽ bằng 0. Điều này cho biết nhãn trong nút hoàn toàn đồng nhất theo dữ liệu huấn luyện.
Gini bằng 0 không có nghĩa mô hình luôn dự đoán đúng cho dữ liệu tương lai. Nó chỉ cho biết các quan sát trong nút huấn luyện thuộc cùng một lớp.
3.3. Thuật toán sử dụng Gini để chọn nhánh như thế nào?
Thuật toán không chỉ nhìn vào Gini của từng nút con một cách riêng lẻ. Nó thường tính độ hỗn tạp trung bình có trọng số sau khi chia, với trọng số phụ thuộc vào số quan sát ở mỗi nút con.
Gini_after_split =
    (N_left / N_parent) * Gini_left
  + (N_right / N_parent) * Gini_right

Gini_reduction =
    Gini_parent - Gini_after_split
Trong biểu thức trên, Nparent là số quan sát trước khi chia; Nleft và Nright là số quan sát ở hai nút con. Một cách chia có mức giảm Gini lớn hơn thường được ưu tiên nếu các điều kiện khác giống nhau.
4. Entropy và Information Gain
Entropy cũng đo độ không chắc chắn hoặc độ hỗn tạp của phân phối nhãn. Khái niệm này xuất phát từ Information Theory và được sử dụng trong nhiều thuật toán xây dựng cây quyết định.
4.1. Công thức Entropy
Entropy = -sum(p_k * log2(p_k))Quy ước, nếu pk bằng 0 thì thành phần pk log2(pk) được xem là bằng 0 trong giới hạn toán học.
Với bài toán hai lớp:
Entropy = -p_0*log2(p_0) - p_1*log2(p_1)Entropy bằng 0 khi nút chỉ có một lớp. Với hai lớp có tỷ lệ bằng nhau, Entropy đạt giá trị 1 bit.
4.2. Information Gain là gì?
Information Gain đo mức giảm Entropy sau khi chia một nút. Nếu một điều kiện phân chia tạo ra các nhóm con có nhãn đồng nhất hơn, Entropy trung bình sau chia sẽ thấp hơn và Information Gain sẽ cao hơn.
Information Gain =
    Entropy(parent)
    - Weighted Entropy(children)
Trong đó:
Weighted Entropy(children) =
    (N_left / N_parent) * Entropy(left)
  + (N_right / N_parent) * Entropy(right)
Ví dụ, một điều kiện chia khách hàng thành hai nhóm mà mỗi nhóm có tỷ lệ gia hạn khác biệt rõ ràng có thể đem lại Information Gain lớn. Ngược lại, nếu cả hai nhóm có phân phối nhãn gần giống nhau với nút gốc, điều kiện đó ít giúp ích hơn.
4.3. Gini và Entropy khác nhau thế nào?
| Tiêu chí | Gini Impurity | Entropy |
|---|---|---|
| Ý nghĩa | Đo độ hỗn tạp của nhãn | Đo độ không chắc chắn của phân phối nhãn |
| Công thức | 1 – tổng bình phương tỷ lệ lớp | – tổng p nhân log cơ số 2 của p |
| Giá trị thấp nhất | 0 khi nút chỉ có một lớp | 0 khi nút chỉ có một lớp |
| Cách sử dụng | Tiêu chí phổ biến cho Classification Tree | Tiêu chí phổ biến cho Classification Tree |
Hai tiêu chí có thể chọn cùng một cách chia hoặc tạo ra các cây khác nhau. Không có quy tắc rằng Entropy luôn tốt hơn Gini trong mọi bài toán. Nên đánh giá lựa chọn dựa trên hiệu quả tổng quát hóa và mục tiêu thực tế.
5. Decision Tree cho Regression hoạt động như thế nào?
Decision Tree không chỉ dùng cho Classification. Trong Regression, mô hình cũng chia không gian Feature thành các vùng, nhưng mục tiêu là tạo ra những nhóm có giá trị mục tiêu gần nhau thay vì tập trung vào độ thuần nhất của nhãn phân loại.
5.1. Ví dụ dự đoán giá nhà
Giả sử dữ liệu có các Feature như diện tích, số phòng ngủ và khoảng cách đến trung tâm. Target là giá nhà. Cây có thể chia các căn nhà theo diện tích trước, sau đó tiếp tục chia theo số phòng ngủ hoặc vị trí.
Mỗi Leaf Node dự đoán một giá trị đại diện cho nhóm dữ liệu đi vào nút đó. Với tiêu chí bình phương sai số, giá trị dự đoán tại nút lá thường là trung bình của Target trong nút.
5.2. Tiêu chí chia trong Regression Tree
Một lựa chọn phổ biến là Mean Squared Error (MSE):
MSE = (1/n) * sum((y_i - y_mean)^2)Trong đó yi là giá trị thực tế và ymean là giá trị trung bình trong nút. Thuật toán tìm cách chia sao cho tổng sai số của các nhóm con, có tính đến số lượng quan sát, giảm xuống.
Vì vậy, khác biệt cốt lõi giữa Classification Tree và Regression Tree không nằm ở cấu trúc cây, mà ở Target và tiêu chí đánh giá chất lượng của phép chia.
6. Vì sao Decision Tree dễ bị Overfitting?
Decision Tree có thể tiếp tục chia dữ liệu cho đến khi tạo ra các nút rất nhỏ. Nếu không giới hạn, cây có thể học cả những quy luật ngẫu nhiên hoặc nhiễu chỉ xuất hiện trong tập huấn luyện.
Đó là hiện tượng Overfitting: mô hình hoạt động rất tốt trên dữ liệu đã học nhưng kém hơn khi gặp các quan sát chưa từng thấy.
6.1. Ví dụ trực quan
Giả sử một cây dự đoán khách hàng rời bỏ dịch vụ. Nếu cây tạo ra quá nhiều điều kiện cụ thể, nó có thể học những quy tắc như “khách hàng có đúng 7 lần đăng nhập và mức chi tiêu bằng một giá trị nhất định sẽ rời bỏ”. Quy tắc này có thể chỉ phản ánh một vài trường hợp riêng biệt trong dữ liệu huấn luyện.
Một cây nông hơn có thể không khớp hoàn toàn dữ liệu huấn luyện, nhưng lại tổng quát hóa tốt hơn cho khách hàng mới. Vì vậy, mục tiêu không phải là tạo cây lớn nhất hoặc làm cho mọi Leaf Node đều thuần nhất, mà là tìm sự cân bằng giữa độ phù hợp và độ phức tạp.
6.2. Những cách kiểm soát Overfitting
| Tham số hoặc kỹ thuật | Vai trò |
|---|---|
max_depth |
Giới hạn độ sâu tối đa của cây |
min_samples_split |
Quy định số mẫu tối thiểu cần có tại nút để được phép chia |
min_samples_leaf |
Quy định số mẫu tối thiểu tại mỗi nút lá |
max_leaf_nodes |
Giới hạn số nút lá tối đa |
| Pruning | Cắt bỏ những nhánh không đem lại lợi ích đủ lớn theo tiêu chí đã chọn |
6.3. Pre-pruning và Post-pruning
Pre-pruning giới hạn cây ngay trong quá trình xây dựng, chẳng hạn giới hạn độ sâu hoặc yêu cầu số lượng mẫu tối thiểu. Cách này giúp cây không phát triển quá phức tạp ngay từ đầu.
Post-pruning bắt đầu bằng một cây lớn hơn rồi loại bỏ những nhánh không đủ hữu ích theo tiêu chí đánh giá. Trong scikit-learn, tham số ccp_alpha điều khiển Minimal Cost-Complexity Pruning: mức phạt độ phức tạp cao hơn thường tạo ra cây nhỏ hơn.
Các tham số kiểm soát độ phức tạp nên được lựa chọn bằng Validation hoặc Cross-Validation. Không nên chọn chỉ dựa vào kết quả trên tập Train.
7. Ví dụ Python: Xây dựng Decision Tree bằng scikit-learn
Ví dụ dưới đây sử dụng bộ dữ liệu Iris có sẵn trong scikit-learn để phân loại hoa thành ba loài. Mục tiêu là minh họa quy trình huấn luyện, dự đoán và đánh giá, không đưa ra một kết quả hiệu năng giả định.
7.1. Cài đặt thư viện
pip install scikit-learn matplotlib7.2. Huấn luyện mô hình Classification Tree
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix
)

# 1. Tải dữ liệu
data = load_iris()
X = data.data
y = data.target

# 2. Chia dữ liệu thành Train và Test
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

# 3. Khởi tạo mô hình
model = DecisionTreeClassifier(
    criterion="gini",
    max_depth=3,
    min_samples_leaf=2,
    random_state=42
)

# 4. Huấn luyện
model.fit(X_train, y_train)

# 5. Dự đoán
y_pred = model.predict(X_test)

# 6. Đánh giá
print("Accuracy:", accuracy_score(y_test, y_pred))

print("Confusion Matrix:")
print(confusion_matrix(y_test, y_pred))

print("Classification Report:")
print(
    classification_report(
        y_test,
        y_pred,
        target_names=data.target_names
    )
)
7.3. Giải thích đoạn code
load_iris()tải dữ liệu mẫu gồm các đặc trưng đo lường của hoa và nhãn loài tương ứng.train_test_split()tách dữ liệu thành tập huấn luyện và tập kiểm tra.stratify=ygiúp duy trì tỷ lệ lớp gần với dữ liệu ban đầu.criterion="gini"chọn Gini Impurity làm tiêu chí đánh giá phép chia.max_depth=3giới hạn độ sâu cây nhằm kiểm soát độ phức tạp.min_samples_leaf=2yêu cầu mỗi nút lá có ít nhất hai mẫu trong quá trình huấn luyện.fit()học các điều kiện phân chia từ tập Train.predict()sử dụng cây đã học để dự đoán nhãn cho tập Test.classification_report()cung cấp Precision, Recall và F1-score theo từng lớp.
Các tham số trong ví dụ là lựa chọn minh họa. Chúng không bảo đảm mô hình đạt hiệu quả tối ưu. Khi thực hiện dự án, nên thử các cấu hình khác nhau và đánh giá trên dữ liệu chưa được dùng để huấn luyện.
7.4. Trực quan hóa cây quyết định
Ưu điểm nổi bật của Decision Tree là có thể trực quan hóa các điều kiện mà mô hình sử dụng. Đoạn code sau hiển thị cấu trúc cây đã huấn luyện:
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree

plt.figure(figsize=(16, 9))

plot_tree(
    model,
    feature_names=data.feature_names,
    class_names=data.target_names,
    filled=True,
    rounded=True,
    proportion=True
)

plt.title("Decision Tree - Iris Classification")
plt.tight_layout()
plt.show()
Trong biểu đồ, mỗi nút thể hiện điều kiện chia hoặc dự đoán tại nút lá. Các thông tin như gini, samples và value giúp người đọc hiểu phân phối dữ liệu ở từng vị trí trong cây. Màu sắc được dùng để hỗ trợ nhận biết lớp chiếm ưu thế, không phải thước đo độc lập về độ chính xác trên dữ liệu mới.
8. Decision Tree có cần chuẩn hóa dữ liệu không?
Đối với Decision Tree dựa trên các phép chia theo ngưỡng đơn biến thông thường, việc chuẩn hóa như StandardScaler thường không cần thiết. Nếu một Feature được biến đổi theo phép biến đổi đơn điệu tăng, thứ tự các giá trị của Feature vẫn được giữ nguyên, nên các cách chia theo ngưỡng tương đương về mặt phân hoạch dữ liệu.
Ví dụ, cây có thể chia theo điều kiện diện tích nhà nhỏ hơn một ngưỡng nhất định mà không cần đưa diện tích về cùng thang đo với số phòng ngủ. Đây là khác biệt so với nhiều mô hình dựa trên tối ưu hóa hoặc khoảng cách, trong đó thang đo Feature có thể ảnh hưởng đáng kể đến quá trình học.
Tuy nhiên, điều này không có nghĩa mọi bước tiền xử lý đều không cần thiết. Vẫn cần xử lý đúng kiểu dữ liệu, mã hóa Feature phân loại theo cách thư viện hỗ trợ, kiểm tra giá trị thiếu và tránh Data Leakage. Khả năng xử lý giá trị thiếu trực tiếp còn phụ thuộc vào thuật toán và phiên bản thư viện.
9. Ưu điểm và hạn chế của Decision Tree
9.1. Ưu điểm
- Dễ diễn giải: các điều kiện phân chia có thể chuyển thành quy tắc dạng If-Then.
- Hỗ trợ Classification và Regression: cùng một ý tưởng cây có thể áp dụng cho nhãn phân loại hoặc giá trị số.
- Không đòi hỏi chuẩn hóa Feature trong cách chia ngưỡng thông thường: thuận tiện với dữ liệu có đơn vị đo khác nhau.
- Mô hình hóa quan hệ phi tuyến: các nhánh kết hợp tạo thành những vùng quyết định phức tạp hơn một ngưỡng tuyến tính đơn giản.
- Thể hiện tương tác giữa các Feature: điều kiện ở một nút có thể phụ thuộc vào nhánh đã đi qua trước đó.
9.2. Hạn chế
- Dễ Overfitting: cây quá sâu có thể học nhiễu và các trường hợp riêng biệt.
- Không ổn định: những thay đổi nhỏ trong dữ liệu huấn luyện có thể làm thay đổi cấu trúc cây.
- Ranh giới quyết định dạng bậc thang: các phép chia song song với trục Feature có thể không biểu diễn hiệu quả mọi dạng quan hệ.
- Khả năng ngoại suy hạn chế trong Regression: dự đoán tại nút lá thường là giá trị đại diện của dữ liệu huấn luyện trong vùng đó, nên khó ngoại suy xu hướng ra ngoài phạm vi đã quan sát.
- Feature Importance có thể gây hiểu nhầm: độ quan trọng dựa trên mức giảm impurity có thể thiên lệch với một số loại Feature và không chứng minh quan hệ nhân quả.
10. Decision Tree và các thuật toán liên quan
Decision Tree thường được xem là nền tảng để hiểu những mô hình Ensemble sử dụng nhiều cây. Thay vì phụ thuộc vào một cây duy nhất, các phương pháp này kết hợp nhiều cây theo những chiến lược khác nhau.
| Thuật toán | Ý tưởng chính | Khác biệt nổi bật |
|---|---|---|
| Decision Tree | Một cây học các điều kiện phân chia | Dễ trực quan hóa nhưng có thể không ổn định |
| Random Forest | Kết hợp nhiều cây được huấn luyện với tính ngẫu nhiên | Thường cải thiện độ ổn định và khả năng tổng quát hóa so với một cây đơn lẻ |
| Gradient Boosting | Xây dựng các cây tuần tự để cải thiện mô hình hiện tại | Có thể đạt hiệu quả cao nhưng cần tinh chỉnh cẩn thận |
Random Forest và Gradient Boosting là những hướng phát triển quan trọng từ cây quyết định. Tuy nhiên, nhiều cây kết hợp không còn dễ diễn giải bằng một sơ đồ đơn giản như một cây duy nhất.
11. Khi nào nên sử dụng Decision Tree?
Decision Tree là lựa chọn phù hợp để bắt đầu khi cần một mô hình dễ hiểu, có khả năng xử lý quan hệ phi tuyến và có thể chuyển thành các quy tắc ra quyết định. Các ứng dụng có thể bao gồm:
- Phân loại khách hàng theo nguy cơ rời bỏ dịch vụ.
- Hỗ trợ phân nhóm rủi ro trong quy trình đánh giá tín dụng.
- Dự đoán khả năng chuyển đổi của khách hàng tiềm năng.
- Ước lượng giá trị số như doanh thu hoặc giá nhà trong các bài toán Regression.
- Xây dựng mô hình Baseline để so sánh với Logistic Regression, Random Forest hoặc Gradient Boosting.
Tuy nhiên, với các quyết định có ảnh hưởng lớn đến con người, cần đánh giá thêm tính công bằng, khả năng giải thích, chất lượng dữ liệu và rủi ro khi mô hình sai. Một cây dễ đọc không đồng nghĩa với một mô hình luôn chính xác hoặc phù hợp để tự động ra quyết định.
12. Kết luận
Decision Tree mô phỏng quá trình ra quyết định bằng cách liên tục đặt câu hỏi về các Feature và chia dữ liệu thành những nhóm phù hợp hơn với mục tiêu dự đoán. Trong Classification, thuật toán thường dùng Gini Impurity hoặc Entropy để đánh giá chất lượng phép chia. Trong Regression, thuật toán có thể dùng MSE hoặc tiêu chí tương tự để tạo ra các vùng có giá trị mục tiêu gần nhau.
Điểm quan trọng nhất không chỉ là hiểu cách cây phân nhánh, mà còn hiểu vì sao thuật toán chọn một điều kiện thay vì điều kiện khác và tại sao cây quá phức tạp có thể Overfit. Việc kiểm soát độ sâu, số mẫu tối thiểu ở nút lá và Pruning giúp cân bằng giữa khả năng học dữ liệu huấn luyện và khả năng dự đoán trên dữ liệu mới.
Sau khi nắm được Decision Tree, bạn có thể tiếp tục tìm hiểu Random Forest và Gradient Boosting để hiểu cách kết hợp nhiều cây nhằm xây dựng các mô hình Machine Learning mạnh hơn.
13. Tài liệu tham khảo
- scikit-learn – Decision Trees: giải thích cấu trúc cây, tiêu chí phân chia, Classification, Regression và Pruning.
- scikit-learn – DecisionTreeClassifier API: tài liệu về tham số, tiêu chí Gini, Entropy, Log Loss và các tùy chọn kiểm soát độ phức tạp.
- Google for Developers – Growing Decision Trees: trình bày cách cây được xây dựng bằng việc lựa chọn điều kiện phân chia.
- Google for Developers – Machine Learning Glossary: Decision Forests: giải thích các khái niệm Gini Impurity, Entropy, Information Gain và những thuật ngữ liên quan.
14. Học Data, AI và Machine Learning cùng MCNA Technology School
Nếu bạn muốn phát triển nền tảng Python, phân tích dữ liệu và ứng dụng AI vào công việc, có thể tham khảo các chương trình học tại MCNA Technology School:
- Combo 5 khóa AI & Power BI: tìm hiểu các kỹ năng AI và trực quan hóa dữ liệu phục vụ công việc.
- Combo Python: xây dựng nền tảng Python để xử lý, phân tích dữ liệu và thực hành các thuật toán Machine Learning.
Tác giả
Nguyễn Quốc Hải – Data Analyst tại MCNA Technology School
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp lớn như Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
🌐 Website: mcna.vn
📘 Facebook: facebook.com/mcnatechnologyschool
▶️ YouTube: youtube.com/@mcna.technology.school
💼 LinkedIn: linkedin.com/company/mcna-vn
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B, TT2, Văn Quán, Hà Đông
📍 TP.HCM: The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu