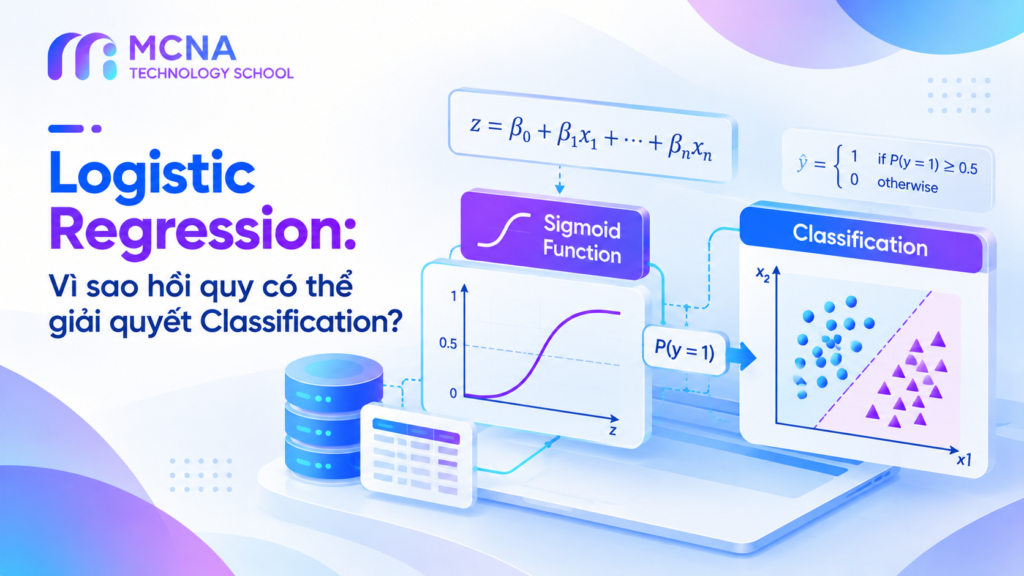
Đây là lúc Logistic Regression xuất hiện. Mặc dù có từ “Regression” trong tên gọi, thuật toán này chủ yếu được sử dụng cho các bài toán phân loại. Điểm mấu chốt nằm ở cách mô hình chuyển một tổ hợp tuyến tính của các đặc trưng thành xác suất, sau đó sử dụng ngưỡng quyết định để xác định nhãn.
Để hiểu rõ bản chất của thuật toán, bạn nên nắm được Supervised Learning, Regression và Classification, cũng như Linear Regression và cách mô hình học từ dữ liệu.
1. Logistic Regression là gì?
Logistic Regression là thuật toán Supervised Learning dùng để ước lượng xác suất một quan sát thuộc về một lớp nhất định. Từ xác suất này, mô hình có thể đưa ra quyết định phân loại theo một ngưỡng được lựa chọn.
Ví dụ, một ngân hàng muốn dự đoán khách hàng có khả năng vỡ nợ hay không. Dữ liệu đầu vào có thể bao gồm thu nhập, lịch sử thanh toán, dư nợ và thời gian làm việc. Nhãn mục tiêu được mã hóa thành hai giá trị:
- 0: Khách hàng không vỡ nợ.
- 1: Khách hàng vỡ nợ.
Thay vì trực tiếp dự đoán một giá trị liên tục như Linear Regression, Logistic Regression ước lượng xác suất khách hàng thuộc lớp 1. Chẳng hạn, mô hình có thể dự đoán xác suất vỡ nợ là 0,78, tương đương 78% theo ước lượng của mô hình.
Đây chỉ là ví dụ minh họa, không phải kết quả thực nghiệm. Xác suất dự đoán cũng không tự động đồng nghĩa với xác suất đã được hiệu chỉnh tốt; điều đó cần được đánh giá trên dữ liệu phù hợp.
1.1. Logistic Regression giải quyết những bài toán nào?
| Bài toán | Đầu vào minh họa | Lớp cần dự đoán |
|---|---|---|
| Email spam | Nội dung, từ khóa, thông tin người gửi | Spam / Không spam |
| Churn Prediction | Tần suất sử dụng, lịch sử giao dịch, thời gian gắn bó | Rời bỏ / Tiếp tục sử dụng |
| Credit Risk | Thu nhập, dư nợ, lịch sử tín dụng | Vỡ nợ / Không vỡ nợ |
| Fraud Detection | Giá trị giao dịch, thời gian, đặc điểm tài khoản | Nghi gian lận / Không nghi gian lận |
| Medical Screening | Các chỉ số và đặc trưng sức khỏe | Thuộc nhóm cần kiểm tra thêm / Nhóm còn lại |
Trong các ví dụ trên, Logistic Regression đưa ra dự đoán dựa trên những mẫu đã có nhãn. Mô hình không tự xác định nguyên nhân thực sự của một sự kiện và cũng không thay thế các quy trình chuyên môn như thẩm định tín dụng hoặc chẩn đoán y khoa.
2. Vì sao Logistic Regression có thể giải quyết Classification?
Để hiểu nghịch lý trong tên gọi, cần phân biệt ba việc: tính điểm từ dữ liệu, chuyển điểm thành xác suất và chuyển xác suất thành nhãn.
2.1. Vấn đề khi dùng Linear Regression cho Classification
Linear Regression xây dựng một tổ hợp tuyến tính của các đặc trưng:
z = b + w1*x1 + w2*x2 + ... + wn*xnTrong đó:
x1, x2, ..., xnlà các Feature đầu vào.w1, w2, ..., wnlà các hệ số mô hình cần học.blà Intercept.zlà điểm số tuyến tính mà mô hình tính được.
Với Regression, giá trị đầu ra có thể nằm trên toàn bộ trục số thực. Nhưng với bài toán phân loại nhị phân, ta thường mã hóa nhãn bằng 0 và 1, đồng thời muốn có một xác suất nằm trong khoảng từ 0 đến 1.
Nếu sử dụng trực tiếp đầu ra Linear Regression làm xác suất, mô hình có thể dự đoán giá trị âm hoặc lớn hơn 1. Chẳng hạn, đầu ra bằng 1,4 không thể được diễn giải trực tiếp là xác suất 140%.
Vấn đề không nằm ở việc tổ hợp tuyến tính vô dụng, mà ở chỗ đầu ra của nó chưa bị giới hạn trong miền xác suất hợp lệ.
2.2. Logistic Regression sử dụng hàm Sigmoid
Logistic Regression vẫn bắt đầu bằng một tổ hợp tuyến tính giống Linear Regression. Tuy nhiên, thay vì sử dụng trực tiếp điểm số này, mô hình đưa nó qua hàm Sigmoid để chuyển đổi thành xác suất.
Công thức Sigmoid:
sigmoid(z) = 1 / (1 + e^(-z))Trong đó, e là hằng số Euler và z là điểm số tuyến tính được tính từ các đặc trưng.
Hàm Sigmoid có các đặc điểm quan trọng:
- Đầu ra luôn nằm trong khoảng từ 0 đến 1.
- Khi z tăng, giá trị Sigmoid tăng.
- Khi z = 0, giá trị Sigmoid bằng 0,5.
- Khi z rất âm, đầu ra tiến gần 0; khi z rất dương, đầu ra tiến gần 1.
Nhờ đó, mô hình có thể chuyển điểm số chưa bị giới hạn thành giá trị có thể được diễn giải như xác suất dự đoán.
2.3. Ví dụ về cách Sigmoid chuyển đổi điểm số
| Điểm số z | Sigmoid(z), xấp xỉ | Diễn giải |
|---|---|---|
| -3 | 0,047 | Xác suất lớp 1 thấp |
| -1 | 0,269 | Xác suất lớp 1 dưới 50% |
| 0 | 0,500 | Hai lớp có xác suất dự đoán bằng nhau |
| 1 | 0,731 | Xác suất lớp 1 trên 50% |
| 3 | 0,953 | Xác suất lớp 1 cao |
Các giá trị trên được tính trực tiếp từ công thức Sigmoid, chỉ nhằm minh họa cách biến đổi toán học, không phải kết quả huấn luyện một mô hình cụ thể.
2.4. Từ xác suất đến nhãn phân loại
Sau khi tính xác suất, mô hình sử dụng một Decision Threshold để chuyển xác suất thành nhãn dự đoán. Ngưỡng mặc định thường là 0,5 trong cách triển khai nhị phân thông dụng, nhưng có thể điều chỉnh tùy mục tiêu kinh doanh và chi phí sai lầm.
Dữ liệu đầu vào X
       |
       v
Tổ hợp tuyến tính z = b + wX
       |
       v
Hàm Sigmoid
       |
       v
Xác suất P(y = 1 | X)
       |
       v
So sánh với Decision Threshold
       |
       +---- Xác suất >= ngưỡng ---> Dự đoán lớp 1
       |
       +---- Xác suất < ngưỡng ----> Dự đoán lớp 0
Ví dụ, nếu xác suất khách hàng rời bỏ dịch vụ là 0,72 và ngưỡng được chọn là 0,5, mô hình dự đoán khách hàng thuộc lớp rời bỏ. Nếu doanh nghiệp muốn phát hiện nhiều khách hàng có nguy cơ hơn, có thể cân nhắc giảm ngưỡng, đồng thời chấp nhận khả năng tăng số cảnh báo sai.
3. Công thức Logistic Regression từ góc nhìn toán học
3.1. Mô hình xác suất
Với bài toán Binary Classification, mô hình Logistic Regression có thể được biểu diễn như sau:
z = b + w1*x1 + w2*x2 + ... + wn*xn

P(y = 1 | X) = 1 / (1 + e^(-z))
Ký hiệu P(y = 1 | X) là xác suất có điều kiện để nhãn bằng 1 khi biết các đặc trưng X.
Giả sử cần dự đoán khả năng khách hàng đăng ký một dịch vụ dựa trên thu nhập và số lần tương tác với quảng cáo. Mô hình sẽ học hệ số cho từng đặc trưng từ dữ liệu lịch sử đã có nhãn. Sau đó, mô hình tính điểm số z và chuyển điểm số này thành xác suất đăng ký.
3.2. Logit và Log Odds là gì?
Đây là phần giúp giải thích vì sao thuật toán có chữ “Regression”. Logistic Regression không thực hiện hồi quy trực tiếp trên xác suất. Thay vào đó, nó mô hình hóa log-odds của sự kiện.
Với xác suất p, Odds được xác định bằng:
Odds = p / (1 - p)Odds biểu thị tỷ lệ giữa khả năng sự kiện xảy ra và khả năng sự kiện không xảy ra. Ví dụ, nếu p = 0,8 thì Odds = 0,8 / 0,2 = 4. Có thể diễn giải rằng khả năng xảy ra gấp 4 lần khả năng không xảy ra theo tỷ lệ Odds.
Log Odds, hay Logit, là logarit tự nhiên của Odds:
logit(p) = ln(p / (1 - p))Vì hàm Sigmoid là hàm nghịch đảo của Logit, mô hình có thể viết lại thành:
ln(p / (1 - p)) = b + w1*x1 + w2*x2 + ... + wn*xnĐây chính là điểm quan trọng: Logistic Regression giả định Log Odds có quan hệ tuyến tính với các đặc trưng, chứ không giả định xác suất p thay đổi tuyến tính theo X.
3.3. Diễn giải hệ số của mô hình
Trong Linear Regression, hệ số thường được diễn giải là mức thay đổi trung bình của giá trị dự đoán khi một đặc trưng tăng một đơn vị và các đặc trưng khác được giữ nguyên. Với Logistic Regression, hệ số có cách diễn giải khác.
- Hệ số dương: khi đặc trưng tăng, Log Odds của lớp 1 tăng nếu các yếu tố khác không đổi.
- Hệ số âm: khi đặc trưng tăng, Log Odds của lớp 1 giảm nếu các yếu tố khác không đổi.
- Hệ số bằng 0: đặc trưng không đóng góp vào Log Odds thông qua hệ số tuyến tính đó.
Để diễn giải hệ số theo Odds, có thể lấy hàm mũ của hệ số:
Odds Ratio = e^(w)Giả sử một hệ số bằng 0,7, Odds Ratio tương ứng là e^0,7, xấp xỉ 2,01. Khi các đặc trưng khác giữ nguyên, Odds của lớp 1 tăng khoảng 2,01 lần nếu đặc trưng đó tăng một đơn vị. Đây không có nghĩa xác suất tăng 2,01 lần, cũng không tự chứng minh quan hệ nhân quả.
Nếu các Feature được chuẩn hóa, “một đơn vị” cần được hiểu theo thang đo sau chuẩn hóa. Vì vậy, cần xem xét cách tiền xử lý trước khi giải thích hệ số.
4. Logistic Regression học từ dữ liệu như thế nào?
Trong quá trình huấn luyện, mô hình cần tìm các hệ số b, w1, w2,…, wn sao cho xác suất dự đoán phù hợp với nhãn thực tế. Khác với Ordinary Least Squares thường dùng cho Linear Regression, Logistic Regression phổ biến sử dụng phương pháp tối ưu hóa dựa trên hàm mất mát Log Loss.
4.1. Vì sao không dùng trực tiếp Mean Squared Error?
Mean Squared Error (MSE) đo bình phương chênh lệch giữa giá trị thực tế và giá trị dự đoán. Đây là lựa chọn quen thuộc trong Regression. Tuy nhiên, Logistic Regression thường sử dụng Log Loss vì hàm này gắn trực tiếp với xác suất của nhãn quan sát được và phù hợp với mô hình Bernoulli trong bài toán nhị phân.
4.2. Công thức Log Loss
Với một quan sát có nhãn y thuộc {0, 1} và xác suất dự đoán p cho lớp 1, Binary Cross-Entropy Loss được tính bằng:
Loss = -[y*ln(p) + (1-y)*ln(1-p)]Với toàn bộ n quan sát, hàm mất mát trung bình là:
Log Loss = -(1/n) * sum(
    y_i*ln(p_i) + (1-y_i)*ln(1-p_i)
)
Hàm mất mát có cách phản ứng trực quan:
- Nếu nhãn thực tế là 1, mô hình được khuyến khích dự đoán p gần 1.
- Nếu nhãn thực tế là 0, mô hình được khuyến khích dự đoán p gần 0.
- Nếu mô hình dự đoán rất tự tin nhưng sai, Log Loss sẽ phạt mạnh.
Trong tính toán thực tế, cần xử lý số học để tránh lấy log của 0. Các thư viện Machine Learning thường đã xử lý vấn đề này bên trong thuật toán.
4.3. Quá trình tối ưu hóa
Quá trình huấn luyện có thể được mô tả theo các bước:
- Khởi tạo các hệ số của mô hình.
- Tính điểm số tuyến tính từ Feature.
- Áp dụng Sigmoid để thu được xác suất dự đoán.
- Tính Log Loss giữa xác suất dự đoán và nhãn thực tế.
- Sử dụng thuật toán tối ưu để cập nhật hệ số nhằm giảm hàm mất mát.
- Lặp lại đến khi đạt điều kiện dừng của thuật toán.
Trong scikit-learn, Logistic Regression sử dụng các Solver như LBFGS và một số phương pháp tối ưu khác. Lựa chọn Solver phụ thuộc vào quy mô dữ liệu, số lượng Feature và cấu hình Regularization.
5. Linear Regression và Logistic Regression khác nhau thế nào?
Cả hai đều có thể sử dụng tổ hợp tuyến tính của các đặc trưng, nhưng mục tiêu, hàm đầu ra và cách huấn luyện khác nhau.
| Tiêu chí | Linear Regression | Logistic Regression |
|---|---|---|
| Mục tiêu chính | Dự đoán giá trị số liên tục | Ước lượng xác suất để phân loại |
| Đầu ra cơ bản | Giá trị thực trên trục số | Xác suất từ 0 đến 1 |
| Hàm đầu ra | Hàm tuyến tính | Hàm Logistic/Sigmoid trong bài toán nhị phân |
| Hàm mất mát phổ biến | MSE hoặc các biến thể phù hợp | Log Loss / Cross-Entropy |
| Cách đánh giá | MAE, MSE, RMSE, R² | Precision, Recall, F1, ROC-AUC, Log Loss |
| Ví dụ | Dự đoán giá nhà | Dự đoán khách hàng có rời bỏ dịch vụ hay không |
Điểm cần nhớ là tên gọi “Regression” trong Logistic Regression gắn với việc mô hình hóa Log Odds bằng một biểu thức tuyến tính. Trong thuật ngữ Machine Learning hiện đại, đây là một mô hình phân loại.
6. Binary Classification và Multiclass Classification
6.1. Binary Classification
Binary Classification là bài toán có hai lớp, chẳng hạn gian lận/không gian lận hoặc rời bỏ/tiếp tục sử dụng. Với cách mã hóa phổ biến, lớp mục tiêu được biểu diễn bằng 0 và 1. Sigmoid tạo ra xác suất cho lớp 1; xác suất lớp 0 bằng 1 trừ xác suất lớp 1.
P(y = 0 | X) = 1 - P(y = 1 | X)6.2. Multiclass Classification
Khi có từ ba lớp trở lên, chẳng hạn phân loại khách hàng thành nhóm A, B hoặc C, mô hình cần ước lượng xác suất cho từng lớp. Một số cách triển khai phổ biến là:
- One-vs-Rest (OvR): xây dựng một bộ phân loại cho mỗi lớp, phân biệt lớp đó với tất cả các lớp còn lại.
- Multinomial Logistic Regression: mô hình hóa xác suất của các lớp đồng thời, thường sử dụng hàm Softmax cho đầu ra đa lớp.
Không phải mọi cấu hình hoặc Solver đều hỗ trợ tất cả cách xử lý đa lớp. Khi triển khai, cần kiểm tra tài liệu của thư viện và phiên bản đang sử dụng.
7. Ví dụ Python: Xây dựng mô hình Logistic Regression
Để minh họa quy trình, ta sử dụng bộ dữ liệu Breast Cancer Wisconsin có sẵn trong scikit-learn. Đây là bộ dữ liệu phục vụ bài toán phân loại nhị phân. Ví dụ dưới đây tập trung vào cách chia dữ liệu, xây dựng Pipeline, huấn luyện mô hình và đánh giá kết quả, không giả định trước bất kỳ điểm số thực nghiệm nào.
7.1. Cài đặt thư viện
pip install scikit-learn pandas7.2. Xây dựng và huấn luyện mô hình
import pandas as pd

from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
    roc_auc_score,
    log_loss
)

# 1. Tải dữ liệu
data = load_breast_cancer(as_frame=True)

X = data.data
y = data.target

# 2. Chia dữ liệu thành Train và Test
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

# 3. Tạo Pipeline
model = Pipeline([
    ("scaler", StandardScaler()),
    ("logistic", LogisticRegression(max_iter=2000))
])

# 4. Huấn luyện mô hình
model.fit(X_train, y_train)

# 5. Dự đoán nhãn và xác suất
y_pred = model.predict(X_test)
y_prob = model.predict_proba(X_test)[:, 1]

# 6. Đánh giá mô hình
print("Accuracy:", accuracy_score(y_test, y_pred))
print("Log Loss:", log_loss(y_test, y_prob))
print("ROC-AUC:", roc_auc_score(y_test, y_prob))

print("\\nConfusion Matrix:")
print(confusion_matrix(y_test, y_pred))

print("\\nClassification Report:")
print(classification_report(
    y_test,
    y_pred,
    target_names=data.target_names
))
7.3. Giải thích các bước quan trọng
load_breast_cancer()tải dữ liệu mẫu để thực hành phân loại.train_test_split()chia dữ liệu thành tập huấn luyện và tập kiểm tra. Tham sốstratify=ygiúp giữ tỷ lệ lớp gần với dữ liệu ban đầu.StandardScaler()chuẩn hóa Feature dựa trên thống kê của tập huấn luyện. Khi dự đoán trên Test, Pipeline sử dụng lại thống kê đã học từ Train.LogisticRegression()khởi tạo mô hình phân loại Logistic Regression.predict()trả về nhãn dự đoán theo quy tắc phân loại của mô hình.predict_proba()trả về xác suất dự đoán cho từng lớp. Cột thứ hai trong ví dụ tương ứng với lớp có nhãn 1.classification_report()hiển thị Precision, Recall, F1-score và các chỉ số liên quan cho từng lớp.
Trong bộ dữ liệu này, tên lớp có thể khác cách diễn đạt quen thuộc như “dương tính” và “âm tính”. Cần kiểm tra data.target_names và ý nghĩa nhãn trước khi diễn giải kết quả. Với ứng dụng y tế thực tế, không nên dùng riêng một chỉ số hoặc một mô hình mẫu để đưa ra quyết định lâm sàng.
7.4. Vì sao cần chuẩn hóa dữ liệu?
Logistic Regression không yêu cầu mọi Feature phải có cùng đơn vị đo về mặt định nghĩa, nhưng việc chuẩn hóa thường hữu ích cho quá trình tối ưu hóa và Regularization. Ví dụ, một Feature có giá trị hàng nghìn trong khi Feature khác chỉ dao động từ 0 đến 1 có thể tạo ra thang đo rất khác nhau.
Đặt StandardScaler bên trong Pipeline giúp quá trình chuẩn hóa chỉ học thống kê từ Train, tránh sử dụng thông tin của Test trong bước tiền xử lý. Đây là một nguyên tắc quan trọng để hạn chế Data Leakage.
8. Đánh giá Logistic Regression bằng những chỉ số nào?
Không nên chỉ dựa vào Accuracy để kết luận mô hình tốt hay không. Đặc biệt, với dữ liệu mất cân bằng, Accuracy cao vẫn có thể đi kèm khả năng phát hiện lớp quan trọng rất kém.
| Chỉ số | Ý nghĩa | Khi nào hữu ích? |
|---|---|---|
| Accuracy | Tỷ lệ dự đoán đúng trên tổng số quan sát | Khi các lớp và chi phí sai lầm không gây mất cân đối nghiêm trọng |
| Precision | Trong các trường hợp dự đoán là lớp dương, tỷ lệ thực sự thuộc lớp dương | Khi cảnh báo sai gây tốn kém |
| Recall | Trong các trường hợp thực sự thuộc lớp dương, tỷ lệ được phát hiện | Khi bỏ sót trường hợp dương gây hậu quả lớn |
| F1-score | Trung bình điều hòa của Precision và Recall | Khi cần cân nhắc đồng thời hai chỉ số này |
| ROC-AUC | Đánh giá khả năng xếp hạng lớp dương cao hơn lớp âm qua các ngưỡng | Khi so sánh khả năng phân biệt của mô hình |
| Log Loss | Đánh giá chất lượng xác suất dự đoán và phạt dự đoán sai với độ tự tin cao | Khi chất lượng xác suất cũng quan trọng |
Precision và Recall thường được biểu diễn qua các thành phần của Confusion Matrix:
- True Positive (TP): dự đoán dương và thực tế dương.
- True Negative (TN): dự đoán âm và thực tế âm.
- False Positive (FP): dự đoán dương nhưng thực tế âm.
- False Negative (FN): dự đoán âm nhưng thực tế dương.
Precision = TP / (TP + FP)

Recall = TP / (TP + FN)

F1 = 2 * Precision * Recall
     / (Precision + Recall)
Trong thực tế, chỉ số phù hợp phụ thuộc vào mục tiêu của bài toán. Ví dụ, phát hiện gian lận có thể ưu tiên Recall để giảm bỏ sót, nhưng cần cân bằng với Precision để không tạo quá nhiều cảnh báo sai. Ngưỡng phân loại nên được lựa chọn trên tập Validation hoặc thông qua quy trình đánh giá phù hợp, không nên tối ưu trực tiếp trên Test.
9. Regularization và Overfitting trong Logistic Regression
Giống các mô hình Machine Learning khác, Logistic Regression có thể học quá sát dữ liệu huấn luyện, đặc biệt khi số lượng Feature lớn, dữ liệu nhiễu hoặc các đặc trưng có quan hệ phức tạp. Regularization là một cách hạn chế độ lớn của hệ số để cải thiện khả năng tổng quát hóa.
9.1. L1 Regularization
L1 thêm tổng giá trị tuyệt đối của các hệ số vào hàm mục tiêu:
Objective = Log Loss + lambda * sum(|w_j|)L1 có thể đưa một số hệ số về đúng 0, nhờ đó tạo ra mô hình thưa hơn. Đặc điểm này hữu ích khi muốn giảm số Feature, nhưng không đảm bảo luôn chọn được tập đặc trưng tối ưu về mặt nghiệp vụ.
9.2. L2 Regularization
L2 thêm tổng bình phương các hệ số vào hàm mục tiêu:
Objective = Log Loss + lambda * sum(w_j^2)L2 thường làm các hệ số nhỏ lại thay vì đưa nhiều hệ số về đúng 0. Trong scikit-learn, Logistic Regression có Regularization theo mặc định ở các cấu hình thông dụng; mức độ Regularization được điều chỉnh thông qua tham số như C. Giá trị C nhỏ hơn tương ứng với Regularization mạnh hơn trong cách tham số hóa của thư viện.
Trong triển khai thực tế, cần lựa chọn mức Regularization bằng Validation hoặc Cross-Validation, đồng thời kiểm tra tính tương thích giữa kiểu Regularization và Solver.
10. Ưu điểm và hạn chế của Logistic Regression
10.1. Ưu điểm
- Dễ diễn giải: có thể phân tích hệ số, Log Odds và Odds Ratio.
- Đầu ra xác suất: thuận tiện để xếp hạng rủi ro hoặc điều chỉnh ngưỡng quyết định, nhưng cần kiểm tra Calibration khi sử dụng xác suất cho quyết định quan trọng.
- Hiệu quả với dữ liệu dạng bảng: thường là một mô hình nền tảng hữu ích để xây dựng Baseline.
- Hỗ trợ Regularization: giúp kiểm soát độ lớn của hệ số và giảm nguy cơ Overfitting.
- Chi phí tính toán tương đối hợp lý: phù hợp với nhiều bài toán có cấu trúc dữ liệu vừa phải.
10.2. Hạn chế
- Quan hệ Log Odds tuyến tính: mô hình cơ bản có thể không mô tả tốt các quan hệ phi tuyến nếu không thiết kế thêm Feature hoặc biến đổi dữ liệu.
- Phụ thuộc chất lượng Feature: Feature không phù hợp hoặc dữ liệu thiếu đại diện có thể khiến mô hình dự đoán kém.
- Nhạy với cách xử lý dữ liệu: ngoại lệ, đa cộng tuyến và dữ liệu mất cân bằng có thể gây khó khăn cho việc huấn luyện hoặc diễn giải.
- Không tự học mọi tương tác phức tạp: nếu quan hệ giữa các Feature có tính tương tác hoặc phi tuyến, có thể cần bổ sung Feature hoặc thử mô hình khác.
- Xác suất không mặc nhiên được hiệu chỉnh tốt: cần đánh giá Calibration nếu xác suất đầu ra được sử dụng trực tiếp trong quyết định.
11. Quy trình áp dụng Logistic Regression trong dự án thực tế
Để sử dụng Logistic Regression một cách có hệ thống, có thể triển khai theo quy trình sau:
- Xác định bài toán: xác định nhãn cần dự đoán, đơn vị quan sát và mục tiêu kinh doanh.
- Kiểm tra dữ liệu: rà soát nhãn, giá trị thiếu, dữ liệu trùng lặp, mất cân bằng lớp và chất lượng Feature.
- Chia dữ liệu: tách Train, Validation và Test theo đặc điểm dữ liệu; với dữ liệu thời gian, cần tôn trọng thứ tự thời gian.
- Tiền xử lý: mã hóa biến phân loại, xử lý giá trị thiếu và chuẩn hóa Feature khi phù hợp.
- Huấn luyện Baseline: bắt đầu bằng Logistic Regression với cấu hình hợp lý.
- Đánh giá: sử dụng Confusion Matrix, Precision, Recall, F1, ROC-AUC hoặc Log Loss tùy mục tiêu.
- Tinh chỉnh: chọn Regularization, Solver và Decision Threshold trên dữ liệu Validation.
- Kiểm tra khả năng tổng quát hóa: chỉ sử dụng Test để đánh giá cuối cùng sau khi hoàn tất lựa chọn mô hình.
- Theo dõi sau triển khai: giám sát chất lượng dự đoán, sự thay đổi phân phối dữ liệu và hiệu quả thực tế theo thời gian.
Nếu muốn cải thiện mô hình, không nên chỉ tăng số vòng lặp hoặc thay đổi tham số một cách ngẫu nhiên. Trước hết cần xác định vấn đề đến từ chất lượng dữ liệu, thiết kế Feature, mất cân bằng lớp, ngưỡng quyết định hay giới hạn của mô hình.
12. Những hiểu lầm thường gặp về Logistic Regression
Hiểu lầm 1: Logistic Regression là Regression vì dự đoán số
Mô hình tạo ra một giá trị số là xác suất, nhưng mục tiêu sử dụng phổ biến là phân loại. Tên “Regression” phản ánh cấu trúc toán học của mô hình hóa Log Odds, không phải loại nhãn cuối cùng mà bài toán cần dự đoán.
Hiểu lầm 2: Xác suất 0,8 nghĩa là chắc chắn sự kiện xảy ra
Xác suất 0,8 là ước lượng của mô hình. Độ tin cậy của con số này phụ thuộc vào chất lượng dữ liệu, cách huấn luyện, tính đại diện của mẫu và khả năng Calibration.
Hiểu lầm 3: Ngưỡng phân loại luôn phải bằng 0,5
0,5 là ngưỡng mặc định phổ biến, không phải quy tắc bắt buộc cho mọi bài toán. Ngưỡng phù hợp phụ thuộc vào tỷ lệ lớp, chi phí False Positive, chi phí False Negative và mục tiêu sử dụng.
Hiểu lầm 4: Hệ số dương chứng minh Feature gây ra kết quả
Hệ số dương cho thấy mối liên hệ theo mô hình giữa Feature và Log Odds khi giữ các Feature khác không đổi. Nó không tự chứng minh quan hệ nhân quả; việc diễn giải còn phụ thuộc vào thiết kế nghiên cứu và chất lượng dữ liệu.
13. Kết luận
Logistic Regression cho thấy một mô hình có cấu trúc tuyến tính vẫn có thể giải quyết bài toán Classification nếu được kết hợp với hàm biến đổi phù hợp. Mô hình tính tổ hợp tuyến tính của các Feature, sử dụng Sigmoid để tạo xác suất, sau đó áp dụng Decision Threshold để đưa ra nhãn dự đoán.
Bản chất quan trọng nhất cần ghi nhớ là Logistic Regression mô hình hóa Log Odds như một hàm tuyến tính của các đặc trưng và thường được huấn luyện bằng cách tối ưu Log Loss. Nhờ khả năng diễn giải, đầu ra xác suất và quy trình triển khai tương đối rõ ràng, đây là thuật toán nền tảng đáng học trước khi chuyển sang các mô hình phức tạp hơn như Decision Tree, Random Forest hoặc Gradient Boosting.
Nếu đang học theo chuỗi bài Machine Learning, hãy xem lại bài Linear Regression để hiểu cấu trúc tuyến tính, sau đó kết hợp với bài Supervised Learning để phân biệt rõ mục tiêu của Regression và Classification.
14. Tài liệu tham khảo
- Google for Developers – Logistic Regression: giải thích xác suất, Sigmoid, Log Loss và Regularization.
- scikit-learn – LogisticRegression API Documentation: tài liệu về tham số, Solver, huấn luyện và dự đoán.
- scikit-learn – Generalized Linear Models: Logistic Regression: giải thích Logistic Regression như một mô hình tuyến tính cho Classification và các phương pháp Regularization.
15. Học Data, AI và Machine Learning cùng MCNA Technology School
Nếu bạn muốn củng cố nền tảng Python, phân tích dữ liệu và ứng dụng AI vào công việc, có thể tham khảo các chương trình học tại MCNA Technology School:
- Combo 5 khóa AI & Power BI: tìm hiểu các kỹ năng AI và trực quan hóa dữ liệu phục vụ công việc.
- Combo Python: xây dựng nền tảng lập trình Python để xử lý và phân tích dữ liệu.
Tác giả
Nguyễn Quốc Hải – Data Analyst tại MCNA Technology School
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp lớn như Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
🌐 Website: mcna.vn
📘 Facebook: facebook.com/mcnatechnologyschool
▶️ YouTube: youtube.com/@mcna.technology.school
💼 LinkedIn: linkedin.com/company/mcna-vn
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B, TT2, Văn Quán, Hà Đông
📍 TP.HCM: The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu