AI Guardrails là gì? Cách kiểm soát đầu ra và hành động của AI
Các ứng dụng AI hiện nay có thể trả lời câu hỏi, phân tích tài liệu, truy vấn dữ liệu và thực hiện hành động thông qua công cụ. Tuy nhiên, khả năng của mô hình không đồng nghĩa với việc mọi câu trả lời đều chính xác hoặc mọi hành động đều an toàn.
Một chatbot có thể vô tình tiết lộ thông tin nhạy cảm. Một ứng dụng RAG có thể sử dụng nhầm tài liệu không phù hợp. Một AI Agent có thể gọi sai công cụ hoặc thực hiện thao tác vượt quá quyền hạn được giao.
Để hạn chế những rủi ro này, nhà phát triển cần xây dựng các cơ chế kiểm tra và kiểm soát xuyên suốt quá trình xử lý. Một khái niệm quan trọng trong lĩnh vực này là AI Guardrails.
Trong bài viết này, MCNA Technology School sẽ giúp bạn hiểu AI Guardrails là gì, các loại guardrails phổ biến, cách triển khai trong ứng dụng LLM và AI Agent, cũng như những nguyên tắc cần chú ý khi xây dựng hệ thống AI an toàn hơn.
1. AI Guardrails là gì?
AI Guardrails là tập hợp các quy tắc, bộ lọc, cơ chế xác thực và biện pháp kiểm soát nhằm giúp hệ thống AI hoạt động trong những giới hạn được xác định.
Guardrails có thể được sử dụng để kiểm tra yêu cầu đầu vào, phát hiện nội dung không phù hợp, bảo vệ dữ liệu nhạy cảm, xác thực kết quả do mô hình tạo ra và kiểm soát các hành động thông qua công cụ.
Ví dụ, một chatbot chăm sóc khách hàng có thể áp dụng guardrails để:
- Chặn hoặc chuyển hướng những yêu cầu nằm ngoài phạm vi hỗ trợ.
- Phát hiện thông tin cá nhân và che dữ liệu nhạy cảm khi cần.
- Không tự khẳng định chính sách hoàn tiền nếu không có dữ liệu xác nhận.
- Chỉ cho phép truy cập thông tin thuộc phạm vi quyền của người dùng.
- Yêu cầu xác nhận trước khi thực hiện một hành động quan trọng.
Guardrails không phải một mô hình AI duy nhất hay một bộ lọc có thể giải quyết mọi vấn đề. Đây là cách tiếp cận kết hợp nhiều lớp kiểm soát, được thiết kế theo mục tiêu và mức độ rủi ro của ứng dụng.
2. Vì sao ứng dụng AI cần Guardrails?
LLM có khả năng tạo ra nội dung linh hoạt, nhưng đầu ra của mô hình vẫn có thể chứa thông tin sai, không tuân thủ yêu cầu hoặc không phù hợp với ngữ cảnh sử dụng.
Rủi ro còn tăng lên khi mô hình được kết nối với dữ liệu nội bộ, API hoặc các công cụ có thể thực hiện hành động ngoài hệ thống AI.
2.1. Hạn chế câu trả lời sai hoặc thiếu căn cứ
Mô hình có thể tạo ra câu trả lời nghe hợp lý nhưng không được dữ liệu hỗ trợ. Với ứng dụng tư vấn sản phẩm, hỗ trợ kỹ thuật hoặc phân tích dữ liệu, điều này có thể khiến người dùng đưa ra quyết định dựa trên thông tin không chính xác.
Guardrails có thể kết hợp kiểm tra định dạng, đối chiếu nguồn dữ liệu, xác thực các trường bắt buộc hoặc đánh giá mức độ hỗ trợ của bằng chứng trước khi trả lời.
Tuy nhiên, một bộ lọc đầu ra đơn giản không thể bảo đảm mọi câu trả lời đều đúng. Những hệ thống cần độ chính xác cao phải có cơ chế đánh giá phù hợp với từng loại nhiệm vụ.
2.2. Bảo vệ dữ liệu nhạy cảm
Người dùng có thể nhập số điện thoại, địa chỉ email, mã khách hàng hoặc thông tin nội bộ vào cuộc hội thoại. Trong khi đó, ứng dụng có thể truy xuất thêm dữ liệu từ hệ thống doanh nghiệp.
Guardrails có thể giúp phát hiện, che hoặc ngăn việc đưa những thông tin không được phép vào đầu vào hay đầu ra. Dù vậy, bảo vệ dữ liệu còn đòi hỏi phân quyền truy cập, quản lý lưu trữ, chính sách ghi log và kiểm soát dữ liệu ở tầng ứng dụng.
2.3. Ngăn hành động vượt quá quyền hạn
AI Agent có thể được cấp quyền gọi API, cập nhật bản ghi hoặc gửi thông báo. Nếu không có cơ chế kiểm soát, một quyết định sai có thể dẫn đến hành động ngoài ý muốn.
Guardrails có thể kiểm tra tên công cụ, tham số, quyền thực thi và điều kiện phê duyệt trước khi hành động được tiến hành.
2.4. Giảm rủi ro từ Prompt Injection
Prompt Injection là một dạng tấn công trong đó nội dung đầu vào hoặc tài liệu được đưa vào context tìm cách thao túng hành vi của mô hình.
Ví dụ, một tài liệu được truy xuất có thể chứa hướng dẫn yêu cầu AI bỏ qua quy tắc ban đầu và tiết lộ dữ liệu. Nếu ứng dụng không phân biệt nội dung tài liệu với chỉ dẫn có thẩm quyền, mô hình có thể bị dẫn dắt sai.
Guardrails là một phần trong chiến lược giảm thiểu rủi ro này, nhưng không nên được xem là giải pháp bảo vệ tuyệt đối. Cần kết hợp phân quyền, cô lập dữ liệu, kiểm soát công cụ và kiểm thử bảo mật.
3. Các loại AI Guardrails phổ biến
Guardrails có thể được triển khai tại nhiều thời điểm trong quy trình xử lý của ứng dụng AI. Một cách phân loại hữu ích là dựa trên vị trí mà cơ chế kiểm soát được áp dụng.
3.1. Input Guardrails – Kiểm soát đầu vào
Input Guardrails kiểm tra yêu cầu trước khi chuyển đến mô hình chính.
Các kiểm tra có thể bao gồm:
- Phát hiện nội dung vi phạm chính sách sử dụng.
- Nhận diện yêu cầu độc hại hoặc dấu hiệu jailbreak.
- Kiểm tra định dạng và giới hạn độ dài đầu vào.
- Phát hiện hoặc che thông tin cá nhân khi phù hợp.
- Kiểm tra người dùng có quyền thực hiện yêu cầu hay không.
Ví dụ, một chatbot nội bộ có thể từ chối yêu cầu truy xuất dữ liệu mà người dùng không có quyền xem trước khi truy vấn được thực thi.
3.2. Output Guardrails – Kiểm soát đầu ra
Output Guardrails kiểm tra phản hồi do mô hình tạo ra trước khi gửi đến người dùng hoặc chuyển sang bước xử lý tiếp theo.
Các cơ chế thường gặp gồm:
- Kiểm tra nội dung có tuân thủ chính sách hay không.
- Xác thực cấu trúc JSON hoặc các trường bắt buộc.
- Phát hiện dữ liệu nhạy cảm trong câu trả lời.
- Đối chiếu những tuyên bố quan trọng với nguồn dữ liệu.
- Chặn, chỉnh sửa hoặc yêu cầu tạo lại phản hồi khi cần.
Ví dụ, nếu ứng dụng yêu cầu đầu ra ở dạng JSON, hệ thống có thể xác thực dữ liệu bằng schema trước khi chuyển sang phần mềm khác sử dụng kết quả.
3.3. Retrieval Guardrails – Kiểm soát dữ liệu truy xuất
Với ứng dụng RAG, hệ thống thường tìm kiếm tài liệu liên quan rồi đưa những đoạn phù hợp vào context của LLM. Retrieval Guardrails kiểm tra dữ liệu ở giai đoạn này.
Các kiểm tra có thể bao gồm:
- Đảm bảo tài liệu thuộc nguồn được phép sử dụng.
- Lọc dữ liệu dựa trên quyền truy cập của người dùng.
- Loại bỏ hoặc che thông tin nhạy cảm.
- Kiểm tra metadata, nguồn gốc và trạng thái của tài liệu.
- Phát hiện nội dung không đáng tin cậy trước khi đưa vào context.
Điểm quan trọng là quyền truy cập cần được kiểm tra ở tầng truy xuất dữ liệu, không chỉ dựa vào việc yêu cầu LLM không tiết lộ thông tin.
3.4. Tool Guardrails – Kiểm soát việc gọi công cụ
Tool Guardrails kiểm tra những lời gọi công cụ mà ứng dụng AI đề xuất hoặc chuẩn bị thực hiện.
Ví dụ, một AI Agent có thể được phép đọc báo cáo nhưng không được tự ý xóa dữ liệu hoặc gửi email hàng loạt.
Trước khi thực thi, hệ thống có thể kiểm tra:
- Công cụ có nằm trong danh sách được phép không.
- Tham số đầu vào có hợp lệ không.
- Người dùng và agent có đủ quyền thực hiện hành động không.
- Hành động có vượt giới hạn về số lượng, thời gian hoặc chi phí không.
- Có cần người dùng xác nhận trước khi tiếp tục không.
Đây là lớp kiểm soát đặc biệt quan trọng với agent có khả năng thay đổi dữ liệu hoặc tương tác với hệ thống bên ngoài.
3.5. Workflow Guardrails – Kiểm soát quy trình
Với các ứng dụng nhiều bước, guardrails có thể kiểm soát trình tự xử lý, giới hạn số lần gọi công cụ và xác định điều kiện để chuyển sang bước tiếp theo.
Ví dụ, một agent xử lý yêu cầu hoàn tiền có thể phải kiểm tra đơn hàng, đối chiếu chính sách và chờ nhân viên phê duyệt trước khi gửi yêu cầu đến hệ thống thanh toán.
Cơ chế này giúp tránh việc agent tự chuyển từ một yêu cầu ngôn ngữ tự nhiên sang hành động có tác động lớn mà không qua các bước xác minh cần thiết.
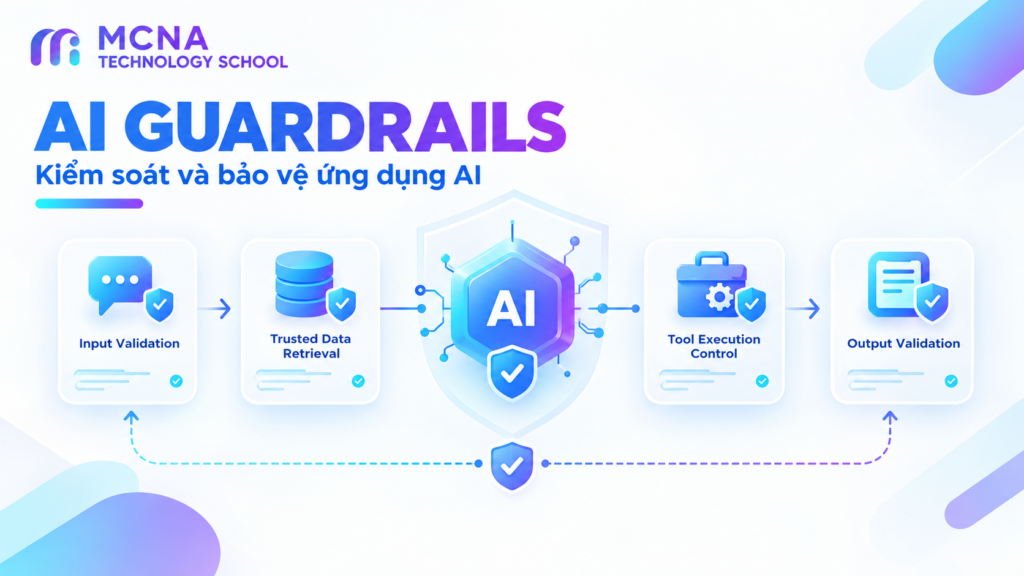
4. Guardrails hoạt động trong hệ thống LLM như thế nào?
Một hệ thống có thể kết hợp nhiều lớp guardrails thay vì chỉ kiểm tra câu trả lời cuối cùng.
Người dùng gửi yêu cầu
        |
        v
Kiểm tra đầu vào
        |
        v
Truy xuất dữ liệu cần thiết
        |
        v
Kiểm tra dữ liệu truy xuất
        |
        v
LLM xử lý yêu cầu
        |
        v
Kiểm tra lời gọi công cụ
        |
        v
Thực thi công cụ nếu được phép
        |
        v
Kiểm tra đầu ra cuối cùng
        |
        v
Trả kết quả cho người dùng
Sơ đồ trên là mô hình minh họa. Không phải mọi ứng dụng đều cần tất cả các bước, và thứ tự thực tế có thể khác nhau tùy kiến trúc.
Ví dụ, với một chatbot chỉ trả lời câu hỏi đơn giản, input và output guardrails có thể là điểm khởi đầu. Với một hệ thống RAG, cần bổ sung kiểm tra dữ liệu truy xuất. Với AI Agent có thể cập nhật dữ liệu, việc xác thực tool và kiểm soát quyền thực thi trở nên quan trọng hơn.
5. Ví dụ thực tế: Xây dựng guardrails cho chatbot doanh nghiệp
Giả sử doanh nghiệp xây dựng chatbot nội bộ để trả lời câu hỏi về chính sách nhân sự và tra cứu thông tin nghỉ phép.
Chatbot sử dụng LLM để hiểu yêu cầu, tìm kiếm tài liệu nội bộ và gọi API khi cần truy vấn thông tin cá nhân của nhân viên.
Một thiết kế guardrails có thể gồm những lớp sau:
| Giai đoạn | Quy tắc kiểm soát | Hành động khi không đạt |
|---|---|---|
| Đầu vào | Kiểm tra yêu cầu và xác thực người dùng | Từ chối hoặc yêu cầu xác thực bổ sung |
| Truy xuất tài liệu | Chỉ lấy tài liệu người dùng được phép xem | Loại bỏ kết quả không đủ quyền truy cập |
| Gọi API | Kiểm tra quyền và tham số của yêu cầu | Chặn lời gọi không hợp lệ |
| Đầu ra | Kiểm tra dữ liệu nhạy cảm và định dạng phản hồi | Che dữ liệu, yêu cầu sửa hoặc chặn phản hồi |
| Hành động nhạy cảm | Yêu cầu phê duyệt khi cần | Tạm dừng cho đến khi được xác nhận |
Ví dụ, khi nhân viên hỏi về số ngày nghỉ còn lại, chatbot cần xác thực danh tính và chỉ truy vấn dữ liệu thuộc tài khoản của người đó. Không nên chỉ dựa vào prompt kiểu “không tiết lộ dữ liệu của người khác”, bởi quy tắc ngôn ngữ không thay thế được kiểm soát truy cập ở tầng hệ thống.
Nếu chatbot được yêu cầu thay đổi thông tin nghỉ phép, ứng dụng nên xác minh tham số, kiểm tra chính sách và áp dụng cơ chế xác nhận phù hợp trước khi cập nhật dữ liệu.
Trong trường hợp này, guardrails không chỉ kiểm tra câu trả lời. Chúng kiểm soát toàn bộ đường đi từ yêu cầu đến dữ liệu, công cụ và hành động.
6. Một số công cụ và framework hỗ trợ Guardrails
Nhà phát triển có thể xây dựng các cơ chế kiểm soát trực tiếp trong ứng dụng hoặc sử dụng thư viện chuyên biệt. Lựa chọn phù hợp phụ thuộc vào mô hình AI, kiến trúc hệ thống và loại rủi ro cần xử lý.
6.1. NVIDIA NeMo Guardrails
NVIDIA NeMo Guardrails là thư viện hỗ trợ xây dựng các quy tắc kiểm soát cho ứng dụng LLM. Thư viện tổ chức guardrails theo những giai đoạn như input, retrieval, dialog, execution và output.
Cách tổ chức này giúp nhà phát triển xác định rõ cơ chế nào cần áp dụng trước khi gọi mô hình, khi truy xuất dữ liệu, khi thực thi công cụ hoặc trước khi trả kết quả.
6.2. Guardrails trong OpenAI Agents SDK
OpenAI Agents SDK cung cấp cơ chế kiểm tra đầu vào và đầu ra cho các agent. Nhà phát triển có thể sử dụng guardrails để xác thực yêu cầu hoặc phản hồi và quyết định khi nào cần chặn quy trình.
Với những tác vụ có rủi ro cao, ứng dụng cũng cần kết hợp kiểm soát công cụ và quy trình phê duyệt phù hợp thay vì chỉ kiểm tra văn bản đầu vào và đầu ra.
6.3. Tự xây dựng guardrails ở tầng ứng dụng
Không phải quy tắc nào cũng cần một mô hình AI khác để đánh giá. Nhiều kiểm tra có thể được triển khai bằng logic thông thường, chẳng hạn:
- Xác thực dữ liệu bằng schema.
- Kiểm tra quyền truy cập theo tài khoản.
- Giới hạn số lần gọi API.
- Kiểm tra phạm vi giá trị của tham số.
- Yêu cầu xác nhận trước khi thực hiện hành động nhạy cảm.
Các quy tắc có điều kiện rõ ràng thường nên được thực thi bằng logic có thể kiểm tra và dự đoán được. Mô hình AI có thể hỗ trợ đánh giá những trường hợp ngôn ngữ phức tạp, nhưng không nên là lớp bảo vệ duy nhất cho các thao tác quan trọng.
7. Những giới hạn cần biết khi sử dụng Guardrails
7.1. Không thể bảo đảm an toàn tuyệt đối
Guardrails có thể bỏ sót một số trường hợp hoặc đánh giá nhầm nội dung hợp lệ. Một hệ thống an toàn cần nhiều lớp bảo vệ và được kiểm thử liên tục.
7.2. Có thể chặn nhầm yêu cầu hợp lệ
Nếu quy tắc quá nghiêm ngặt, ứng dụng có thể từ chối những yêu cầu hoàn toàn bình thường. Nhà phát triển cần đánh giá cả khả năng phát hiện rủi ro lẫn tỷ lệ chặn nhầm để cân bằng giữa an toàn và trải nghiệm người dùng.
7.3. Tăng độ trễ và chi phí
Mỗi lớp kiểm tra bổ sung có thể làm tăng thời gian xử lý. Nếu sử dụng một mô hình khác để đánh giá mọi yêu cầu, chi phí vận hành cũng có thể tăng đáng kể.
Có thể giảm tác động bằng cách dùng kiểm tra đơn giản cho các quy tắc rõ ràng, chỉ áp dụng đánh giá phức tạp khi cần và ưu tiên kiểm soát theo mức độ rủi ro.
7.4. Không thay thế bảo mật hệ thống
Guardrails không thay thế xác thực, phân quyền, quản lý bí mật, mã hóa, kiểm soát mạng hoặc các biện pháp bảo mật truyền thống.
Ví dụ, nếu API cho phép agent truy cập mọi bản ghi mà không kiểm tra quyền của người dùng, một bộ lọc prompt sẽ không đủ để giải quyết lỗ hổng đó. Kiểm soát cần được thực thi ở đúng tầng hệ thống.
8. Cách đánh giá hiệu quả của Guardrails
Để biết guardrails có hoạt động hiệu quả hay không, nhà phát triển nên xây dựng bộ kiểm thử gồm cả trường hợp bình thường và trường hợp có rủi ro.
Một số chỉ số có thể theo dõi gồm:
- Detection rate: Tỷ lệ phát hiện các trường hợp cần chặn trong bộ kiểm thử.
- False positive rate: Tỷ lệ yêu cầu hợp lệ bị chặn nhầm.
- Policy compliance: Mức độ tuân thủ quy tắc đã xác định.
- Unauthorized action rate: Tỷ lệ hành động không được phép trong các tình huống kiểm thử.
- Latency: Thời gian xử lý tăng thêm do các bước kiểm tra.
- Cost per request: Chi phí trung bình cho mỗi yêu cầu sau khi bổ sung guardrails.
Các chỉ số cần được xác định rõ cách tính và kiểm tra trên những tình huống đại diện cho môi trường sử dụng thực tế. Chỉ số tốt trong một bộ dữ liệu nhỏ không đồng nghĩa với việc hệ thống sẽ an toàn trong mọi tình huống.
Ngoài kiểm thử tự động, nên xem xét các tình huống lỗi, ghi nhận những trường hợp guardrails hoạt động sai và cập nhật quy tắc theo kết quả đánh giá.
9. Kết luận
AI Guardrails là một phần quan trọng trong quá trình xây dựng ứng dụng LLM và AI Agent đáng tin cậy hơn. Chúng giúp kiểm soát đầu vào, dữ liệu truy xuất, lời gọi công cụ và đầu ra của mô hình theo những quy tắc được xác định.
Thay vì chỉ yêu cầu mô hình “hãy trả lời an toàn”, nhà phát triển nên kết hợp các cơ chế kiểm tra ở nhiều tầng, thực thi phân quyền tại hệ thống, xác thực hành động và yêu cầu con người phê duyệt khi cần thiết.
Không có một bộ guardrails phù hợp cho mọi ứng dụng. Thiết kế tốt cần bắt đầu từ việc xác định rủi ro, lựa chọn các lớp kiểm soát tương ứng, đo lường hiệu quả và liên tục cải thiện dựa trên kết quả kiểm thử thực tế.
Tài liệu tham khảo
- OWASP – Top 10 for Large Language Model Applications
- NVIDIA NeMo Guardrails – Guardrail Types
- OpenAI Agents SDK – Guardrails
Tìm hiểu thêm tại MCNA Technology School
Nếu bạn muốn xây dựng nền tảng về xử lý dữ liệu, Python và ứng dụng AI, hãy tham khảo các chương trình học tại MCNA Technology School: