Reranking là gì? Cách AI sắp xếp lại kết quả tìm kiếm để cải thiện RAG
Trong một hệ thống tìm kiếm thông minh, tìm được tài liệu liên quan chưa chắc đã đủ. Hệ thống còn cần xác định tài liệu nào thực sự phù hợp nhất với câu hỏi của người dùng.
Ví dụ, khi người dùng hỏi về cách xử lý lỗi kết nối cơ sở dữ liệu, hệ thống có thể tìm thấy nhiều tài liệu liên quan đến SQL, mạng máy tính, cấu hình máy chủ và xử lý lỗi. Tuy nhiên, không phải tài liệu nào cũng trực tiếp giải quyết vấn đề đang được hỏi.
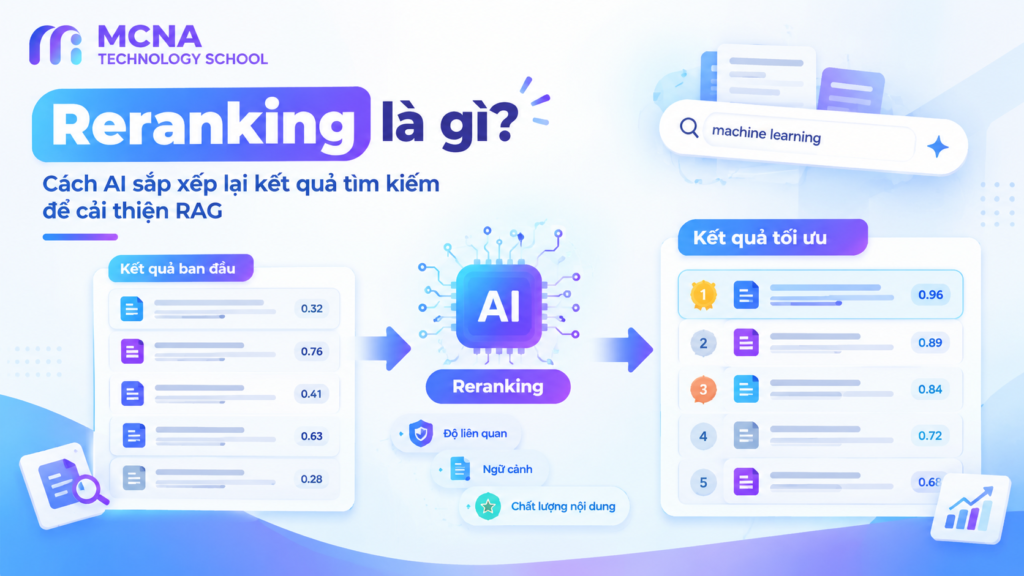
Đây là lúc Reranking phát huy tác dụng. Thay vì sử dụng nguyên thứ tự kết quả từ bước tìm kiếm ban đầu, hệ thống đánh giá lại các tài liệu ứng viên và sắp xếp chúng theo mức độ liên quan đến truy vấn.
Trong các ứng dụng AI hiện đại, Reranking thường được sử dụng cùng Semantic Search, Hybrid Search và RAG để cải thiện chất lượng truy xuất thông tin.
1. Reranking là gì?
Reranking là kỹ thuật đánh giá và sắp xếp lại các kết quả đã được truy xuất dựa trên mức độ liên quan của chúng với truy vấn.
Để hiểu đơn giản, hãy hình dung một hệ thống tìm kiếm gồm hai giai đoạn:
- Retrieval: tìm một tập hợp tài liệu có khả năng liên quan đến câu hỏi.
- Reranking: đánh giá lại tập hợp đó và đưa những tài liệu phù hợp hơn lên đầu danh sách.
Ví dụ, người dùng hỏi:
Làm thế nào để giảm overfitting trong Machine Learning?
Hệ thống tìm kiếm ban đầu có thể trả về các tài liệu về:
- Regularization trong Machine Learning.
- Dropout trong Neural Network.
- Data Augmentation.
- Feature Engineering.
- Các thuật toán phân loại.
Mặc dù các tài liệu đều có liên quan đến Machine Learning, nhưng mức độ hữu ích đối với câu hỏi không giống nhau.
Reranking giúp đánh giá lại những tài liệu này theo đúng câu hỏi cụ thể, từ đó ưu tiên các nội dung trực tiếp giải thích cách giảm overfitting.
2. Vì sao cần Reranking?
2.1. Retrieval ban đầu không phải lúc nào cũng xếp hạng chính xác
Các hệ thống tìm kiếm thường sử dụng những thuật toán tương đối nhanh để truy xuất tài liệu từ một kho dữ liệu lớn.
Ví dụ, Keyword Search có thể sử dụng BM25, còn Semantic Search có thể sử dụng Embedding và Vector Search.
Những phương pháp này giúp thu hẹp tập dữ liệu cần xem xét. Tuy nhiên, tài liệu được truy xuất ở vị trí đầu tiên chưa chắc là tài liệu hữu ích nhất đối với câu hỏi cụ thể.
2.2. Tìm thấy từ khóa chưa đồng nghĩa với hiểu đúng câu hỏi
Giả sử người dùng hỏi:
Model nào phù hợp khi dữ liệu huấn luyện ít?
Một tài liệu có thể chứa nhiều từ khóa liên quan đến Machine Learning nhưng chủ yếu giải thích cách xử lý dữ liệu lớn. Một tài liệu khác có thể nói trực tiếp về transfer learning và fine-tuning khi dữ liệu hạn chế.
Reranking có thể giúp phân biệt mức độ liên quan giữa các tài liệu này bằng cách đánh giá mối quan hệ giữa truy vấn và nội dung tài liệu.
2.3. Context ảnh hưởng đến chất lượng RAG
Trong RAG, các tài liệu được truy xuất sẽ được đưa vào context để LLM sử dụng khi tạo câu trả lời.
Nếu context chứa nhiều nội dung không liên quan, hệ thống có thể lãng phí token, tăng độ trễ và khiến mô hình khó tập trung vào thông tin quan trọng.
Reranking giúp chọn ra những đoạn phù hợp hơn trước khi chuyển dữ liệu cho LLM. Tuy nhiên, hiệu quả thực tế phụ thuộc vào chất lượng dữ liệu, mô hình Reranker và cách thiết kế pipeline.
3. Reranking hoạt động như thế nào?
Một pipeline tìm kiếm có Reranking thường được chia thành hai giai đoạn chính: truy xuất ứng viên và xếp hạng lại.
User Query
    |
    v
Initial Retrieval
(Keyword / Vector / Hybrid Search)
    |
    v
Candidate Documents
    |
    v
Reranker Model
    |
    v
Relevance Scores
    |
    v
Re-ranked Documents
    |
    v
Top Documents
3.1. Bước 1: Truy xuất tài liệu ứng viên
Hệ thống sử dụng một phương pháp tìm kiếm để lấy ra một tập hợp tài liệu có khả năng liên quan đến truy vấn.
Ví dụ, kho dữ liệu có một triệu đoạn văn bản. Thay vì đưa toàn bộ một triệu đoạn vào Reranker, hệ thống có thể chỉ lấy ra một số lượng nhỏ hơn, chẳng hạn 50 hoặc 100 đoạn ứng viên.
Đây chỉ là ví dụ minh họa. Số lượng tài liệu thực tế cần được lựa chọn dựa trên quy mô dữ liệu, yêu cầu về chất lượng, độ trễ và chi phí.
3.2. Bước 2: Đánh giá từng tài liệu với truy vấn
Reranker nhận truy vấn cùng nội dung của từng tài liệu ứng viên để ước lượng mức độ liên quan.
Ví dụ:
Query:
"Làm thế nào để giảm overfitting?"

Document A:
"Regularization giúp hạn chế độ phức tạp của mô hình."

Document B:
"SQL JOIN kết hợp dữ liệu từ nhiều bảng."

Document C:
"Dropout là kỹ thuật thường dùng để giảm overfitting
trong Neural Network."
Reranker có thể đánh giá Document A và Document C là những kết quả phù hợp hơn Document B.
3.3. Bước 3: Sắp xếp lại thứ tự
Sau khi tính điểm liên quan, hệ thống sắp xếp các tài liệu theo thứ tự mới.
| Tài liệu | Thứ hạng ban đầu | Thứ hạng sau Reranking |
|---|---|---|
| Document A: Regularization | 3 | 2 |
| Document B: SQL JOIN | 1 | 3 |
| Document C: Dropout | 2 | 1 |
Bảng trên là ví dụ giả định nhằm minh họa việc thay đổi thứ hạng. Các điểm số và vị trí thực tế phụ thuộc vào mô hình, dữ liệu và truy vấn.
4. Reranking khác gì với Retrieval?
Retrieval và Reranking là hai giai đoạn có mục tiêu khác nhau trong hệ thống tìm kiếm nhiều tầng.
| Tiêu chí | Retrieval | Reranking |
|---|---|---|
| Mục tiêu | Tìm các tài liệu ứng viên | Sắp xếp lại các tài liệu ứng viên |
| Phạm vi dữ liệu | Có thể là kho dữ liệu rất lớn | Thường là tập ứng viên nhỏ hơn |
| Ưu tiên thiết kế | Tốc độ và khả năng tìm được tài liệu liên quan | Độ chính xác trong đánh giá mức độ liên quan |
| Phương pháp | BM25, Vector Search, Hybrid Search | Cross-Encoder hoặc mô hình Reranker chuyên dụng |
| Đầu ra | Danh sách tài liệu ứng viên | Danh sách được xếp hạng lại |
Cần lưu ý rằng Reranking thông thường sắp xếp lại những tài liệu đã được truy xuất. Nó không tự động tìm được tài liệu chưa xuất hiện trong tập ứng viên.
Nếu tài liệu phù hợp bị bỏ sót ở bước Retrieval, Reranking không thể đưa tài liệu đó lên đầu danh sách vì nó chưa có trong tập đầu vào.
5. Bi-Encoder và Cross-Encoder là gì?
Để hiểu cách Reranking hoạt động, cần phân biệt hai cách tiếp cận thường gặp trong các hệ thống truy xuất ngữ nghĩa: Bi-Encoder và Cross-Encoder.
5.1. Bi-Encoder
Bi-Encoder mã hóa truy vấn và tài liệu một cách riêng biệt thành các vector.
Query
  |
  v
Encoder
  |
  v
Query Vector

Document
  |
  v
Encoder
  |
  v
Document Vector

Query Vector + Document Vector
               |
               v
       Similarity Score
Vì embedding của tài liệu có thể được tính trước và lưu lại, hệ thống có thể tìm kiếm hiệu quả trên kho dữ liệu lớn bằng các kỹ thuật vector search.
Ưu điểm chính của Bi-Encoder là tốc độ và khả năng mở rộng. Tuy nhiên, việc so sánh thường dựa trên các vector đã được tạo riêng biệt, nên mức độ tương tác trực tiếp giữa truy vấn và nội dung tài liệu bị hạn chế.
5.2. Cross-Encoder
Cross-Encoder nhận truy vấn và tài liệu cùng lúc làm đầu vào, sau đó dự đoán điểm liên quan cho cặp dữ liệu đó.
Query + Document
        |
        v
   Cross-Encoder
        |
        v
  Relevance Score
Do có thể xem xét mối quan hệ giữa các từ trong truy vấn và tài liệu cùng lúc, Cross-Encoder thường phù hợp với giai đoạn Reranking cần đánh giá chi tiết các ứng viên.
Đổi lại, mô hình cần xử lý từng cặp truy vấn – tài liệu, khiến chi phí tính toán thường cao hơn so với việc chỉ so sánh các embedding đã được tạo trước.
5.3. So sánh Bi-Encoder và Cross-Encoder
| Tiêu chí | Bi-Encoder | Cross-Encoder |
|---|---|---|
| Cách xử lý | Mã hóa riêng truy vấn và tài liệu | Xử lý truy vấn cùng tài liệu |
| Vector tài liệu | Có thể tính trước và lưu lại | Thường cần chấm điểm theo từng cặp đầu vào |
| Tốc độ truy xuất quy mô lớn | Thường nhanh hơn | Thường chậm hơn khi đánh giá nhiều ứng viên |
| Độ chi tiết khi so sánh | Dựa trên biểu diễn vector riêng biệt | Có thể mô hình hóa tương tác giữa truy vấn và tài liệu |
| Vai trò thường gặp | Embedding và Retrieval | Reranking |
Đây là cách phân biệt phổ biến, không phải quy tắc tuyệt đối. Lựa chọn mô hình cần dựa trên bài toán, dữ liệu và yêu cầu vận hành cụ thể.
6. Reranking trong Hybrid Search
Ở bài viết trước, Hybrid Search đã được giới thiệu như phương pháp kết hợp Keyword Search và Semantic Search.
Hybrid Search có thể tạo ra một danh sách ứng viên chất lượng bằng cách tận dụng cả khớp từ khóa và tương đồng ngữ nghĩa. Tuy nhiên, kết quả sau khi kết hợp vẫn có thể chứa tài liệu chưa thực sự phù hợp với câu hỏi cụ thể.
Reranking có thể được sử dụng như một tầng đánh giá tiếp theo.
               User Query
                    |
          +---------+---------+
          |                   |
          v                   v
     Keyword Search      Vector Search
          |                   |
          +---------+---------+
                    |
                    v
              Hybrid Fusion
                    |
                    v
            Candidate Documents
                    |
                    v
                 Reranker
                    |
                    v
             Final Ranked List
Trong kiến trúc này:
- Keyword Search hỗ trợ tìm những tài liệu khớp với từ khóa.
- Vector Search tìm những tài liệu có ý nghĩa gần với truy vấn.
- Hybrid Fusion kết hợp các danh sách kết quả.
- Reranker đánh giá lại các ứng viên theo truy vấn cụ thể.
Không phải hệ thống nào cũng cần cả Hybrid Search lẫn Reranking. Việc thêm từng thành phần nên được quyết định dựa trên kết quả đánh giá thực tế.
7. Reranking được sử dụng như thế nào trong RAG?
RAG (Retrieval-Augmented Generation) kết hợp truy xuất thông tin với mô hình ngôn ngữ lớn để tạo câu trả lời dựa trên dữ liệu được cung cấp.
Trong một pipeline RAG có Reranking, quá trình có thể diễn ra như sau:
User Question
      |
      v
Initial Retrieval
      |
      v
Candidate Chunks
      |
      v
Reranking
      |
      v
Top Relevant Chunks
      |
      v
Context Construction
      |
      v
LLM
      |
      v
Final Answer
Giả sử doanh nghiệp xây dựng chatbot hỏi đáp dựa trên tài liệu nội bộ. Khi nhân viên hỏi về chính sách nghỉ phép, hệ thống có thể tìm được nhiều đoạn liên quan đến nhân sự, hợp đồng lao động và quy trình xin nghỉ.
Reranking có thể giúp ưu tiên những đoạn trực tiếp trả lời câu hỏi về chính sách nghỉ phép, thay vì đưa toàn bộ tài liệu ứng viên vào context.
Điều này có thể mang lại một số lợi ích:
- Cải thiện mức độ liên quan của context.
- Giảm số lượng đoạn văn bản cần chuyển cho LLM.
- Hỗ trợ lựa chọn những tài liệu phù hợp hơn khi giới hạn context.
- Có thể cải thiện chất lượng câu trả lời nếu bước truy xuất ban đầu đã tìm được các tài liệu cần thiết.
Reranking không bảo đảm LLM luôn trả lời đúng. Chất lượng câu trả lời vẫn phụ thuộc vào tài liệu nguồn, quá trình truy xuất, cách xây dựng context và khả năng của mô hình sinh.
8. Ví dụ về Reranking trong chatbot tài liệu
Giả sử người dùng hỏi:
“Nhân viên cần làm gì để xin nghỉ phép?”
Hệ thống Retrieval ban đầu tìm được ba đoạn tài liệu:
| Đoạn | Nội dung |
|---|---|
| A | Quy trình gửi yêu cầu nghỉ phép và phê duyệt của quản lý. |
| B | Chính sách tính lương và phụ cấp của nhân viên. |
| C | Hướng dẫn cập nhật thông tin cá nhân trên hệ thống nhân sự. |
Giả sử thứ hạng ban đầu là B, C, A do cách tính điểm của hệ thống tìm kiếm.
Sau khi đánh giá từng đoạn cùng câu hỏi, Reranker có thể đưa đoạn A lên đầu vì nó trực tiếp giải thích quy trình xin nghỉ phép.
Đoạn A sau đó được ưu tiên đưa vào context của LLM để tạo câu trả lời.
Đây là ví dụ minh họa. Trong triển khai thực tế, kết quả phụ thuộc vào mô hình và nội dung tài liệu.
9. Cách đánh giá hiệu quả của Reranking
Không nên mặc định rằng thêm Reranking sẽ luôn làm hệ thống tốt hơn. Cần đánh giá bằng tập truy vấn đại diện cho nhu cầu thực tế.
9.1. Precision@K
Precision@K đo tỷ lệ tài liệu liên quan trong K kết quả đầu tiên.
Chỉ số này hữu ích khi hệ thống chỉ có thể sử dụng một số lượng nhỏ tài liệu đầu vào.
9.2. Recall@K
Recall@K đo tỷ lệ tài liệu liên quan được tìm thấy trong K kết quả đầu tiên so với tổng số tài liệu liên quan đã biết.
Chỉ số này giúp đánh giá khả năng hệ thống tìm được các tài liệu cần thiết.
9.3. MRR
Mean Reciprocal Rank đánh giá vị trí xuất hiện của kết quả liên quan đầu tiên trong danh sách tìm kiếm.
MRR đặc biệt hữu ích khi mục tiêu là đưa ít nhất một câu trả lời phù hợp lên vị trí đầu.
9.4. nDCG@K
Normalized Discounted Cumulative Gain đánh giá chất lượng xếp hạng và có thể xét đến nhiều mức độ liên quan khác nhau của tài liệu.
Chỉ số này hữu ích khi không phải tất cả tài liệu liên quan đều có giá trị như nhau.
9.5. Đánh giá đầu ra RAG
Ngoài chất lượng truy xuất, cần đánh giá cả câu trả lời cuối cùng của hệ thống, chẳng hạn:
- Câu trả lời có đúng với tài liệu nguồn không?
- Thông tin quan trọng có bị bỏ sót không?
- Câu trả lời có bám sát câu hỏi không?
- Hệ thống có sử dụng nguồn phù hợp không?
- Độ trễ và chi phí có chấp nhận được không?
Một quy trình đánh giá tốt nên so sánh cùng một tập truy vấn giữa hệ thống cơ sở và hệ thống có Reranking, thay vì chỉ đánh giá dựa trên một vài ví dụ đơn lẻ.
10. Hạn chế của Reranking
10.1. Tăng độ trễ
Reranking bổ sung một bước tính toán sau Retrieval. Nếu phải đánh giá quá nhiều tài liệu hoặc sử dụng mô hình lớn, thời gian phản hồi có thể tăng đáng kể.
10.2. Tăng chi phí vận hành
Việc chạy mô hình Reranker có thể yêu cầu tài nguyên máy chủ hoặc chi phí API bổ sung. Vì vậy, hệ thống thường chỉ áp dụng Reranking cho một tập ứng viên có kích thước được kiểm soát.
10.3. Không thể sửa mọi lỗi của Retrieval
Nếu tài liệu phù hợp không được tìm thấy ở bước đầu tiên, Reranking không thể tự đưa tài liệu đó vào danh sách ứng viên.
Do đó, cần cân bằng giữa khả năng truy xuất đủ rộng ở bước đầu và khả năng xếp hạng chính xác ở bước sau.
10.4. Phụ thuộc vào mô hình và dữ liệu
Một Reranker được huấn luyện trên dữ liệu hoặc ngôn ngữ không phù hợp có thể đánh giá sai mức độ liên quan. Các hệ thống đa ngôn ngữ hoặc có thuật ngữ chuyên ngành cần được kiểm tra kỹ bằng dữ liệu thực tế.
11. Khi nào nên sử dụng Reranking?
Reranking đáng cân nhắc khi:
- Retrieval trả về nhiều tài liệu nhưng thứ hạng chưa phù hợp.
- Chatbot RAG thường đưa ra câu trả lời dựa trên context chưa sát câu hỏi.
- Hệ thống cần lựa chọn một số ít đoạn tài liệu từ tập ứng viên lớn hơn.
- Hybrid Search đã hoạt động nhưng chất lượng kết quả đầu danh sách vẫn chưa đáp ứng yêu cầu.
- Chất lượng tìm kiếm quan trọng hơn phần chi phí và độ trễ bổ sung.
Ngược lại, nếu hệ thống nhỏ, truy vấn đơn giản hoặc kết quả tìm kiếm hiện tại đã đáp ứng yêu cầu, việc bổ sung Reranking có thể không mang lại lợi ích đủ lớn so với chi phí.
12. Tổng kết
Reranking là kỹ thuật sắp xếp lại các tài liệu đã được truy xuất theo mức độ liên quan với truy vấn.
Những khái niệm quan trọng cần ghi nhớ:
- Retrieval: tìm tập hợp tài liệu ứng viên.
- Reranking: đánh giá lại và sắp xếp các ứng viên.
- Bi-Encoder: mã hóa truy vấn và tài liệu riêng biệt, phù hợp với việc tạo embedding và truy xuất hiệu quả.
- Cross-Encoder: đánh giá truy vấn cùng tài liệu để tính điểm liên quan chi tiết hơn.
- Hybrid Search: kết hợp các phương pháp tìm kiếm như Keyword Search và Vector Search.
- RAG: sử dụng tài liệu truy xuất làm context cho mô hình sinh câu trả lời.
Có thể tóm tắt một pipeline RAG có Reranking như sau:
User Query
    |
    v
Retrieval
    |
    v
Candidate Documents
    |
    v
Reranking
    |
    v
Relevant Context
    |
    v
LLM
    |
    v
Answer
Hiểu rõ Reranking giúp bạn nhìn nhận hệ thống RAG như một pipeline nhiều giai đoạn, trong đó chất lượng câu trả lời không chỉ phụ thuộc vào LLM mà còn phụ thuộc vào cách tìm kiếm và lựa chọn thông tin đầu vào.
Tài liệu tham khảo
- Elastic – Semantic Reranking
- Elastic – Ranking and Reranking
- Cohere – Master Reranking with Cohere Models
- Cohere – Basic RAG
- Lewis et al. – Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Khám phá thêm tại MCNA Technology School
Nếu bạn muốn tìm hiểu thêm về Data, AI và các ứng dụng trí tuệ nhân tạo, hãy tham khảo các chương trình học tại MCNA Technology School:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
MCNA Technology School là đơn vị tiên phong đào tạo AI, Big Data, Business Intelligence tại Việt Nam. Chuyên sâu về Power BI, Python, SQL và Data Analytics — đối tác đào tạo của 300+ doanh nghiệp.
Đối tác đào tạo: Viettel Global, Masan Group, Techcombank, VPBank, Daikin.
- 🌐 mcna.vn
- 📘 facebook.com/mcnatechnologyschool
- ▶️ youtube.com/@mcna.technology.school
- 💼 linkedin.com/company/mcna-vn
- 📞 0939.866.825 (Mr. Minh Khang)
- 📍 30 Trung Liệt, Đống Đa, Hà Nội
- 📍 Liền kề 44B, TT2, Văn Quán, Hà Đông, Hà Nội
- 📍 The BIB Space, 50B Phan Tây Hồ, Cầu Kiệu, TPHCM