Semantic Search là gì? Cách AI tìm kiếm theo ngữ nghĩa
Trong các hệ thống tìm kiếm truyền thống, khi người dùng nhập một câu truy vấn, hệ thống thường cố gắng tìm những tài liệu có chứa các từ khóa giống hoặc gần giống với truy vấn đó. Tuy nhiên, cách tiếp cận này có một hạn chế lớn: từ khóa giống nhau không phải lúc nào cũng có nghĩa giống nhau, và những câu có ý nghĩa giống nhau chưa chắc sử dụng cùng một từ khóa.
Đây là vấn đề mà Semantic Search hướng tới giải quyết. Thay vì chỉ quan tâm đến việc một từ xuất hiện bao nhiêu lần, Semantic Search cố gắng hiểu ý nghĩa, ngữ cảnh và mối quan hệ giữa các khái niệm trong truy vấn và dữ liệu.
Semantic Search là một thành phần quan trọng trong nhiều ứng dụng AI hiện đại như chatbot, hệ thống hỏi đáp tài liệu, RAG, tìm kiếm sản phẩm và các hệ thống AI Agent.
1. Semantic Search là gì?
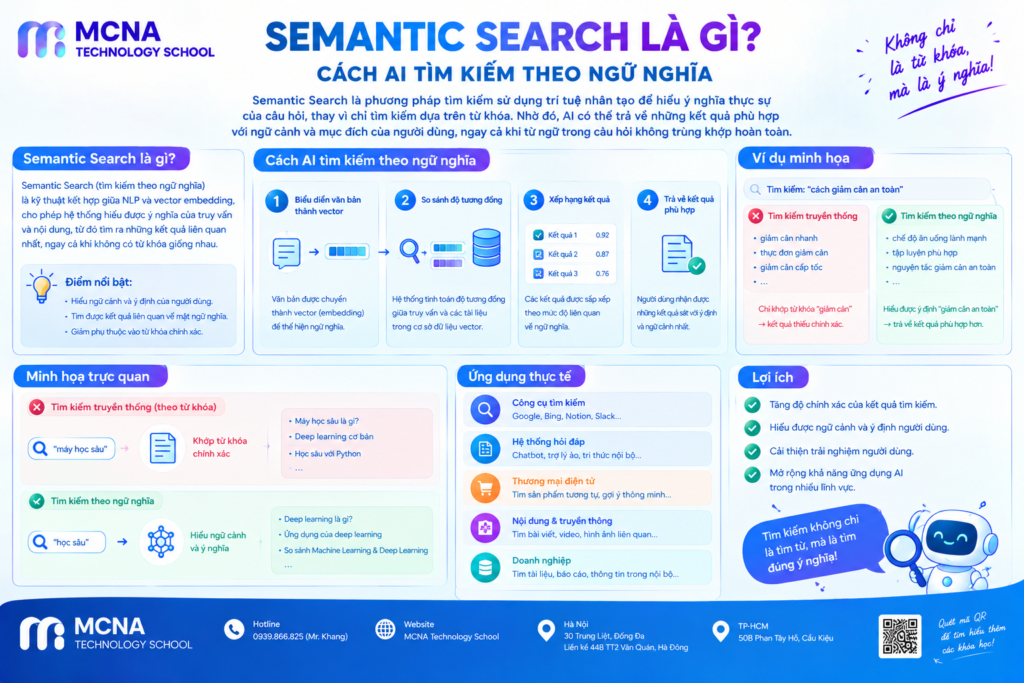
Semantic Search là phương pháp tìm kiếm thông tin dựa trên ý nghĩa của truy vấn và nội dung, thay vì chỉ dựa trên sự trùng khớp của từ khóa.
Nói đơn giản, hệ thống không chỉ hỏi:
“Trong tài liệu có những từ nào giống với câu hỏi của người dùng?”
Mà cố gắng trả lời câu hỏi:
“Tài liệu nào đang nói về vấn đề có ý nghĩa gần với điều người dùng muốn tìm?”
Ví dụ, người dùng tìm kiếm:
“Làm thế nào để giảm mức tiêu thụ điện của laptop?”
Một hệ thống tìm kiếm dựa trên từ khóa có thể ưu tiên những tài liệu chứa các từ như “giảm”, “tiêu thụ”, “điện”, “laptop”.
Trong khi đó, Semantic Search có thể nhận ra rằng một tài liệu nói về:
- Tiết kiệm pin cho máy tính xách tay.
- Tối ưu Power Mode trên Windows.
- Giảm mức sử dụng CPU và màn hình.
- Kéo dài thời lượng pin.
có thể vẫn rất phù hợp với câu hỏi, dù tài liệu không sử dụng chính xác cụm từ “giảm mức tiêu thụ điện của laptop”.
2. Keyword Search và Semantic Search khác nhau như thế nào?
Để hiểu Semantic Search, trước tiên cần phân biệt nó với cách tìm kiếm truyền thống.
2.1. Keyword Search
Keyword Search tập trung vào việc tìm kiếm sự xuất hiện hoặc mức độ liên quan của các từ khóa trong dữ liệu.
Ví dụ:
Query: “machine learning course”
Hệ thống có thể ưu tiên những tài liệu chứa các từ:
- machine
- learning
- course
Phương pháp này đơn giản, nhanh và vẫn rất hữu ích trong nhiều trường hợp.
Tuy nhiên, nó có thể gặp khó khăn khi người dùng sử dụng cách diễn đạt khác với nội dung trong tài liệu.
2.2. Semantic Search
Semantic Search tập trung vào ý nghĩa thay vì chỉ kiểm tra từ khóa.
Ví dụ, các câu sau có cách viết khác nhau:
- “How can I learn Python?”
- “What is the best way to study Python?”
- “I want to start learning Python.”
Về mặt từ khóa, chúng không hoàn toàn giống nhau.
Nhưng về mặt ngữ nghĩa, cả ba đều đề cập đến một ý tưởng tương tự: học Python.
Semantic Search cố gắng phát hiện mối quan hệ này.
3. Semantic Search hoạt động như thế nào?
Một hệ thống Semantic Search hiện đại thường sử dụng Embedding để chuyển văn bản thành các vector số.
Quá trình có thể được hình dung đơn giản như sau:
Văn bản
   ↓
Embedding Model
   ↓
Vector
   ↓
Vector Database
   ↓
Similarity Search
   ↓
Các kết quả liên quan
Thay vì lưu và so sánh văn bản chỉ dưới dạng chuỗi ký tự, hệ thống biểu diễn nội dung dưới dạng một không gian vector.
3.1. Bước 1: Chuyển văn bản thành Embedding
Đầu tiên, một mô hình Embedding sẽ chuyển câu hoặc đoạn văn thành một vector số.
Ví dụ minh họa:
"How to learn Python?"
        ↓
[0.21, -0.15, 0.72, 0.08, ...]
Vector thực tế thường có nhiều chiều hơn rất nhiều. Các con số này tạo thành một biểu diễn toán học cho nội dung văn bản.
Điểm quan trọng là những nội dung có ý nghĩa gần nhau thường được biểu diễn bởi những vector có vị trí gần nhau trong không gian vector.
3.2. Bước 2: Lưu Embedding
Embedding của các tài liệu có thể được lưu trong một Vector Database.
Mỗi bản ghi thường có thể bao gồm:
- Nội dung hoặc một phần nội dung.
- Embedding vector.
- Metadata.
- ID hoặc thông tin tham chiếu đến tài liệu.
Ví dụ:
Document A
    ↓
Embedding A

Document B
    ↓
Embedding B

Document C
    ↓
Embedding C
3.3. Bước 3: Chuyển truy vấn thành Embedding
Khi người dùng đặt câu hỏi, câu hỏi cũng được đưa qua cùng hoặc tương thích với mô hình Embedding để tạo ra một vector.
User Query
    ↓
Embedding Model
    ↓
Query Vector
3.4. Bước 4: Tính độ tương đồng
Hệ thống sau đó so sánh Query Vector với các vector của tài liệu để tìm những nội dung có mức độ tương đồng cao.
Một trong những phương pháp phổ biến là Cosine Similarity.
Về trực giác, Cosine Similarity đo mức độ gần nhau về hướng giữa hai vector.
Công thức có thể biểu diễn như sau:
cos(A, B) = (A · B) / (||A|| ||B||)
Giá trị càng cao thường cho thấy hai vector càng gần nhau về mặt ngữ nghĩa.
4. Ví dụ trực quan về Semantic Search
Giả sử một hệ thống có ba tài liệu:
| Tài liệu | Nội dung |
|---|---|
| A | Cách học Python cho người mới bắt đầu |
| B | Các kỹ thuật tối ưu truy vấn SQL |
| C | Hướng dẫn bắt đầu lập trình bằng Python |
Người dùng nhập:
“Tôi muốn bắt đầu học Python.”
Semantic Search có thể nhận ra rằng tài liệu A và C có ý nghĩa rất gần với truy vấn, dù cách diễn đạt không hoàn toàn giống nhau.
Kết quả có thể được hình dung:
                 Query
        "Bắt đầu học Python"
                 |
       ---------------------
       |         |         |
      Doc A     Doc B     Doc C
       ↑                   ↑
   Similarity cao      Similarity cao
Doc B có thể có mức độ tương đồng thấp hơn vì nói về SQL thay vì học Python.
5. Embedding đóng vai trò gì?
Embedding là một trong những thành phần quan trọng nhất của Semantic Search.
Thay vì biểu diễn câu bằng chính các từ xuất hiện trong câu, Embedding tạo ra một biểu diễn vector nhằm giữ lại nhiều thông tin về ngữ nghĩa của nội dung.
Ví dụ:
"car"
"automobile"
"vehicle"
Các từ này khác nhau về mặt ký tự nhưng có mối quan hệ về ý nghĩa.
Một mô hình Embedding tốt có thể biểu diễn những khái niệm liên quan ở những vị trí gần nhau trong không gian vector.
Điều này tạo nền tảng cho việc tìm kiếm theo ngữ nghĩa.
6. Semantic Search và Vector Database
Semantic Search thường đi cùng với Vector Database, đặc biệt khi hệ thống cần tìm kiếm trên một lượng lớn dữ liệu.
Vector Database được thiết kế để lưu trữ và truy vấn các vector một cách hiệu quả.
Quy trình tổng quát:
Documents
    ↓
Chunking
    ↓
Embedding
    ↓
Vector Database
    ↓
User Query
    ↓
Query Embedding
    ↓
Similarity Search
    ↓
Relevant Documents
Trong hệ thống thực tế, Vector Database có thể sử dụng các kỹ thuật Approximate Nearest Neighbor để tìm những vector gần nhất mà không cần so sánh tuần tự với toàn bộ dữ liệu.
7. Semantic Search trong RAG
Một trong những ứng dụng quan trọng nhất của Semantic Search là RAG – Retrieval-Augmented Generation.
Trong một hệ thống RAG, người dùng đặt câu hỏi và hệ thống trước tiên tìm kiếm những đoạn thông tin liên quan từ nguồn dữ liệu.
Các đoạn thông tin này sau đó được đưa vào LLM làm context để tạo câu trả lời.
User Question
      ↓
Query Embedding
      ↓
Semantic Search
      ↓
Relevant Documents
      ↓
Context
      ↓
LLM
      ↓
Answer
Nhờ đó, chatbot có thể trả lời dựa trên dữ liệu riêng của doanh nghiệp hoặc tài liệu mà hệ thống được cung cấp.
Ví dụ, một doanh nghiệp có thể xây dựng chatbot nội bộ dựa trên:
- Tài liệu nhân sự.
- Quy trình nội bộ.
- Tài liệu sản phẩm.
- Tài liệu kỹ thuật.
- Cơ sở kiến thức của doanh nghiệp.
Khi nhân viên đặt câu hỏi, Semantic Search có thể tìm ra những đoạn tài liệu liên quan trước khi LLM tạo câu trả lời.
8. Semantic Search khác gì với RAG?
Hai khái niệm này thường xuất hiện cùng nhau nhưng không giống nhau.
| Khái niệm | Vai trò |
|---|---|
| Embedding | Chuyển dữ liệu thành vector |
| Vector Database | Lưu trữ và tìm kiếm vector |
| Semantic Search | Tìm dữ liệu dựa trên ý nghĩa |
| RAG | Kết hợp retrieval với generative AI |
| LLM | Hiểu context và tạo câu trả lời |
Có thể hiểu đơn giản:
Embedding
    ↓
Vector Database
    ↓
Semantic Search
    ↓
Retrieval
    ↓
RAG
    ↓
LLM
    ↓
Generated Answer
Semantic Search có thể là một thành phần trong hệ thống RAG, nhưng Semantic Search bản thân nó không phải là RAG.
9. Semantic Search được ứng dụng ở đâu?
9.1. Tìm kiếm tài liệu
Doanh nghiệp có thể cho phép nhân viên tìm kiếm tài liệu bằng ngôn ngữ tự nhiên thay vì phải nhớ chính xác tên file hoặc từ khóa.
9.2. Chatbot AI
Semantic Search giúp chatbot tìm được những thông tin phù hợp với câu hỏi trước khi tạo câu trả lời.
9.3. Tìm kiếm sản phẩm
Người dùng có thể nhập:
“Giày chạy bộ nhẹ, phù hợp để chạy đường dài.”
Hệ thống có thể tìm những sản phẩm có đặc điểm phù hợp về mặt ngữ nghĩa ngay cả khi mô tả sản phẩm không chứa chính xác toàn bộ câu truy vấn.
9.4. Recommendation System
Embedding và Semantic Search cũng có thể được sử dụng để tìm các nội dung hoặc sản phẩm có đặc điểm tương đồng.
9.5. AI Agent
AI Agent có thể sử dụng Semantic Search để truy xuất thông tin từ knowledge base trước khi thực hiện một tác vụ hoặc đưa ra quyết định.
10. Hạn chế của Semantic Search
Dù mạnh hơn tìm kiếm dựa trên từ khóa trong nhiều trường hợp, Semantic Search không phải lúc nào cũng cho kết quả hoàn hảo.
10.1. Phụ thuộc vào chất lượng Embedding Model
Nếu mô hình Embedding không hiểu tốt ngôn ngữ, lĩnh vực hoặc ngữ cảnh của dữ liệu, kết quả tìm kiếm có thể không chính xác.
10.2. Không phải truy vấn nào cũng nên dùng Semantic Search
Đối với những truy vấn cần tìm chính xác một mã sản phẩm, ID, tên riêng hoặc chuỗi ký tự cụ thể, Keyword Search vẫn có thể phù hợp hơn.
10.3. Chi phí tính toán
Việc tạo embedding và thực hiện vector search có thể yêu cầu thêm tài nguyên tính toán so với một hệ thống tìm kiếm từ khóa đơn giản.
10.4. Chunking ảnh hưởng đến kết quả
Trong các hệ thống RAG, dữ liệu thường được chia thành nhiều đoạn nhỏ trước khi tạo embedding.
Nếu chia quá nhỏ, context có thể bị mất.
Nếu chia quá lớn, mỗi vector có thể chứa quá nhiều thông tin và trở nên kém chính xác khi tìm kiếm.
Vì vậy, chunking strategy cũng là một yếu tố quan trọng trong chất lượng Semantic Search.
11. Semantic Search trong hệ sinh thái AI hiện đại
Semantic Search không phải là một công nghệ đứng độc lập. Nó thường là một mắt xích trong một hệ thống AI lớn hơn.
Một kiến trúc đơn giản có thể được hình dung như sau:
                 User
                   ↓
              User Query
                   ↓
             Query Embedding
                   ↓
          ┌──────────────────┐
          │  Vector Database │
          └──────────────────┘
                   ↓
           Semantic Search
                   ↓
          Relevant Context
                   ↓
                 LLM
                   ↓
              AI Response
Khi kết hợp với RAG, AI Agent và LLM, Semantic Search trở thành một phần quan trọng của các hệ thống AI có khả năng làm việc với dữ liệu riêng.
12. Tổng kết
Semantic Search là phương pháp tìm kiếm dựa trên ý nghĩa và ngữ cảnh thay vì chỉ dựa trên sự trùng khớp từ khóa.
Những thành phần quan trọng liên quan đến Semantic Search gồm:
- Embedding: chuyển văn bản thành vector.
- Vector Database: lưu trữ và tìm kiếm vector.
- Similarity Search: xác định những nội dung gần nhau về mặt vector.
- Semantic Search: tìm kiếm dựa trên ý nghĩa.
- RAG: sử dụng retrieval để cung cấp context cho LLM.
- LLM: sử dụng context để tạo ra câu trả lời.
Có thể tóm tắt toàn bộ quá trình bằng một chuỗi đơn giản:
Text
 ↓
Embedding
 ↓
Vector
 ↓
Vector Database
 ↓
Semantic Search
 ↓
Relevant Context
 ↓
RAG
 ↓
LLM
 ↓
Answer
Hiểu Semantic Search là một bước quan trọng để tiếp tục tìm hiểu về Vector Database, RAG, AI Agents và các hệ thống Generative AI hiện đại.
Tài liệu tham khảo
- Google Machine Learning – Embeddings
- Pinecone – Vector Embeddings
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Stanford – Introduction to Information Retrieval
Khám phá thêm tại MCNA Technology School
Nếu bạn muốn tìm hiểu sâu hơn về AI, Data và các công nghệ liên quan, có thể tham khảo các chương trình học tại MCNA Technology School:
Tác giả: Tên của bạn – Vị trí của bạn tại MCNA Technology School