Vector Database là gì? Cách AI tìm kiếm dữ liệu theo ngữ nghĩa
Ở các bài trước, chúng ta đã tìm hiểu về LLM, RAG, AI Agent và Prompt Engineering. Trong đó, RAG cho phép hệ thống tìm kiếm thông tin liên quan trước khi đưa dữ liệu vào LLM.
Nhưng có một câu hỏi quan trọng:
Làm thế nào máy tính có thể tìm được những đoạn văn có ý nghĩa giống với câu hỏi của người dùng?
Một trong những thành phần quan trọng để giải quyết bài toán này là Vector Database.
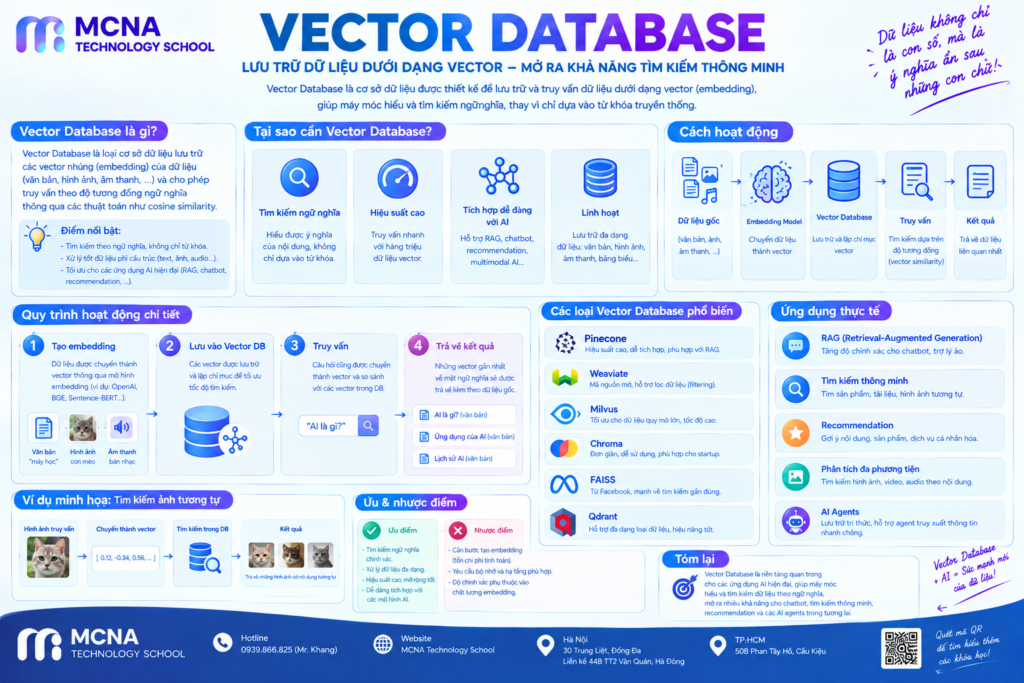
Vector Database cho phép hệ thống lưu trữ và tìm kiếm các vector biểu diễn dữ liệu, từ đó hỗ trợ những bài toán như semantic search, recommendation và Retrieval-Augmented Generation.
1. Vector Database là gì?
Vector Database là hệ thống cơ sở dữ liệu được thiết kế để lưu trữ, quản lý và tìm kiếm các vector.
Trong AI, vector thường được tạo ra bằng cách chuyển dữ liệu như văn bản, hình ảnh hoặc âm thanh thành một biểu diễn số thông qua mô hình embedding.
Text
 ↓
Embedding Model
 ↓
Vector
 ↓
Vector Database
Ví dụ:
"Machine Learning là gì?"

        ↓

[0.21, -0.14, 0.73, 0.41, ...]
Vector này có thể được lưu trữ cùng với nội dung gốc và metadata.
2. Vector là gì?
Trong Machine Learning, vector có thể được hiểu đơn giản là một dãy các số.
[0.2, 0.7, -0.3, 0.8]
Một vector có thể có hàng trăm hoặc hàng nghìn chiều.
Ví dụ minh họa:
Text A
 ↓
[0.21, 0.14, 0.82, ...]

Text B
 ↓
[0.23, 0.17, 0.79, ...]

Text C
 ↓
[-0.62, 0.31, -0.15, ...]
Những text có ý nghĩa gần nhau thường có vector gần nhau hơn trong không gian embedding, tùy vào mô hình embedding được sử dụng.
3. Embedding là gì?
Embedding là quá trình chuyển dữ liệu thành một vector có thể biểu diễn những đặc trưng mà mô hình embedding học được.
Với text:
"Machine Learning"

        ↓

Embedding Model

        ↓

Vector
Điểm quan trọng là embedding không đơn giản chỉ biến từng từ thành một con số.
Embedding model cố gắng tạo ra biểu diễn có thể phản ánh những mối quan hệ trong dữ liệu.
4. Tại sao không dùng Database thông thường?
Database truyền thống rất phù hợp với những truy vấn có cấu trúc.
Ví dụ:
SELECT *
FROM products
WHERE price < 1000000;
Ở đây, database tìm kiếm dựa trên điều kiện rõ ràng.
Nhưng với câu hỏi:
"Tôi muốn tìm một chiếc laptop
phù hợp để lập trình Python."
Việc tìm kiếm chính xác những từ xuất hiện trong câu hỏi có thể không đủ.
Một tài liệu có thể viết:
"Thiết bị có CPU mạnh,
RAM 16GB và phù hợp cho
software development."
Hai đoạn text không sử dụng hoàn toàn giống nhau về từ ngữ, nhưng có thể liên quan về mặt ngữ nghĩa.
Đây là nơi semantic search trở nên hữu ích.
5. Keyword Search và Semantic Search
Keyword Search tìm kiếm dựa trên từ khóa.
Query:
"laptop lập trình"

        ↓

Search keywords:
"laptop"
"lập trình"
Semantic Search tập trung vào sự tương đồng về ý nghĩa.
Query
 ↓
Embedding
 ↓
Vector Search
 ↓
Semantically Similar Documents
Ví dụ:
Query:
"máy tính để code"

Có thể tìm được:

"laptop dành cho software development"

"máy tính hiệu năng cao cho developer"
Ngay cả khi từ khóa không hoàn toàn giống nhau, nội dung vẫn có thể được xem là liên quan.
6. Similarity Search là gì?
Similarity Search là quá trình tìm những vector gần với một vector truy vấn.
Query Vector
      ↓
Vector Database
      ↓
Similarity Search
      ↓
Nearest Vectors
Ví dụ:
Query
  ↓
Q = [0.2, 0.7, 0.4]

Database:

A = [0.21, 0.69, 0.42]
B = [-0.5, 0.1, 0.8]
C = [0.18, 0.72, 0.39]

        ↓

A và C gần Q hơn B
Hệ thống có thể trả về A và C như những kết quả liên quan hơn.
7. Cosine Similarity
Một phép đo phổ biến trong vector search là Cosine Similarity.
Công thức:
cos(θ) = (A · B) / (||A|| ||B||)
Trong đó:
- A · B: tích vô hướng của hai vector.
- ||A||: độ dài của vector A.
- ||B||: độ dài của vector B.
Cosine similarity tập trung vào góc giữa hai vector.
Có thể hình dung:
Vector A
   ↗
  /
 /
●────────→ Vector B
Hai vector có hướng càng gần nhau thì cosine similarity càng cao.
8. Euclidean Distance
Một cách khác để đo khoảng cách giữa hai vector là Euclidean Distance.
Distance(A,B)
=
√ Σ(Ai - Bi)²
Khoảng cách càng nhỏ thì hai điểm càng gần nhau trong không gian vector.
Trong thực tế, việc sử dụng cosine similarity, Euclidean distance hay một metric khác phụ thuộc vào loại embedding và hệ thống tìm kiếm.
9. Vector Database lưu những gì?
Một record trong Vector Database thường có thể bao gồm:
- Vector embedding.
- Nội dung gốc.
- ID.
- Metadata.
Ví dụ:
{
  "id": "doc_001",
  "text": "Machine Learning là...",
  "vector": [0.21, -0.14, 0.82, ...],
  "metadata": {
    "source": "ml-course.pdf",
    "page": 12,
    "category": "machine-learning"
  }
}
Nhờ metadata, hệ thống có thể lọc dữ liệu trước hoặc sau khi thực hiện vector search.
10. Metadata Filtering
Không phải lúc nào similarity search cũng đủ.
Ví dụ một công ty có tài liệu của nhiều phòng ban:
HR
Finance
Marketing
Data
Engineering
Người dùng hỏi:
"Quy định nghỉ phép của nhân viên?"
Hệ thống có thể giới hạn search vào những tài liệu thuộc phòng HR.
Query
 ↓
Metadata Filter
department = "HR"
 ↓
Vector Search
 ↓
Relevant Documents
Việc kết hợp semantic search với metadata filtering có thể giúp retrieval phù hợp hơn với ứng dụng thực tế.
11. Vector Index là gì?
Nếu database có hàng triệu vector, việc so sánh query với từng vector có thể rất tốn thời gian.
Do đó, hệ thống thường sử dụng vector index để tăng tốc quá trình tìm kiếm.
Millions of Vectors
        ↓
Vector Index
        ↓
Fast Similarity Search
Một số phương pháp index phổ biến được sử dụng trong vector search bao gồm:
- HNSW.
- IVF.
- Product Quantization.
- ANN-based indexing.
12. ANN là gì?
ANN – Approximate Nearest Neighbor là nhóm kỹ thuật tìm kiếm những vector gần nhất một cách xấp xỉ thay vì luôn thực hiện tìm kiếm chính xác trên toàn bộ dữ liệu.
Mục tiêu là cân bằng:
Search Accuracy
        ↕
Search Speed
        ↕
Memory Usage
Với dữ liệu lớn, việc chấp nhận một mức xấp xỉ nhất định có thể giúp tốc độ retrieval tăng đáng kể.
13. HNSW là gì?
HNSW – Hierarchical Navigable Small World là một cấu trúc dữ liệu phổ biến cho Approximate Nearest Neighbor Search.
Có thể hình dung đơn giản rằng các vector được tổ chức thành một mạng lưới nhiều tầng.
Layer 2:
      A -------- D

Layer 1:
  A ---- B ---- D ---- F

Layer 0:
A-B-C-D-E-F-G-H-I
Search có thể bắt đầu ở tầng cao để nhanh chóng tiến gần khu vực cần tìm, sau đó đi xuống các tầng thấp hơn để tìm kết quả chi tiết hơn.
HNSW là một kỹ thuật quan trọng trong nhiều hệ thống vector search hiện đại.
14. Vector Database trong RAG
Đây là một trong những ứng dụng quan trọng nhất của Vector Database.
Pipeline RAG có thể được mô tả:
Documents
   ↓
Chunking
   ↓
Embedding
   ↓
Vector Database
Khi người dùng đặt câu hỏi:
User Question
      ↓
Query Embedding
      ↓
Vector Search
      ↓
Relevant Chunks
      ↓
LLM
      ↓
Answer
Vector Database đóng vai trò là lớp lưu trữ và tìm kiếm knowledge cho hệ thống RAG.
15. Vector Database không phải nơi lưu “kiến thức của AI”
Một hiểu nhầm phổ biến là nghĩ rằng Vector Database chính là “bộ nhớ” của LLM.
Thực tế:
LLM
→ Model parameters

Vector Database
→ External information
Vector Database lưu các representation và dữ liệu liên quan để hệ thống có thể truy xuất khi cần.
LLM vẫn là một model riêng biệt.
16. Vector Database và Traditional Database
| Đặc điểm | Traditional Database | Vector Database |
|---|---|---|
| Dữ liệu chính | Structured / semi-structured data | Vector embeddings |
| Truy vấn | SQL / filters | Similarity search |
| Mục tiêu | Exact / structured retrieval | Semantic retrieval |
| Ví dụ | PostgreSQL, MySQL | Vector search systems |
Hai loại database không nhất thiết loại trừ nhau.
Một hệ thống thực tế có thể sử dụng cả hai:
PostgreSQL
   +
Vector Search
   ↓
AI Application
17. Hybrid Search
Trong nhiều trường hợp, chỉ dùng semantic search chưa phải lựa chọn duy nhất.
Hybrid Search kết hợp nhiều phương pháp tìm kiếm.
              Query
                ↓
        ┌───────┴───────┐
        ↓               ↓
 Keyword Search   Vector Search
        ↓               ↓
        └───────┬───────┘
                ↓
             Ranking
                ↓
             Results
Ví dụ, keyword search có thể hữu ích khi người dùng tìm một mã sản phẩm cụ thể, trong khi semantic search có thể hữu ích khi người dùng mô tả nhu cầu bằng ngôn ngữ tự nhiên.
18. Vector Database trong Recommendation System
Vector search không chỉ được sử dụng cho RAG.
Nó còn có thể được sử dụng trong recommendation.
User Profile
     ↓
Embedding
     ↓
User Vector
     ↓
Similarity Search
     ↓
Similar Items
     ↓
Recommendations
Ví dụ trong hệ thống nội dung:
User thích:
AI
Python
Data Science

        ↓

User Embedding

        ↓

Find Similar Content

        ↓

Recommendations
Đây là một ví dụ về việc vector representation có thể được sử dụng để tìm những item tương đồng.
19. Vector Database trong Image Search
Embedding không chỉ dành cho text.
Hình ảnh cũng có thể được chuyển thành vector.
Image
 ↓
Vision / Embedding Model
 ↓
Image Vector
 ↓
Vector Database
Khi người dùng upload một hình ảnh:
Query Image
    ↓
Embedding
    ↓
Vector Search
    ↓
Similar Images
Do đó, vector search có thể được sử dụng cho nhiều loại dữ liệu khác nhau.
20. Những vấn đề cần quan tâm khi xây dựng Vector Search
Một hệ thống vector search thực tế cần cân nhắc nhiều yếu tố:
- Chất lượng embedding model.
- Chunking strategy.
- Vector dimension.
- Similarity metric.
- Index type.
- Top-K.
- Metadata filtering.
- Latency.
- Memory usage.
- Retrieval accuracy.
Vì vậy, xây dựng một hệ thống RAG tốt không đơn giản chỉ là “đưa tài liệu vào Vector Database”.
21. Đánh giá Vector Search
Retrieval cần được đánh giá riêng trước khi đánh giá toàn bộ RAG system.
Một workflow có thể là:
Test Queries
     ↓
Vector Search
     ↓
Retrieved Documents
     ↓
Compare with Ground Truth
     ↓
Evaluate Retrieval
Một số khái niệm thường gặp:
- Precision: tỷ lệ kết quả retrieved thực sự relevant.
- Recall: khả năng tìm được những tài liệu relevant.
- Top-K Accuracy: kiểm tra liệu tài liệu cần thiết có xuất hiện trong K kết quả đầu hay không.
Điều này giúp xác định vấn đề nằm ở retrieval hay ở bước generation của LLM.
22. Tổng kết
Vector Database là một thành phần quan trọng trong nhiều hệ thống AI hiện đại, đặc biệt là RAG và semantic search.
Những khái niệm quan trọng cần nhớ:
- Embedding: chuyển dữ liệu thành vector representation.
- Vector Database: lưu trữ và tìm kiếm vector.
- Similarity Search: tìm những vector gần với query.
- Cosine Similarity: một metric phổ biến để đo độ tương đồng.
- ANN: tìm kiếm nearest neighbors theo hướng xấp xỉ để tăng tốc.
- HNSW: một cấu trúc phổ biến cho ANN search.
- Metadata Filtering: lọc dữ liệu theo thuộc tính bổ sung.
- Hybrid Search: kết hợp keyword search và semantic search.
Có thể ghi nhớ bằng một chuỗi:
Text
 ↓
Embedding
 ↓
Vector
 ↓
Vector Database
 ↓
Similarity Search
 ↓
Relevant Information
 ↓
LLM
Ở bài tiếp theo, chúng ta sẽ đi sâu hơn vào Semantic Search là gì? và cách AI có thể tìm kiếm theo ý nghĩa thay vì chỉ tìm những từ khóa giống nhau.
Tài liệu tham khảo
- Pinecone – What is a Vector Database?
- HNSWlib – Approximate Nearest Neighbor Search
- Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs
- Sentence Transformers Documentation
🚀 Học Data Science & AI cùng MCNA Technology School
Nếu bạn muốn xây dựng nền tảng từ Python, Data Analysis đến AI và Machine Learning, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Minh Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu