Trong bài trước, chúng ta đã tìm hiểu LSTM (Long Short-Term Memory) – một biến thể của RNN được thiết kế để giúp mô hình ghi nhớ thông tin trong thời gian dài và hạn chế vấn đề vanishing gradient.
Tuy nhiên, LSTM có kiến trúc tương đối phức tạp với nhiều cổng và số lượng tham số lớn hơn RNN truyền thống.
Để tạo ra một kiến trúc recurrent đơn giản hơn nhưng vẫn có khả năng kiểm soát thông tin, các nhà nghiên cứu đã đề xuất GRU (Gated Recurrent Unit).
Vậy GRU là gì? Nó khác LSTM như thế nào và khi nào nên sử dụng GRU?
1. GRU là gì?
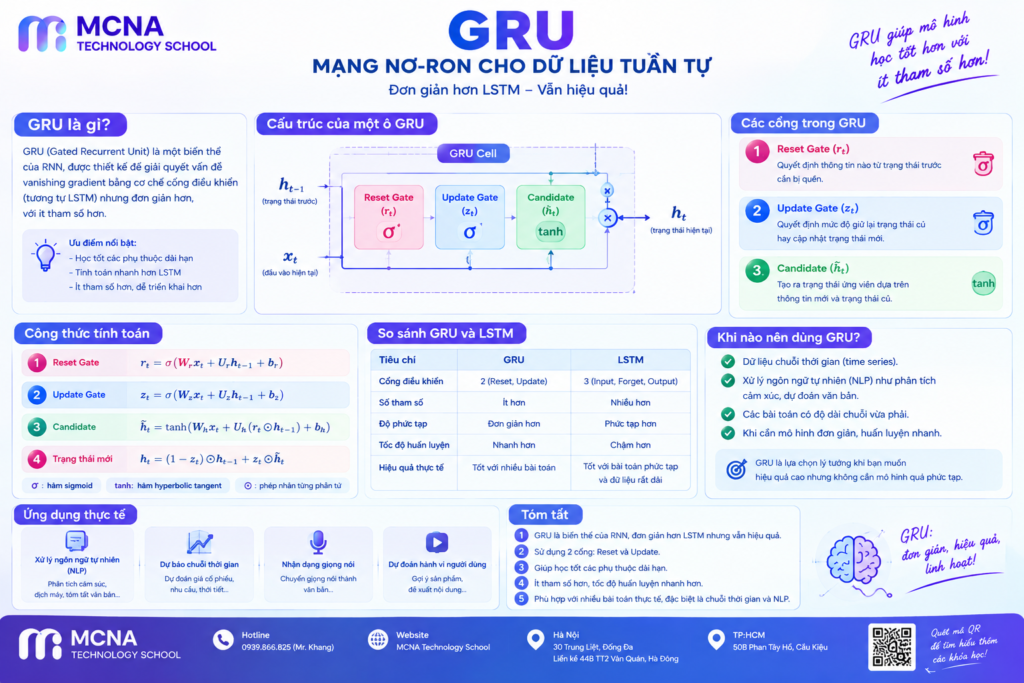
GRU – Gated Recurrent Unit là một biến thể của Recurrent Neural Network (RNN), được giới thiệu bởi Kyunghyun Cho và cộng sự vào năm 2014.
GRU sử dụng các cơ chế gate để kiểm soát dòng thông tin qua các bước thời gian. Nhờ đó, mô hình có thể quyết định thông tin nào nên được giữ lại và thông tin nào nên được thay thế.
Có thể hiểu đơn giản:
RNN: truyền thông tin qua hidden state.
LSTM: sử dụng cell state và nhiều gate để kiểm soát bộ nhớ.
GRU: đơn giản hóa cơ chế của LSTM nhưng vẫn duy trì khả năng xử lý phụ thuộc dài hạn.
Mục tiêu của GRU là tạo ra một recurrent architecture có khả năng học các mối quan hệ dài hạn nhưng với kiến trúc đơn giản hơn LSTM.
2. Tại sao GRU ra đời?
RNN truyền thống gặp khó khăn khi xử lý các chuỗi dài do vấn đề vanishing gradient.
Ví dụ, khi mô hình xử lý một câu rất dài:
Thông tin 1 → Thông tin 2 → Thông tin 3 → ... → Thông tin 50Thông tin ở những bước đầu có thể trở nên khó duy trì khi mô hình tiến đến những bước cuối.
LSTM giải quyết vấn đề này bằng cách sử dụng:
- Cell State
- Forget Gate
- Input Gate
- Output Gate
GRU tiếp cận vấn đề theo một cách đơn giản hơn.
Thay vì sử dụng một cell state riêng biệt, GRU chỉ duy trì hidden state và sử dụng hai gate chính để kiểm soát thông tin.
3. GRU có những gate nào?
GRU sử dụng hai cơ chế gate quan trọng:
- Update Gate: quyết định bao nhiêu thông tin cũ được giữ lại và bao nhiêu thông tin mới được đưa vào.
- Reset Gate: quyết định mức độ thông tin từ quá khứ được sử dụng khi tạo thông tin mới.
Có thể hình dung:
                 Input xₜ
                    │
                    ▼
          ┌──────────────────┐
          │       GRU        │
          │                  │
          │  Reset Gate      │
          │       ↓          │
          │  Update Gate     │
          │       ↓          │
          │  Hidden State    │
          └──────────────────┘
                    │
                    ▼
                Output hₜ
Hai gate này giúp GRU kiểm soát việc cập nhật hidden state qua từng timestep.
4. Update Gate – Quyết định thông tin nào được giữ lại
Update Gate có thể được xem là thành phần quan trọng nhất của GRU.
Nó quyết định mức độ thông tin cũ cần được giữ lại và mức độ thông tin mới cần được cập nhật.
Ví dụ:
Thông tin cũ
     │
     ▼
Update Gate
     │
     ├── Giữ lại nhiều ──► Hidden State mới
     │
     └── Thay thế nhiều ─► Hidden State mới
Về mặt toán học, update gate thường được biểu diễn:
zₜ = σ(Wz · [hₜ₋₁, xₜ] + bz)Trong đó:
xₜ: input tại timestep hiện tại.hₜ₋₁: hidden state của timestep trước.Wz: trọng số của update gate.bz: bias.σ: hàm sigmoid.
Giá trị của update gate nằm trong khoảng từ 0 đến 1.
Giá trị càng lớn thì mô hình có xu hướng giữ lại nhiều thông tin từ trạng thái trước đó.
5. Reset Gate – Quyết định mức độ sử dụng thông tin quá khứ
Reset Gate quyết định mức độ thông tin từ hidden state trước đó được sử dụng khi tạo ra thông tin ứng viên mới.
Có thể hiểu đơn giản:
Thông tin quá khứ
       │
       ▼
  Reset Gate
       │
       ├── Giữ nhiều ──► Sử dụng quá khứ
       │
       └── Giữ ít ─────► Bỏ qua quá khứ
Công thức thường được biểu diễn:
rₜ = σ(Wr · [hₜ₋₁, xₜ] + br)Sau đó GRU sử dụng reset gate để tạo ra hidden state ứng viên:
h̃ₜ = tanh(Wh · [rₜ × hₜ₋₁, xₜ] + bh)Như vậy, reset gate cho phép mô hình kiểm soát mức độ ảnh hưởng của thông tin quá khứ.
6. GRU cập nhật Hidden State như thế nào?
Sau khi tính update gate và hidden state ứng viên, GRU kết hợp chúng để tạo ra hidden state mới.
hₜ = (1 - zₜ) × hₜ₋₁ + zₜ × h̃ₜĐiều này có nghĩa là hidden state mới là sự kết hợp giữa:
- Thông tin từ hidden state cũ.
- Thông tin mới được tạo ra ở timestep hiện tại.
Nhờ vậy, GRU có thể duy trì những thông tin quan trọng qua nhiều timestep thay vì liên tục thay thế toàn bộ trạng thái.
7. GRU khác LSTM như thế nào?
Đây là câu hỏi quan trọng nhất khi tìm hiểu GRU.
| Đặc điểm | GRU | LSTM |
|---|---|---|
| Hidden State | Có | Có |
| Cell State riêng | Không | Có |
| Reset Gate | Có | Không |
| Update Gate | Có | Không |
| Forget Gate | Không | Có |
| Input Gate | Không | Có |
| Output Gate | Không | Có |
| Số lượng tham số | Thường ít hơn | Thường nhiều hơn |
| Kiến trúc | Đơn giản hơn | Phức tạp hơn |
Điểm khác biệt quan trọng nhất là LSTM có cell state riêng, trong khi GRU chỉ sử dụng hidden state.
8. Tại sao GRU có thể nhanh hơn LSTM?
Do kiến trúc đơn giản hơn, GRU thường có ít tham số hơn LSTM.
Điều này có thể giúp:
- Giảm lượng phép tính trong quá trình training.
- Giảm bộ nhớ cần thiết.
- Tốc độ huấn luyện có thể nhanh hơn trong một số bài toán.
- Phù hợp với những bài toán có tài nguyên tính toán hạn chế.
Tuy nhiên, GRU nhanh hơn không có nghĩa GRU luôn tốt hơn LSTM.
Hiệu quả thực tế còn phụ thuộc vào:
- Kích thước dataset.
- Độ dài sequence.
- Số lượng feature.
- Độ phức tạp của bài toán.
- Kiến trúc mạng.
- Cách preprocessing dữ liệu.
9. Ví dụ GRU với Python
Với TensorFlow và Keras, chúng ta có thể xây dựng một mô hình GRU khá đơn giản:
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import GRU, Dense

model = Sequential([
    GRU(64, input_shape=(30, 5)),
    Dense(1)
])

model.compile(
    optimizer="adam",
    loss="mse"
)

model.summary()
Trong ví dụ trên:
30: số timestep trong mỗi sequence.5: số feature tại mỗi timestep.64: số GRU units.Dense(1): lớp output để dự đoán một giá trị.
TensorFlow/Keras cung cấp sẵn lớp GRU để xây dựng các mô hình recurrent neural network.
Xem tài liệu GRU chính thức của TensorFlow
10. GRU được ứng dụng ở đâu?
GRU có thể được sử dụng trong nhiều bài toán xử lý dữ liệu tuần tự.
Natural Language Processing
- Text Classification.
- Sentiment Analysis.
- Language Modeling.
- Sequence Prediction.
- Machine Translation.
Time Series
- Dự báo doanh thu.
- Dự báo nhu cầu.
- Dự báo traffic.
- Dữ liệu cảm biến.
- Dữ liệu tài chính.
Speech và Audio
GRU cũng có thể được sử dụng để xử lý các chuỗi âm thanh hoặc những dữ liệu có cấu trúc tuần tự theo thời gian.
11. Khi nào nên sử dụng GRU?
GRU có thể là một lựa chọn đáng cân nhắc khi bạn cần một recurrent model nhưng muốn kiến trúc tương đối đơn giản.
Ví dụ:
- Dataset không quá lớn.
- Sequence có độ dài vừa phải.
- Cần giảm số lượng tham số.
- Muốn thử nghiệm nhanh nhiều mô hình.
- Tài nguyên tính toán bị giới hạn.
Trong thực tế, một cách tiếp cận phổ biến là thử nghiệm cả LSTM và GRU, sau đó đánh giá bằng validation set hoặc cross-validation phù hợp với bài toán.
12. GRU, LSTM và RNN: nhìn lại toàn bộ quá trình
Ba kiến trúc có thể được hình dung như một quá trình phát triển:
RNN
 │
 │  Giải quyết dữ liệu tuần tự
 ▼
LSTM
 │
 │  Thêm cơ chế bộ nhớ và nhiều gate
 ▼
GRU
 │
 │  Đơn giản hóa gated architecture
 ▼
Attention
 │
 │  Cho phép tập trung trực tiếp vào các vị trí quan trọng
 ▼
Transformer
Đây là một trong những dòng phát triển quan trọng khi tìm hiểu Deep Learning cho dữ liệu tuần tự.
RNN giúp chúng ta hiểu hidden state.
LSTM giúp chúng ta hiểu memory và gated mechanism.
GRU cho thấy rằng gated recurrent architecture có thể được đơn giản hóa.
Sau đó, chúng ta sẽ đến với một ý tưởng rất quan trọng khác: Attention.
13. GRU có thay thế hoàn toàn LSTM không?
Không.
GRU và LSTM là hai kiến trúc có thiết kế khác nhau, và không có một kiến trúc nào luôn hoạt động tốt hơn trong mọi bài toán.
Việc lựa chọn phụ thuộc vào dữ liệu và yêu cầu cụ thể của mô hình.
Điều quan trọng hơn là hiểu được cách chúng xử lý thông tin:
| Mô hình | Ý tưởng chính |
|---|---|
| RNN | Truyền hidden state qua các timestep |
| LSTM | Cell state + nhiều gate để kiểm soát bộ nhớ |
| GRU | Hai gate + hidden state để kiểm soát thông tin |
14. Tổng kết
GRU (Gated Recurrent Unit) là một biến thể của RNN sử dụng hai cơ chế chính là Reset Gate và Update Gate để kiểm soát thông tin trong chuỗi.
So với LSTM, GRU:
- Không có cell state riêng.
- Có kiến trúc đơn giản hơn.
- Thường có ít tham số hơn.
- Có thể giảm chi phí tính toán trong một số trường hợp.
- Vẫn có khả năng xử lý các mối quan hệ dài hạn tốt hơn RNN truyền thống.
Quan trọng nhất, GRU giúp chúng ta hiểu thêm một nguyên tắc quan trọng trong Deep Learning:
Không phải cứ thêm nhiều thành phần vào mô hình thì mô hình sẽ luôn tốt hơn. Một kiến trúc đơn giản hơn đôi khi có thể đạt hiệu quả tương đương với chi phí thấp hơn.
Ở bài tiếp theo, chúng ta sẽ chuyển từ recurrent architecture sang một ý tưởng có ảnh hưởng rất lớn đến Deep Learning hiện đại: Attention Mechanism.
Tài liệu tham khảo
-
Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation
-
TensorFlow – GRU Layer
🚀 Học Data Science & AI cùng MCNA Technology School
Nếu bạn muốn xây dựng nền tảng từ Python, Data Analysis đến AI và Machine Learning, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
Hotline: 0939.866.825 (Mr. Minh Khang)
Website: mcna.vn
Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu