Nhưng hình ảnh không phải loại dữ liệu duy nhất cần Machine Learning xử lý.
Hãy thử nhìn vào những dữ liệu như:
- Một câu văn.
- Một đoạn hội thoại.
- Lịch sử giá cổ phiếu.
- Lượng truy cập website theo thời gian.
- Lịch sử nghe nhạc của người dùng.
- Dữ liệu cảm biến.
Những dữ liệu này có một đặc điểm chung:
Thứ tự của dữ liệu có ý nghĩa.
Đây chính là nhóm bài toán mà Recurrent Neural Network – RNN được thiết kế để xử lý.
RNN là gì?
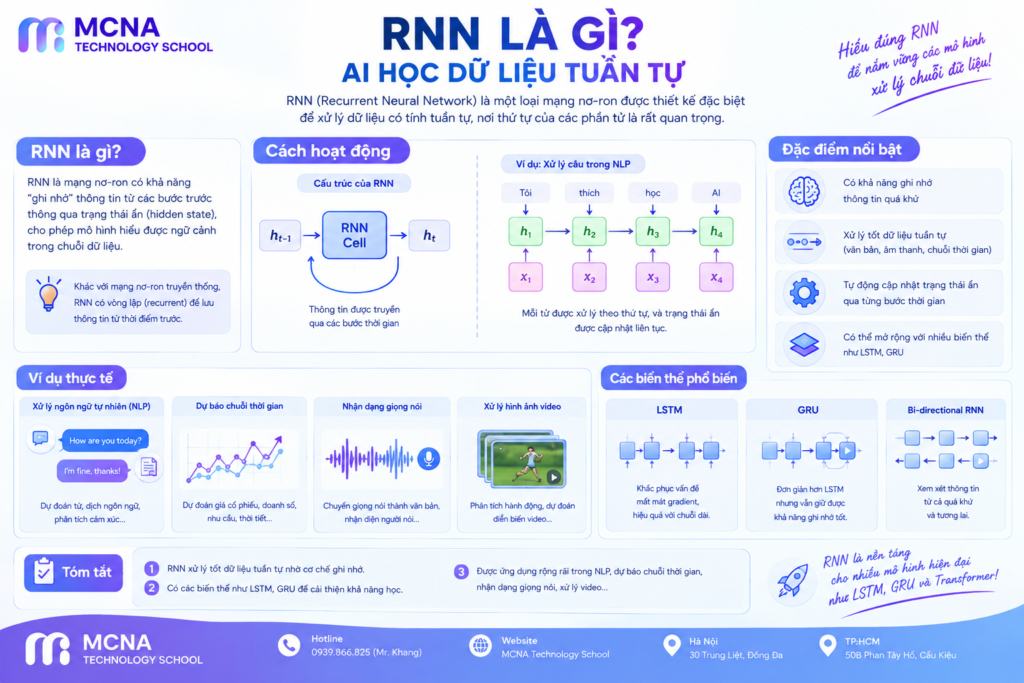
RNN (Recurrent Neural Network) là một kiến trúc Neural Network được thiết kế để xử lý Sequential Data – dữ liệu tuần tự.
Khác với một mạng Neural Network thông thường, RNN duy trì một trạng thái được gọi là Hidden State.
Hidden State giúp thông tin từ những bước trước được truyền sang bước tiếp theo.
Có thể hình dung:
Input 1 → RNN → Hidden State
                    ↓
Input 2 → RNN → Hidden State
                    ↓
Input 3 → RNN → Hidden State
                    ↓
Input 4 → RNN → Prediction
Như vậy, mô hình không chỉ nhìn vào Input hiện tại mà còn có thể sử dụng thông tin được truyền từ các bước trước.
Tại sao dữ liệu tuần tự cần một mô hình khác?
Hãy lấy một câu đơn giản:
"Tôi đang học Machine Learning"Nếu tách câu thành từng từ:
Tôi
↓
đang
↓
học
↓
Machine
↓
Learning
Ý nghĩa của từ “Learning” phụ thuộc một phần vào những từ xuất hiện trước đó.
Do đó, nếu xử lý từng từ hoàn toàn độc lập:
Tôi       → Model
đang      → Model
học       → Model
Machine   → Model
Learning  → Model
mô hình sẽ khó tận dụng thông tin về thứ tự.
RNN giải quyết vấn đề này bằng cách truyền thông tin giữa các bước.
Hidden State là gì?
Hidden State có thể được hiểu đơn giản là một dạng “bộ nhớ” của RNN.
Ở mỗi bước:
Input hiện tại
      +
Thông tin từ bước trước
      ↓
    RNN
      ↓
Hidden State mới
Ví dụ:
Input 1
  ↓
Hidden State 1
  ↓
Input 2 + Hidden State 1
  ↓
Hidden State 2
  ↓
Input 3 + Hidden State 2
  ↓
Hidden State 3
Nhờ vậy, thông tin có thể được truyền dọc theo chuỗi.
RNN hoạt động như thế nào?
Giả sử chúng ta có chuỗi:
x₁ → x₂ → x₃ → x₄RNN xử lý lần lượt:
x₁
 ↓
h₁

x₂ + h₁
 ↓
h₂

x₃ + h₂
 ↓
h₃

x₄ + h₃
 ↓
h₄
Trong đó:
- xₜ: Input tại thời điểm t.
- hₜ: Hidden State tại thời điểm t.
Hidden State mới được tính dựa trên Input hiện tại và Hidden State trước đó.
Có thể biểu diễn đơn giản bằng:
hₜ = f(xₜ, hₜ₋₁)Trong đó f là phép biến đổi được học bởi Neural Network.
RNN có “nhớ” giống con người không?
Không.
Đây chỉ là cách mô tả trực quan.
Hidden State thực chất là một Vector số được cập nhật liên tục trong quá trình xử lý chuỗi.
Ví dụ:
h₁ = [0.2, 0.7, -0.1, ...]
h₂ = [0.4, 0.3,  0.5, ...]
h₃ = [0.1, 0.8,  0.2, ...]
Những Vector này chứa các biểu diễn mà mô hình học được từ dữ liệu.
Vì vậy, nói RNN “ghi nhớ” chỉ là cách diễn đạt trực quan cho việc truyền thông tin qua Hidden State.
RNN xử lý Text như thế nào?
Giả sử chúng ta muốn dự đoán từ tiếp theo:
"Machine Learning is"Ta có thể biểu diễn:
Machine
   ↓
Learning
   ↓
is
   ↓
?
RNN lần lượt đọc:
Machine → Hidden State
Learning + Hidden State
is + Hidden State
        ↓
    Prediction
Output có thể là:
powerful → 0.32
important → 0.21
useful → 0.17
...
Đây là một ví dụ đơn giản về Language Modeling.
RNN có thể xử lý những loại dữ liệu nào?
RNN được thiết kế cho nhiều dạng Sequential Data.
Text
Word 1 → Word 2 → Word 3 → Word 4Time Series
t₁ → t₂ → t₃ → t₄ → t₅Speech
Audio Frame 1
      ↓
Audio Frame 2
      ↓
Audio Frame 3
      ↓
...
User Behavior
View
 ↓
Click
 ↓
Search
 ↓
Listen
 ↓
Purchase
Điểm chung là thứ tự của các quan sát mang thông tin.
RNN khác Neural Network thông thường thế nào?
| Neural Network thông thường | RNN |
|---|---|
| Thường xử lý Input độc lập | Xử lý chuỗi theo thứ tự |
| Không có Hidden State tuần tự | Duy trì Hidden State |
| Không trực tiếp mô hình hóa Temporal Dependency | Có thể mô hình hóa Temporal Dependency |
| Phù hợp nhiều bài toán Tabular | Phù hợp Sequential Data |
Many-to-One là gì?
Một dạng bài toán phổ biến của RNN là Many-to-One.
Nhiều Input được đưa vào nhưng chỉ tạo ra một Output.
x₁
 ↓
x₂
 ↓
x₃
 ↓
x₄
 ↓
RNN
 ↓
Output
Ví dụ:
"Bộ phim này rất hay"
        ↓
Sentiment Analysis
        ↓
Positive
Toàn bộ chuỗi được sử dụng để đưa ra một kết quả cuối cùng.
One-to-Many là gì?
Ngược lại, One-to-Many sử dụng một Input để tạo ra một chuỗi Output.
Input
  ↓
RNN
  ↓
Output 1
  ↓
Output 2
  ↓
Output 3
  ↓
...
Ví dụ đơn giản:
Image
  ↓
Text Generation
  ↓
"A cat is sitting..."
Trong thực tế, các bài toán như Image Captioning có thể sử dụng kiến trúc phức tạp hơn nhiều.
Many-to-Many là gì?
Với Many-to-Many, chuỗi Input và Output đều có nhiều bước.
x₁ → x₂ → x₃ → x₄
↓    ↓    ↓    ↓
y₁ → y₂ → y₃ → y₄
Ví dụ có thể là:
- Sequence Labeling.
- Part-of-Speech Tagging.
- Time Series Prediction.
Vấn đề lớn của RNN: Vanishing Gradient
RNN có một hạn chế rất quan trọng:
Vanishing Gradient Problem.
Trong quá trình Training, Gradient được truyền ngược qua nhiều Time Step.
Nếu Gradient liên tục bị giảm:
Gradient
 ↓
0.1
 ↓
0.01
 ↓
0.001
 ↓
0.0001
 ↓
...
Gradient có thể trở nên cực kỳ nhỏ.
Khi đó, các Weight ở những bước xa trong chuỗi sẽ rất khó được cập nhật hiệu quả.
Tại sao Vanishing Gradient là vấn đề?
Hãy xét câu:
"Tôi đã xem bộ phim này từ tuần trước và nó thực sự rất..."Giả sử mô hình cần sử dụng thông tin ở đầu câu để hiểu từ cuối câu.
Nếu chuỗi quá dài:
Thông tin đầu câu
       ↓
Step 1
       ↓
Step 2
       ↓
Step 3
       ↓
...
       ↓
Step 50
       ↓
Thông tin cuối câu
Thông tin từ đầu chuỗi có thể khó được duy trì hiệu quả đến cuối chuỗi.
Đây là một trong những lý do RNN truyền thống gặp khó khăn với Long-Term Dependencies.
Exploding Gradient
Không chỉ Gradient có thể trở nên quá nhỏ.
Nó cũng có thể trở nên quá lớn.
Đây gọi là:
Exploding Gradient.
Khi đó:
Gradient
 ↓
1
 ↓
10
 ↓
100
 ↓
1000
 ↓
...
Weight Update có thể trở nên rất lớn và quá trình Training mất ổn định.
Một kỹ thuật phổ biến để kiểm soát vấn đề này là:
Gradient Clipping.
Gradient Clipping là gì?
Gradient Clipping giới hạn độ lớn của Gradient trước khi cập nhật Weight.
Ví dụ:
Gradient = 100

Max Norm = 5

→ Gradient được điều chỉnh xuống mức phù hợp
Điều này giúp hạn chế tình trạng Gradient trở nên quá lớn trong quá trình Training.
LSTM ra đời để giải quyết vấn đề gì?
Những hạn chế của RNN truyền thống dẫn đến sự phát triển của các kiến trúc cải tiến.
Một trong những kiến trúc quan trọng nhất là:
LSTM – Long Short-Term Memory.
LSTM được thiết kế để xử lý tốt hơn các Dependency dài trong chuỗi.
Thay vì chỉ sử dụng một Hidden State đơn giản, LSTM sử dụng thêm:
- Cell State.
- Input Gate.
- Forget Gate.
- Output Gate.
Có thể hình dung:
RNN
 ↓
Long-Term Dependency Problem
 ↓
LSTM
 ↓
Better Memory Management
Chúng ta sẽ đi sâu vào LSTM ở một bài riêng.
GRU là gì?
Ngoài LSTM còn có:
GRU – Gated Recurrent Unit.
GRU cũng sử dụng cơ chế Gate để kiểm soát thông tin được giữ lại hoặc cập nhật.
So với LSTM, GRU có kiến trúc đơn giản hơn.
Có thể hình dung:
RNN
 ↓
LSTM
 ↓
GRU
 ↓
Transformer
Đây là một cách nhìn lịch sử đơn giản về sự phát triển của các kiến trúc xử lý Sequence, không phải một chuỗi thay thế tuyệt đối.
RNN còn được sử dụng không?
Có.
RNN và các biến thể như LSTM, GRU vẫn có những ứng dụng phù hợp.
Tuy nhiên, trong nhiều bài toán NLP hiện đại, Transformer đã trở thành một kiến trúc rất quan trọng.
Transformer sử dụng cơ chế Self-Attention để mô hình hóa quan hệ giữa các phần khác nhau của chuỗi.
Đây cũng là nền tảng của nhiều mô hình ngôn ngữ hiện đại.
RNN và Transformer khác nhau thế nào?
| RNN | Transformer |
|---|---|
| Xử lý chuỗi theo từng bước | Có thể xử lý nhiều vị trí trong chuỗi song song hơn |
| Sử dụng Hidden State | Sử dụng Attention |
| Khó xử lý Dependency rất dài | Self-Attention giúp mô hình hóa quan hệ xa trong chuỗi |
| Kiến trúc tuần tự | Kiến trúc dựa trên Attention |
Transformer không đơn giản là “RNN nhanh hơn”. Đây là một cách tiếp cận kiến trúc khác đối với Sequential Data.
Ví dụ RNN với Keras
Một RNN đơn giản có thể được xây dựng bằng TensorFlow/Keras:
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Embedding, SimpleRNN, Dense

model = Sequential([
    Embedding(input_dim=10000, output_dim=128),
    SimpleRNN(64),
    Dense(1, activation="sigmoid")
])
Cấu trúc có thể hiểu như sau:
Text
 ↓
Embedding
 ↓
RNN
 ↓
Dense
 ↓
Prediction
Embedding chuyển Token thành Vector số.
SimpleRNN xử lý chuỗi và cập nhật Hidden State.
Dense thực hiện phần dự đoán cuối cùng.
RNN trong Time Series
RNN cũng có thể được sử dụng cho Time Series.
Ví dụ muốn dự đoán giá trị tiếp theo:
t₁ → 100
t₂ → 105
t₃ → 108
t₄ → 110
t₅ → ?
Mô hình có thể sử dụng một cửa sổ dữ liệu:
[100, 105, 108, 110]
          ↓
         RNN
          ↓
       Prediction
Tuy nhiên, trong Time Series thực tế cần đặc biệt chú ý đến cách chia Train/Test để tránh sử dụng thông tin tương lai.
RNN và Data Leakage
Với dữ liệu tuần tự, Data Leakage có thể xảy ra nếu chúng ta vô tình cho mô hình nhìn thấy thông tin từ tương lai.
Ví dụ:
January
February
March
April
May
Nếu muốn dự đoán April, không nên sử dụng thông tin của May trong Feature.
Pipeline đúng phải giữ nguyên tính thời gian:
Past
 ↓
Training

Future
 ↓
Validation / Test
Đây là một nguyên tắc rất quan trọng khi xây dựng Time Series Model.
Những khái niệm cần nhớ
| Khái niệm | Ý nghĩa |
|---|---|
| RNN | Recurrent Neural Network |
| Sequence | Dữ liệu tuần tự |
| Hidden State | Trạng thái truyền thông tin qua các bước |
| Time Step | Một vị trí trong chuỗi |
| Vanishing Gradient | Gradient trở nên quá nhỏ |
| Exploding Gradient | Gradient trở nên quá lớn |
| LSTM | RNN có cơ chế kiểm soát bộ nhớ |
| GRU | Biến thể RNN sử dụng cơ chế Gate |
| Transformer | Kiến trúc dựa trên Attention |
Kết luận
RNN là một kiến trúc Deep Learning quan trọng trong lịch sử phát triển của Machine Learning cho dữ liệu tuần tự.
Ý tưởng cốt lõi của RNN là:
Thông tin từ bước trước có thể được truyền sang bước tiếp theo thông qua Hidden State.
Nhờ đó, RNN có thể xử lý các dạng dữ liệu mà thứ tự đóng vai trò quan trọng như:
- Text.
- Speech.
- Time Series.
- User Behavior.
Tuy nhiên, RNN truyền thống gặp hạn chế với Dependency dài và các vấn đề như Vanishing Gradient.
Những hạn chế này dẫn đến sự phát triển của:
RNN
 ↓
LSTM / GRU
 ↓
Attention
 ↓
Transformer
Hiểu RNN vì vậy không chỉ giúp biết một kiến trúc Neural Network, mà còn giúp nhìn thấy quá trình tiến hóa của Deep Learning trong việc xử lý dữ liệu tuần tự.
Tài liệu tham khảo
Working with RNNs – TensorFlow
Deep Learning – Ian Goodfellow, Yoshua Bengio & Aaron Courville
A Learning Algorithm for Continually Running Fully Recurrent Neural Networks
Học AI, Machine Learning và Python tại MCNA Technology School
Nếu bạn muốn học từ nền tảng Python đến Machine Learning và ứng dụng AI trên dữ liệu thực tế, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
🌐 Website: mcna.vn
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
📍 TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu