Ở các bài trước, chúng ta đã tìm hiểu nhiều kỹ thuật quan trọng trong Deep Learning như Batch Normalization và Dropout.
Nhưng nếu đưa cho một Neural Network thông thường một bức ảnh có hàng triệu Pixel, liệu mô hình có thể hiểu được nội dung bên trong?
Ví dụ:
Ảnh một con mèo
        ↓
Machine Learning
        ↓
"Mèo"
Để làm được điều này hiệu quả, Deep Learning có một kiến trúc đặc biệt:
Convolutional Neural Network – CNN.
CNN là gì?
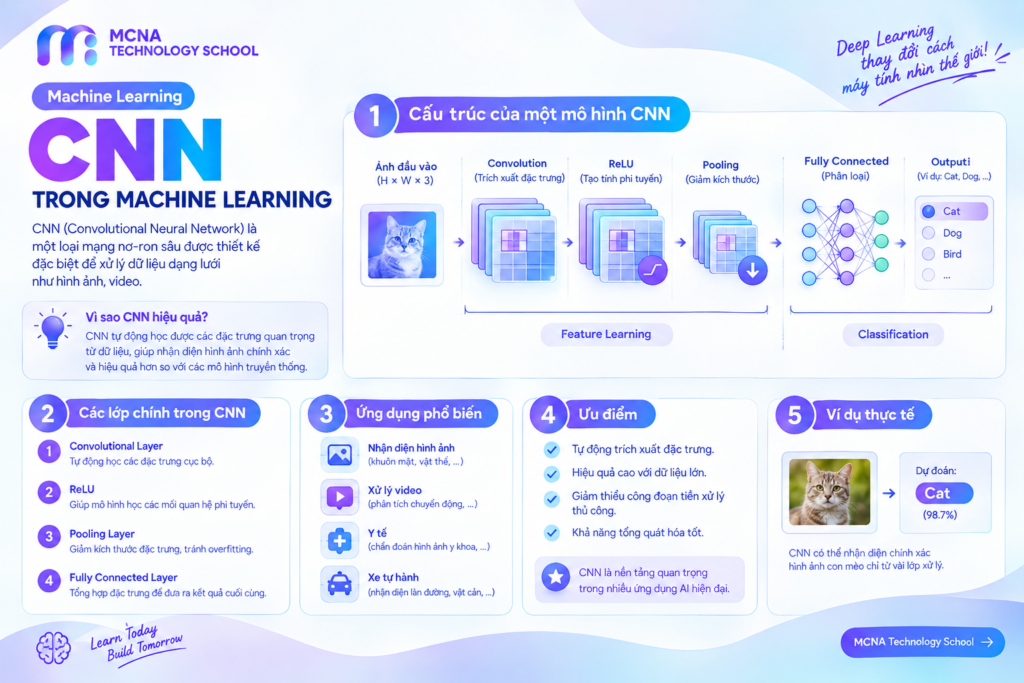
CNN (Convolutional Neural Network) hay Convolutional Neural Network là một kiến trúc Neural Network được thiết kế đặc biệt để xử lý dữ liệu có cấu trúc dạng lưới, tiêu biểu nhất là hình ảnh.
Thay vì xem toàn bộ Pixel như những con số độc lập, CNN học cách phát hiện các đặc trưng không gian trong hình ảnh.
Có thể hình dung:
Image
  ↓
Convolution
  ↓
Feature Maps
  ↓
Pooling
  ↓
Feature Extraction
  ↓
Classification
  ↓
Prediction
Tại sao Neural Network thông thường gặp vấn đề với ảnh?
Giả sử một bức ảnh có kích thước:
224 × 224 × 3Trong đó:
- 224: chiều rộng.
- 224: chiều cao.
- 3: ba kênh màu RGB.
Tổng số giá trị Pixel là:
224 × 224 × 3 = 150,528Nếu đưa toàn bộ Pixel vào một Fully Connected Layer, số lượng Parameters có thể tăng rất nhanh.
Ví dụ nếu Layer tiếp theo có 1.000 Neuron:
150,528 × 1,000
= 150,528,000 weights
Đây mới chỉ là một Layer.
Vấn đề không chỉ nằm ở số lượng Parameters.
Fully Connected Network còn không tận dụng tốt cấu trúc không gian của hình ảnh.
Pixel trong ảnh có mối quan hệ với nhau
Hãy nhìn vào một vùng nhỏ của hình ảnh.
Các Pixel nằm cạnh nhau thường có liên hệ với nhau:
Pixel → Pixel → Pixel
  ↓       ↓       ↓
Pixel → Pixel → Pixel
  ↓       ↓       ↓
Pixel → Pixel → Pixel
Ví dụ một nhóm Pixel có thể tạo thành:
- Cạnh của vật thể.
- Đường thẳng.
- Góc.
- Texture.
- Hình dạng.
CNN được thiết kế để khai thác chính những mối quan hệ này.
Convolution là gì?
Convolution là phép toán cốt lõi trong CNN.
Một Filter hay Kernel sẽ di chuyển trên hình ảnh và thực hiện phép tính với từng vùng nhỏ của ảnh.
Ví dụ Kernel 3×3:
[ 1   0  -1 ]
[ 1   0  -1 ]
[ 1   0  -1 ]
Kernel này có thể phản ứng mạnh với một số loại Edge trong hình ảnh.
Quá trình có thể hình dung:
Image
  ↓
[ Filter ]
  ↓
Scan từng vùng
  ↓
Tính toán
  ↓
Feature Map
Filter là gì?
Filter là một tập hợp các trọng số được học trong quá trình Training.
Ban đầu, các giá trị của Filter thường được khởi tạo và sau đó được cập nhật thông qua quá trình tối ưu hóa.
Ví dụ:
Filter 1 → phát hiện Edge

Filter 2 → phát hiện Texture

Filter 3 → phát hiện Pattern

Filter 4 → phát hiện một dạng Shape
Điểm quan trọng:
CNN không cần con người chỉ rõ Filter nào phải phát hiện đặc trưng nào. Mô hình có thể học các Filter phù hợp từ dữ liệu.
Feature Map là gì?
Sau khi Filter quét qua hình ảnh, kết quả được gọi là Feature Map.
Có thể hình dung:
Input Image
     ↓
   Filter
     ↓
Feature Map
Mỗi Filter có thể tạo ra một Feature Map khác nhau.
Ví dụ:
Image
  ↓
 ┌───────────────┐
 │ Filter 1      │ → Edge Map
 │ Filter 2      │ → Texture Map
 │ Filter 3      │ → Pattern Map
 └───────────────┘
Như vậy CNN không chỉ nhìn vào Pixel ban đầu mà dần dần tạo ra những biểu diễn có ý nghĩa hơn.
CNN học đặc trưng từ đơn giản đến phức tạp
Đây là một trong những ý tưởng quan trọng nhất của CNN.
Ở những Layer đầu tiên, CNN thường học các Pattern đơn giản hơn:
Pixel
 ↓
Edges
 ↓
Lines
 ↓
Textures
Các Layer sâu hơn có thể kết hợp những Pattern đó thành:
Edges
 ↓
Shapes
 ↓
Parts
 ↓
Objects
Ví dụ với ảnh khuôn mặt:
Layer đầu
→ Edge

Layer giữa
→ Mắt, mũi, miệng

Layer sâu
→ Cấu trúc khuôn mặt

Output
→ Người / Không phải người
Đây chính là Hierarchical Feature Learning.
Stride là gì?
Stride xác định Filter di chuyển bao nhiêu Pixel sau mỗi lần tính toán.
Ví dụ:
Stride = 1Filter di chuyển từng Pixel một.
Stride = 2Filter di chuyển hai Pixel mỗi lần.
Stride lớn hơn thường làm giảm kích thước Feature Map.
Padding là gì?
Khi Filter di chuyển trên hình ảnh, các Pixel ở biên có thể được sử dụng ít hơn những Pixel ở trung tâm.
Padding được sử dụng để bổ sung thêm vùng xung quanh Input.
Ví dụ:
Input
 ↓
Padding
 ↓
Convolution
 ↓
Output
Một lựa chọn phổ biến là:
Padding = "same"giúp giữ kích thước không gian của Output phù hợp với Input trong những cấu hình nhất định.
Pooling là gì?
Sau Convolution, CNN thường có thể sử dụng Pooling để giảm kích thước Feature Map.
Một loại phổ biến là:
Max Pooling.
Ví dụ:
[ 1  3 ]
[ 2  4 ]

Max = 4
Max Pooling lấy giá trị lớn nhất trong một vùng.
Ví dụ:
Feature Map
     ↓
Max Pooling
     ↓
Smaller Feature Map
Điều này giúp:
- Giảm kích thước dữ liệu.
- Giảm lượng tính toán.
- Giúp mô hình tập trung vào Activation mạnh.
Max Pooling và Average Pooling
| Max Pooling | Average Pooling |
|---|---|
| Lấy giá trị lớn nhất | Lấy giá trị trung bình |
| Giữ Activation mạnh nhất | Làm mượt thông tin |
| Phổ biến trong nhiều CNN | Được sử dụng trong một số kiến trúc |
ReLU trong CNN
Sau Convolution, CNN thường sử dụng Activation Function như ReLU.
Công thức:
ReLU(x) = max(0, x)Ví dụ:
x = -3
ReLU(x) = 0

x = 5
ReLU(x) = 5
ReLU giúp Neural Network học các quan hệ phi tuyến phức tạp.
Cấu trúc cơ bản của một CNN
Một CNN đơn giản có thể có cấu trúc:
Input Image
     ↓
Convolution
     ↓
ReLU
     ↓
Pooling
     ↓
Convolution
     ↓
ReLU
     ↓
Pooling
     ↓
Flatten
     ↓
Dense
     ↓
Output
Trong đó:
- Convolution: trích xuất đặc trưng.
- ReLU: thêm tính phi tuyến.
- Pooling: giảm kích thước biểu diễn.
- Flatten: chuyển Feature Maps thành Vector.
- Dense: thực hiện phần Classification hoặc Regression cuối cùng.
Flatten là gì?
Sau nhiều Convolution và Pooling, dữ liệu vẫn có dạng Tensor.
Ví dụ:
7 × 7 × 64Flatten sẽ chuyển nó thành Vector:
7 × 7 × 64
     ↓
3136 values
Sau đó Vector có thể được đưa vào Fully Connected Layer.
CNN phân loại ảnh mèo như thế nào?
Giả sử chúng ta đưa ảnh một con mèo vào mô hình.
Ảnh mèo
  ↓
Convolution
  ↓
Edges
  ↓
Textures
  ↓
Shapes
  ↓
Parts of Cat
  ↓
High-level Features
  ↓
Dense Layer
  ↓
Prediction
Cuối cùng mô hình có thể tạo ra:
Cat      = 0.94
Dog      = 0.04
Bird     = 0.02
Mô hình sẽ chọn Class có xác suất dự đoán cao nhất tùy theo cách thiết kế bài toán và Output Layer.
CNN không “nhìn” ảnh giống con người
Một hiểu lầm phổ biến là CNN nhìn vào ảnh rồi “hiểu” nó giống con người.
Thực tế, CNN học các biểu diễn số học thông qua rất nhiều Parameters.
Quá trình có thể khái quát:
Pixels
  ↓
Numerical Representation
  ↓
Learned Features
  ↓
Prediction
Vì vậy, khi một CNN dự đoán:
Cat = 95%nó không có nghĩa mô hình “nhận thức” con mèo theo cách con người nhận thức.
Đó là kết quả của một quá trình học Pattern từ dữ liệu.
CNN được sử dụng ở đâu?
CNN từng đóng vai trò rất quan trọng trong sự phát triển của Computer Vision.
Các ứng dụng có thể bao gồm:
- Image Classification.
- Object Detection.
- Face Recognition.
- Image Segmentation.
- Medical Image Analysis.
- OCR.
- Quality Inspection.
- Autonomous Driving.
Ví dụ trong hệ thống kiểm tra sản phẩm:
Camera
  ↓
Image
  ↓
CNN
  ↓
Feature Extraction
  ↓
Defect Detection
  ↓
OK / Defective
CNN và Computer Vision
Computer Vision là lĩnh vực giúp máy tính xử lý và phân tích thông tin hình ảnh hoặc video.
CNN là một trong những kiến trúc Deep Learning quan trọng từng được sử dụng rộng rãi trong lĩnh vực này.
Có thể hình dung:
Computer Vision
       ↓
 ┌─────┴─────┐
 ↓           ↓
CNN         Other Models
 ↓
Feature Learning
 ↓
Vision Tasks
Ngày nay, Computer Vision còn sử dụng nhiều kiến trúc khác như Vision Transformer và các mô hình Hybrid.
Ví dụ CNN bằng Keras
Một CNN đơn giản có thể được xây dựng bằng TensorFlow/Keras:
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Conv2D, MaxPooling2D
from tensorflow.keras.layers import Flatten, Dense

model = Sequential([
    Conv2D(32, (3, 3), activation="relu"),
    MaxPooling2D((2, 2)),

    Conv2D(64, (3, 3), activation="relu"),
    MaxPooling2D((2, 2)),

    Flatten(),

    Dense(128, activation="relu"),
    Dense(10, activation="softmax")
])
Cấu trúc trên có thể hiểu đơn giản:
Conv2D
 ↓
Feature Extraction

MaxPooling
 ↓
Dimension Reduction

Flatten
 ↓
Vector

Dense
 ↓
Classification
CNN có phải lúc nào cũng tốt nhất cho hình ảnh?
Không.
CNN là một kiến trúc rất quan trọng, nhưng Machine Learning liên tục phát triển.
Trong Computer Vision hiện đại, các kiến trúc như Vision Transformer (ViT) cũng đóng vai trò ngày càng lớn.
Vì vậy, không nên học CNN theo cách:
Ảnh → CNN → luôn luôn tốt nhấtMà nên hiểu:
Problem
   ↓
Dataset
   ↓
Candidate Architectures
   ↓
Training
   ↓
Validation
   ↓
Evaluation
   ↓
Model Selection
Những khái niệm cần nhớ
| Khái niệm | Vai trò |
|---|---|
| Convolution | Trích xuất đặc trưng |
| Filter / Kernel | Bộ trọng số học Pattern |
| Feature Map | Biểu diễn đặc trưng sau Convolution |
| Stride | Bước di chuyển của Filter |
| Padding | Kiểm soát vùng biên và kích thước Output |
| ReLU | Activation Function |
| Pooling | Giảm kích thước Feature Map |
| Flatten | Chuyển Tensor thành Vector |
| Dense | Thực hiện phần dự đoán cuối |
Kết luận
CNN (Convolutional Neural Network) là một kiến trúc Deep Learning quan trọng, đặc biệt trong các bài toán liên quan đến hình ảnh.
Điểm đặc biệt của CNN nằm ở khả năng tự học các đặc trưng phân cấp từ dữ liệu.
Thay vì con người phải tự thiết kế:
Edge Feature
Texture Feature
Shape Feature
Object Feature
CNN có thể học những biểu diễn này thông qua quá trình Training.
Chuỗi xử lý cơ bản có thể nhớ như sau:
Image
  ↓
Convolution
  ↓
Feature Maps
  ↓
ReLU
  ↓
Pooling
  ↓
Feature Extraction
  ↓
Dense
  ↓
Prediction
Đây là nền tảng để bước tiếp vào những kiến trúc Computer Vision phức tạp hơn.
Ở những bài tiếp theo, chúng ta sẽ tiếp tục đi sâu vào các kiến trúc Deep Learning và cách chúng giải quyết những bài toán khác nhau.
Tài liệu tham khảo
CNN classification – TensorFlow
Convolutional Neural Networks – Stanford CS231n
Học AI, Machine Learning và Python tại MCNA Technology School
Nếu bạn muốn học từ nền tảng Python đến Machine Learning và ứng dụng AI trên dữ liệu thực tế, có thể tham khảo:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
🌐 Website: mcna.vn
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
📍 TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu