Dropout là gì? Cách giảm Overfitting trong Deep Learning
Series: Machine Learning Fundamentals – Bài tiếp theo
Ở bài trước, chúng ta đã tìm hiểu Batch Normalization – một kỹ thuật giúp quá trình huấn luyện Neural Network ổn định và hiệu quả hơn.
Nhưng có một vấn đề vẫn thường xuyên xuất hiện khi xây dựng Deep Learning Model:
Overfitting.
Một mô hình có thể đạt kết quả rất tốt trên Training Data nhưng lại hoạt động kém khi gặp dữ liệu mới.
Vậy làm thế nào để khiến Neural Network không “học thuộc lòng” Training Data?
Một trong những kỹ thuật kinh điển để giải quyết vấn đề này là Dropout.
Dropout là gì?
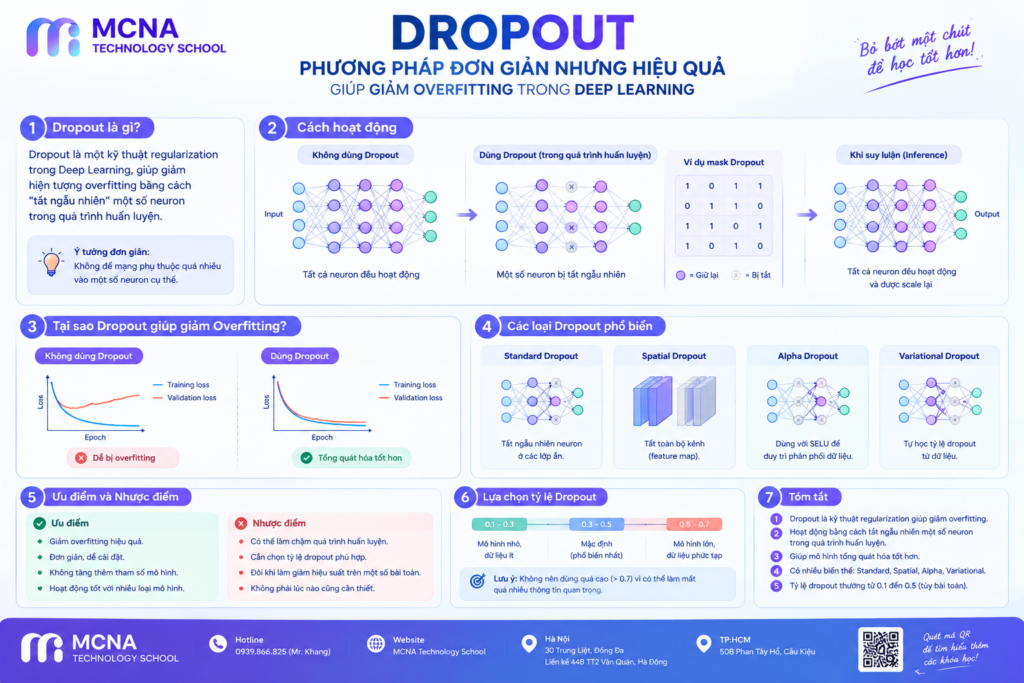
Dropout là một kỹ thuật Regularization được sử dụng trong Neural Network nhằm giảm Overfitting.
Ý tưởng rất đơn giản:
Trong quá trình Training, mô hình sẽ ngẫu nhiên “tắt” một phần neuron trong mỗi lần cập nhật.
Ví dụ, một Layer có 10 neuron và:
Dropout Rate = 0.3thì trong một lần Training, khoảng 30% neuron có thể được tạm thời bỏ qua.
Điều quan trọng là các neuron được tắt ngẫu nhiên và thay đổi giữa các lần Training.
Neuron bị “tắt” nghĩa là gì?
Giả sử một Neural Network có Layer:
Input
  ↓
Neuron 1
Neuron 2
Neuron 3
Neuron 4
Neuron 5
  ↓
Output
Khi sử dụng Dropout, một lần Training có thể trở thành:
Input
  ↓
Neuron 1     ✓
Neuron 2     ✕
Neuron 3     ✓
Neuron 4     ✕
Neuron 5     ✓
  ↓
Output
Trong lần tiếp theo, các neuron bị tắt có thể hoàn toàn khác:
Input
  ↓
Neuron 1     ✕
Neuron 2     ✓
Neuron 3     ✓
Neuron 4     ✓
Neuron 5     ✕
  ↓
Output
Như vậy, Neural Network không thể phụ thuộc quá nhiều vào một nhóm neuron cụ thể.
Dropout Rate là gì?
Dropout Rate là tỷ lệ neuron bị tắt trong quá trình Training.
Ví dụ:
| Dropout Rate | Ý nghĩa |
|---|---|
| 0.1 | Tắt khoảng 10% neuron |
| 0.2 | Tắt khoảng 20% neuron |
| 0.3 | Tắt khoảng 30% neuron |
| 0.5 | Tắt khoảng 50% neuron |
Dropout Rate càng lớn thì mức Regularization càng mạnh.
Nhưng điều đó không có nghĩa:
Dropout càng lớn → Model càng tốtNếu Dropout quá lớn, mô hình có thể không còn đủ năng lực để học Pattern trong dữ liệu.
Đây chính là một dạng Underfitting.
Tại sao Dropout giúp giảm Overfitting?
Hãy tưởng tượng một Neural Network học một bài toán phân loại.
Nếu không có Regularization, mô hình có thể bắt đầu phụ thuộc quá nhiều vào một số neuron:
Neuron A ───────────→ Prediction
Neuron B ───────────→ Prediction
Neuron C ───────────→ Prediction
Nếu các neuron này học những Pattern quá đặc thù của Training Data, mô hình có thể bị Overfitting.
Dropout liên tục thay đổi cấu trúc mạng trong quá trình Training:
Training Step 1
→ A, B, D hoạt động

Training Step 2
→ A, C, E hoạt động

Training Step 3
→ B, C, D hoạt động

Training Step 4
→ A, D, E hoạt động
Do đó, mô hình phải học những Pattern có tính tổng quát hơn.
Dropout giống như huấn luyện nhiều Neural Network?
Có thể hình dung Dropout theo cách trực quan như sau.
Mỗi lần Training, một nhóm neuron khác nhau bị tắt.
Điều này tạo ra nhiều phiên bản khác nhau của mạng:
Network 1
   ↓
Network 2
   ↓
Network 3
   ↓
Network 4
   ↓
...
   ↓
Learned Model
Vì vậy, Dropout thường được giải thích trực quan như một cách gần giống với việc huấn luyện nhiều Sub-network khác nhau.
Tuy nhiên, đây là cách giải thích trực giác, không nên hiểu rằng framework thực sự huấn luyện hoàn toàn độc lập hàng nghìn Neural Network khác nhau.
Dropout hoạt động như thế nào trong Training?
Trong quá trình Training:
Input
  ↓
Dense Layer
  ↓
Dropout
  ↓
Dense Layer
  ↓
Output
Dropout sẽ tạo một Mask ngẫu nhiên.
Ví dụ:
Neuron Output:

[0.8, 0.4, 0.7, 0.2, 0.9]

Mask:

[1, 0, 1, 0, 1]

Sau Dropout:

[0.8, 0, 0.7, 0, 0.9]
Các neuron có Mask bằng 0 sẽ không truyền Activation sang Layer tiếp theo trong lần Training đó.
Dropout có được sử dụng khi Prediction không?
Thông thường là không.
Đây là điểm rất quan trọng.
Dropout được sử dụng trong:
Training
    ↓
Dropout ON
    ↓
Model học
Nhưng khi Prediction:
Inference
    ↓
Dropout OFF
    ↓
Toàn bộ neuron hoạt động
Nếu tiếp tục tắt neuron ngẫu nhiên khi Prediction, kết quả dự đoán sẽ không ổn định.
Vì vậy, các Deep Learning Framework thường tự động xử lý sự khác biệt giữa Training Mode và Evaluation/Inference Mode.
Ví dụ với Keras
Trong TensorFlow/Keras, Dropout có thể được thêm vào Neural Network rất đơn giản:
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Dropout

model = Sequential([
    Dense(128, activation="relu"),
    Dropout(0.3),
    Dense(64, activation="relu"),
    Dropout(0.2),
    Dense(1, activation="sigmoid")
])
Ở đây:
Dropout(0.3)có nghĩa là Layer Dropout sử dụng tỷ lệ 30%.
Layer tiếp theo:
Dropout(0.2)sử dụng tỷ lệ 20%.
Dropout đặt ở đâu trong Neural Network?
Dropout thường được đặt sau một Dense Layer hoặc ở những vị trí phù hợp trong kiến trúc mạng.
Ví dụ:
Input
  ↓
Dense
  ↓
ReLU
  ↓
Dropout
  ↓
Dense
  ↓
ReLU
  ↓
Dropout
  ↓
Output
Tuy nhiên, vị trí và tỷ lệ Dropout không có một công thức cố định cho mọi bài toán.
Đây là Hyperparameter cần được lựa chọn dựa trên Validation Performance.
Dropout và Overfitting
Giả sử mô hình ban đầu có:
Training Accuracy = 99%
Validation Accuracy = 78%
Khoảng cách rất lớn giữa Training và Validation Performance có thể là dấu hiệu của Overfitting.
Ta có thể thử thêm Regularization:
Dense
↓
Dropout
↓
Dense
↓
Dropout
↓
Output
Sau đó đánh giá lại trên Validation Set.
Nếu kết quả trở thành:
Training Accuracy = 94%
Validation Accuracy = 91%
thì mô hình có thể đã Generalize tốt hơn.
Điểm quan trọng không phải là làm Training Accuracy cao nhất.
Mục tiêu là xây dựng mô hình hoạt động tốt trên dữ liệu chưa từng nhìn thấy.
Dropout quá lớn có thể gây Underfitting
Giả sử chúng ta sử dụng:
Dropout Rate = 0.8Điều này có nghĩa là một tỷ lệ rất lớn neuron có thể bị tắt trong mỗi bước Training.
Mô hình có thể gặp khó khăn trong việc học Pattern:
Quá ít Regularization
        ↓
Overfitting

Regularization phù hợp
        ↓
Generalization tốt

Quá nhiều Regularization
        ↓
Underfitting
Vì vậy, Dropout là bài toán cân bằng.
Dropout và Batch Normalization khác nhau thế nào?
| Batch Normalization | Dropout |
|---|---|
| Chuẩn hóa Activation | Ngẫu nhiên tắt neuron |
| Giúp Training ổn định | Giúp giảm Overfitting |
| Ảnh hưởng đến phân phối Activation | Ảnh hưởng đến Network trong Training |
| Không đơn thuần là Regularization | Là kỹ thuật Regularization |
Hai kỹ thuật có thể được sử dụng cùng nhau, nhưng không nên mặc định rằng càng nhiều Layer Batch Normalization và Dropout thì mô hình càng tốt.
Có phải Neural Network nào cũng cần Dropout?
Không.
Dropout là một công cụ, không phải yêu cầu bắt buộc.
Một số mô hình có thể đã có đủ Regularization từ:
- Weight Decay.
- Data Augmentation.
- Early Stopping.
- Batch Normalization.
- Large Training Dataset.
- Kiến trúc mô hình phù hợp.
Trong những trường hợp này, thêm Dropout quá mạnh có thể khiến mô hình học kém hơn.
Dropout trong CNN
Trong Convolutional Neural Network, Dropout cũng có thể được sử dụng, đặc biệt ở những phần Fully Connected hoặc những vị trí phù hợp với kiến trúc.
Ví dụ:
Image
  ↓
Convolution
  ↓
ReLU
  ↓
Pooling
  ↓
Convolution
  ↓
ReLU
  ↓
Flatten
  ↓
Dense
  ↓
Dropout
  ↓
Output
Trong các CNN hiện đại, ngoài Dropout còn có nhiều kỹ thuật Regularization khác được sử dụng tùy kiến trúc.
Dropout trong Deep Learning hiện đại
Dropout vẫn là một kỹ thuật quan trọng và dễ hiểu, nhưng không phải lúc nào cũng là lựa chọn đầu tiên cho mọi kiến trúc hiện đại.
Tùy bài toán, Data Scientist có thể kết hợp:
- Dropout.
- Weight Decay.
- Early Stopping.
- Data Augmentation.
- Batch Normalization.
- Learning Rate Scheduling.
Điều quan trọng là đánh giá tác động của từng kỹ thuật trên Validation Set thay vì áp dụng tất cả cùng lúc.
Dropout cần nhớ điều gì?
Có thể tóm tắt Dropout bằng 5 ý chính:
- Dropout là Regularization Technique.
- Trong Training, một phần neuron được tắt ngẫu nhiên.
- Dropout giúp giảm sự phụ thuộc quá mức vào một nhóm neuron.
- Dropout thường được tắt khi Inference.
- Dropout quá mạnh có thể dẫn đến Underfitting.
Kết luận
Dropout là một trong những kỹ thuật cơ bản nhưng rất quan trọng khi học Deep Learning.
Nếu Batch Normalization giúp quá trình Training trở nên ổn định hơn, Dropout tập trung nhiều hơn vào việc kiểm soát Overfitting.
Ý tưởng cốt lõi của Dropout rất đơn giản:
Không cho mô hình phụ thuộc quá nhiều vào bất kỳ neuron nào.
Thay vì để Neural Network học thuộc Training Data, Dropout buộc mô hình phải tìm ra những Pattern có khả năng tổng quát tốt hơn.
Và đây cũng là một tư tưởng quan trọng của Machine Learning:
Một mô hình tốt không phải là mô hình nhớ dữ liệu tốt nhất, mà là mô hình dự đoán tốt trên dữ liệu chưa từng nhìn thấy.
Tài liệu tham khảo
Để tìm hiểu sâu hơn về Dropout, có thể tham khảo nghiên cứu gốc của Geoffrey Hinton và cộng sự về kỹ thuật này.
Dropout: A Simple Way to Prevent Neural Networks from Overfitting – JMLR
Học Machine Learning và Python tại MCNA Technology School
Nếu bạn muốn đi từ nền tảng Python đến Machine Learning và ứng dụng AI trên dữ liệu thực tế, có thể tham khảo các khóa học tại MCNA Technology School:
Tác giả: Bùi Đình Tuyển – Data Analyst tại MCNA Technology School
📞 Hotline: 0939.866.825 (Mr. Minh Khang)
🌐 Website: mcna.vn
📍 Hà Nội: 30 Trung Liệt, Đống Đa | Liền kề 44B TT2 Văn Quán, Hà Đông
📍 TP.HCM: 50B Phan Tây Hồ, Cầu Kiệu